guia de estudo · kubernetes avançado em 9 etapas + bônus
Kubernetes avançado
pela lente da F1.
Este guia continua o módulo de Kubernetes básico e ensina a operar um cluster em produção, em nove etapas e um bônus. Antes de começar, você precisa conhecer o que o módulo básico cobriu: Pods, Deployments, Services, ConfigMaps, probes, HPA e o kubectl com YAML declarativo, praticados no Minikube. Você começa pela saúde e pelos recursos de cada aplicação e pelo controle de em quais nós os Pods rodam; depois estuda as estratégias de atualização, o empacotamento com Helm, os deploys Blue/Green e canário, o autoscaling de nós com Karpenter e de aplicações com KEDA, e a segurança com identidade, RBAC e certificados automáticos. Na etapa bônus, leva o podinfo do módulo básico para um formato de produção, combinando Helm, ServiceAccount mínima, topology spread, PodDisruptionBudget, rollout ajustado e canário. Antes das etapas, a seção seguinte apresenta a lente de F1 do guia: uma comparação geral que mostra a mesma operação funcionando dentro de uma equipe de Fórmula 1.
Cada etapa só depende do que foi explicado antes dela e termina com um exercício pequeno que prova que você entendeu. Operar um cluster se aprende provocando falhas de propósito e observando a reação, então não pule os blocos "Mão na massa".
Como usar este guia: mantenha um terminal aberto ao lado do texto. Os comandos foram pensados para o Minikube (instalado no guia básico) e, a partir da Etapa 04, para o Helm. Quando um exemplo mostra a saída esperada, compare com a sua: nomes de pods, IPs, versões e tempos vão variar, e a estrutura da saída é o que importa. Saídas abreviadas estão marcadas com (...) e saídas que dependem de versão ou de ambiente aparecem como aproximadas. Organize os arquivos em uma pasta por etapa (etapa01/, etapa02/ e assim por diante), porque nomes como deployment.yaml se repetem, e execute o passo de limpeza no fim de cada etapa antes de seguir.
O que roda no Minikube e o que é só leitura: as Etapas 01, 02 (com um cluster de 2 nós), 03, 04, 05 e 06 rodam por completo no Minikube. Na Etapa 07 (Karpenter), o Karpenter em si exige a AWS e é só leitura; o que você executa localmente é a causa que o aciona, um Pod Pending por falta de capacidade. Na Etapa 08, o KEDA roda no Minikube (com um gatilho de fila Redis), e o exemplo com RabbitMQ é só leitura. Na Etapa 09, o RBAC e o cert-manager rodam localmente, e IRSA e Workload Identity são só leitura porque dependem de uma conta de nuvem. Istio e Argo Rollouts (Etapa 06) também são só leitura, e o canário é praticado com a técnica nativa por proporção de réplicas. A Etapa 10 roda no Minikube de ponta a ponta.
A lente de F1 deste guia
A operação fina da equipe de F1
O guia básico apresentou o cluster como uma equipe de Fórmula 1 num fim de semana de Grande Prêmio. Na mureta (o pit wall, a bancada voltada para a pista) ficam os engenheiros que decidem; nas garagens ficam os mecânicos que executam; os carros na pista fazem o trabalho; e cada carro é montado a partir de uma folha de especificação, a lista de peças e versões que define o carro. O regulamento limita cada equipe a dois carros por corrida, o carro 1 e o carro 2. Este guia olha para a mesma equipe num nível mais fino.
A saúde de cada carro chega à mureta pela telemetria, os sensores que transmitem continuamente o estado de cada sistema, e o engenheiro de corrida (quem acompanha um carro e fala com o piloto pelo rádio) faz três perguntas diferentes a esses dados. A primeira é se algum sistema travou: nesse caso, ele pede ao piloto um reset, que religa só aquele sistema, sem trocar o carro. A segunda é se o carro está apto para ir à pista agora: um carro com um problema em reparo fica na garagem, sem ser desmontado, e volta quando estiver pronto. A terceira vale só no começo do dia: a unidade de potência (o motor do carro, que junta o motor a combustão e a parte elétrica) é aquecida com fluidos quentes antes de ser ligada, e ninguém avalia o desempenho de um motor que ainda está aquecendo.
Os recursos funcionam com um piso e um teto, e os dois números falam da mesma grandeza. Tome a energia elétrica. O piso é a parte reservada para cada carro: cada garagem recebe do circuito uma quantidade fixa de energia, a equipe reserva uma fatia dela para o trabalho de cada carro e só coloca um carro numa garagem onde a fatia dele ainda cabe. O teto é o máximo de energia que o carro pode gastar. Em pista, o regulamento impõe esse teto à energia elétrica que a unidade de potência libera por volta: quando o carro chega a ele, a parte elétrica para de empurrar, o carro perde velocidade no fim da reta e continua andando. Esse efeito se chama clipping. O piso garante que a energia combinada esteja disponível; o teto impede que um carro gaste mais do que o permitido.
Quando falta espaço, energia ou gente na garagem, existe uma ordem de prioridade. O trabalho que garante o carro na próxima sessão (cada período de pista do fim de semana: treinos, classificação e corrida) fica. Entre os demais, o trabalho que tem reservado tudo o que usa é o último a ser cortado, e o trabalho opcional, sem nada reservado, é adiado primeiro.
Nem toda garagem serve para todo trabalho. Uma área com equipamento especial tem uma placa na porta que barra quem não tem autorização; ter a autorização permite entrar, mas não obriga ninguém a ir para lá, e quem precisa daquele equipamento pede a área pelo nome. A equipe distribui os carros entre as garagens em número equilibrado, para que um problema numa garagem (uma falha de energia, um incêndio) não deixe a equipe sem nenhum carro. Quando uma garagem precisa de manutenção, a equipe para de mandar trabalho para lá e retira com ordem o que estava nela, com uma regra fixa: nunca deixar a equipe com menos carros prontos do que o mínimo combinado. As peças novas chegam ao longo da temporada como atualizações, cada uma com sua versão registrada na folha de especificação. A equipe pode montar a atualização num carro de cada vez, mantendo sempre um carro pronto; pode trocar a versão dos dois carros de uma vez quando a mudança atinge algo que os dois compartilham (um software de controle novo que grava a telemetria num formato que o sistema de dados da mureta, o mesmo para os dois carros, não consegue ler ao lado do formato antigo), aceitando ficar um período sem carro pronto; e pode voltar à versão anterior, que continua registrada. Há duas formas mais cautelosas de estrear uma versão. Uma é montar um segundo chassi completo com a especificação nova, deixá-lo pronto ao lado do atual e passar para ele o número de corrida (o número pelo qual o carro é chamado no rádio e na cronometragem), com o chassi antigo intacto para voltar se for preciso. A outra é montar a peça nova só no carro 1, manter o carro 2 com a peça antiga e comparar a telemetria dos dois nas mesmas condições antes de levar a atualização para os dois carros.
O setup (o conjunto de ajustes de asa, suspensão e altura do carro) não é reescrito a cada evento. A equipe mantém um setup base com campos a preencher e uma folha de ajuste por tipo de circuito: menos asa para um circuito de retas longas, mais asa para um circuito de curvas lentas. O carro preparado para um fim de semana é o setup base preenchido com a folha daquele circuito, e cada mudança recebe um número de revisão. A estrutura e as pessoas também acompanham o volume de trabalho. A logística dimensiona a estrutura de garagem que vai para cada evento, no tamanho que o trabalho previsto pede, e deixa de levar a que ficaria ociosa. A equipe de apoio que produz peças na fábrica é acionada conforme a lista de pedidos que chega da pista: quanto mais pedidos, mais gente trabalhando, e sem pedidos ninguém fica de plantão. Por fim, o acesso é controlado por credenciais. Cada pessoa tem um passe que diz quem ela é e onde pode entrar: o paddock (a área de trabalho atrás das garagens, fechada ao público), a garagem, o pit lane (a via em frente às garagens, por onde os carros entram para parar). Cada função recebe só o acesso de que precisa, e o passe é emitido por quem organiza o evento, com validade definida. Para entrar numa área controlada por outra organização, a pessoa troca o passe da equipe por um passe temporário, de validade curta, emitido por essa organização. Quando os passes são substituídos, há um período em que o antigo e o novo valem juntos.
É a mesma operação que o Kubernetes faz no nível fino. As três perguntas do engenheiro de corrida são as probes: o reset de um sistema é a liveness, que reinicia o container; o carro que espera na garagem até ficar pronto é a readiness, que tira o Pod do Service sem reiniciá-lo; o aquecimento da unidade de potência é a startup. A fatia de energia reservada na garagem (o piso) é o request, o teto de energia com clipping é o limit de CPU com throttling, e a ordem de quem fica quando falta lugar são a classe de QoS e a PriorityClass. A placa na porta é o taint, a autorização é a toleration, pedir a área pelo nome é a node affinity, a distribuição equilibrada dos carros entre garagens é o topology spread, e a retirada ordenada de uma garagem em manutenção, sem descer do mínimo de carros prontos, é o drain respeitando o PodDisruptionBudget. Montar a atualização num carro de cada vez é o RollingUpdate, trocar a versão dos dois carros de uma vez é o Recreate, o segundo chassi pronto que recebe o número de corrida é o Blue/Green, e a peça nova só no carro 1 é o canário. O setup base é o chart do Helm, a folha de ajuste por circuito é o arquivo de values, e o carro preparado para o fim de semana, com suas revisões, é a release. A logística que dimensiona a estrutura de garagem é o Karpenter, e a equipe de apoio acionada pela lista de pedidos é o KEDA. O passe de cada função é a ServiceAccount, o acesso que ele dá é o RBAC, o passe temporário de outra organização é a credencial de nuvem de curta duração do IRSA e do Workload Identity, e a validade com renovação antes de vencer é o certificado gerenciado pelo cert-manager.
As regras do guia básico continuam valendo para o guia inteiro: cada chassi montado é um Pod, cada garagem é um nó e o número de corrida é o Service. Este guia acrescenta uma: cada versão registrada na folha de especificação é uma revisão. Montar uma atualização cria uma revisão nova, e voltar à versão anterior reaplica uma revisão que continua guardada, e essa volta também entra no histórico como uma revisão nova.
Os termos em palavras simples
41
O quadro abaixo traduz cada termo técnico do guia para uma ideia do dia a dia, sem F1 e sem jargão. Não precisa decorar; volte a ele quando um termo aparecer no texto.
| Termo técnico | Em palavras simples |
|---|---|
| Probe | Uma pergunta de rotina feita a cada poucos segundos ao programa para saber se ele está bem. |
| Liveness, readiness, startup | "Está travado?" (se sim, reinicia); "pode atender agora?" (se não, fica fora do atendimento, sem reiniciar); "já terminou de ligar?" (enquanto não, as outras perguntas esperam). |
| Requests e limits | A reserva garantida de recursos e o teto de uso. Passar do teto de memória faz o programa ser encerrado; passar do teto de processamento faz o programa ser desacelerado. |
| OOMKill | O sistema encerra à força um programa que passou do limite de memória. |
| Throttling de CPU | O sistema faz o programa esperar alguns instantes para que ele não ultrapasse a cota de processamento, mesmo que estivesse com pressa. |
| Classe de QoS | A ordem de quem é mantido quando falta recurso: quem reservou tudo o que usa sai por último, quem não reservou nada sai primeiro. |
| Disponibilidade | A fração do tempo em que o serviço atende. Ter cópias independentes reduz a chance de todas falharem ao mesmo tempo. |
| Taint | Um aviso colado na porta de um computador: "só entra quem tiver autorização". |
| Toleration | A autorização que o programa carrega para poder entrar onde há aviso. Ela permite a entrada, mas não obriga o programa a ir para lá. |
| Node affinity | O pedido "quero rodar só em computadores com esta etiqueta" (obrigatório) ou "prefiro" (opcional). |
| Pod affinity e anti-affinity | Regra de vizinhança: ficar perto de certos programas, ou longe deles. |
| Zona | Uma área física separada dentro da mesma região do provedor de nuvem, com energia e rede próprias: se uma zona falha, as outras seguem funcionando. |
| Topology spread | A regra de distribuir as cópias de forma equilibrada entre computadores ou zonas, com uma diferença máxima combinada. |
| Eviction | O computador que ficou sem memória ou espaço manda alguns programas embora para não parar de vez. |
| PriorityClass | Um número de importância que decide quem fica e quem sai quando falta lugar. |
| Disrupção voluntária e involuntária | Voluntária é a interrupção que alguém decide e agenda, como esvaziar um computador para manutenção. Involuntária é a que acontece sem pedido, como um computador sem memória ou uma máquina retomada pelo provedor. Só a voluntária respeita a regra de mínimo de cópias. |
| Cordon e drain | Cordon é pôr uma placa de "não receber mais ninguém". Drain é isso mais pedir, com ordem, que quem já está lá vá para outro lugar, para esvaziar o computador antes de uma manutenção. |
| PodDisruptionBudget (PDB) | Uma regra de segurança para manutenções planejadas: nunca deixar sair gente demais ao mesmo tempo, mantendo pelo menos N cópias atendendo. |
| RollingUpdate | Trocar a versão uma cópia de cada vez, sem fechar o atendimento. |
| maxSurge e maxUnavailable | Quantas cópias a mais podem existir durante a troca, e quantas podem ficar fora do ar durante a troca. |
| Recreate | Desligar todas as cópias antigas antes de ligar as novas: há uma pausa, mas as duas versões nunca atendem juntas. |
| Revisão e rollback | Cada versão guardada recebe um número, como as edições de um documento. Voltar atrás (rollback) é reaplicar uma edição antiga, e essa volta também entra na lista como uma edição nova. |
| Helm, chart e release | Helm é o instalador de aplicativos do cluster. O chart é o molde com campos a preencher. A release é uma instalação concreta desse molde, com nome e histórico de revisões. |
| values | A folha de preenchimento do molde (quantas cópias, qual versão), diferente para cada ambiente. |
| Blue/Green | Dois ambientes completos lado a lado: um atende, o outro espera pronto. Trocar é mudar a placa "atendimento por aqui". |
| Canário | Mostrar a versão nova só para uma pequena parcela dos usuários e observar antes de ampliar. |
| Service mesh | Uma camada de porteiros ao lado de cada programa, capaz de dividir o tráfego em porcentagens exatas e de medir tudo o que passa. |
| Argo Rollouts e Flagger | Ferramentas que automatizam entregas graduais, com checagem de métricas entre os passos. |
| Cluster Autoscaler e Karpenter | Quem aumenta e diminui o número de computadores do cluster. O primeiro trabalha com grupos predefinidos; o segundo providencia computadores sob medida na hora em que aparecem programas sem lugar. |
| NodePool | As regras do tipo de computador que o Karpenter pode contratar: tamanhos, regiões, preço, teto de gastos. |
| Spot | Computadores alugados com grande desconto, que o provedor pode pedir de volta com pouco aviso. |
| Consolidação | Reagrupar os programas em menos computadores e devolver os que sobraram. |
| Fila | Uma lista de tarefas esperando atendimento, na ordem de chegada. |
| KEDA e ScaledObject | O KEDA ajusta o número de cópias conforme o tamanho de uma fila ou outro evento. O ScaledObject é o formulário que diz o que observar e entre quais limites ajustar. |
| Scale-to-zero | Desligar todas as cópias quando não há trabalho e ligar uma assim que chegar o primeiro pedido. |
| ServiceAccount | O crachá de identidade de um programa dentro do cluster. |
| RBAC, Role e RoleBinding | RBAC é a tabela de quem pode fazer o quê. A Role é a lista de permissões; o RoleBinding liga essa lista a um crachá. Só existem regras que dão permissão; não há regra que proíba, e o que não foi dado está negado. |
| Menor privilégio | Dar a cada programa só as permissões de que ele precisa e mais nenhuma. |
| IRSA e Workload Identity | A troca do crachá do cluster por uma credencial temporária do provedor de nuvem, para que o programa não guarde senha própria. |
| cert-manager, Issuer e Certificate | Certificado é um documento digital que prova identidade e permite conexão criptografada. O Issuer é quem emite; o Certificate é o pedido do documento; o cert-manager pede, guarda e renova antes de vencer. |
| Rotação de segredos | Trocar senhas e chaves de tempos em tempos, mantendo as duas valendo por um período para ninguém ficar de fora. |
Onde a comparação para
10
A comparação ajuda a fixar quem faz o quê na operação fina, mas não é uma equivalência perfeita. Estes são os pontos em que a F1 deixa de valer para cada etapa:
- Etapa 01: o clipping corresponde bem ao throttling de CPU, mas o teto de memória não tem par na F1: passar dele não deixa o processo mais lento, encerra o container na hora (OOMKill). Na F1, o piso fica na garagem e o teto no carro; no cluster, request e limit são o piso e o teto do mesmo recurso, para o mesmo container, no mesmo nó. E o reset em pista depende do engenheiro de corrida e do piloto, enquanto o kubelet reinicia o container sozinho, em segundos.
- Etapa 02: a placa na porta, a ordem de prioridade e a distribuição dos carros entre garagens são decididas por pessoas, caso a caso; no Kubernetes, o scheduler aplica taints, affinity e topology spread como regras exatas a cada Pod, e o despejo por pressão de recursos é feito pelo kubelet de forma automática, ignorando o mínimo de carros prontos combinado (o PodDisruptionBudget).
- Etapa 03: montar uma atualização num carro leva horas, com o carro parado na garagem, e o regulamento fixa dois carros; o RollingUpdate troca Pods em segundos e pode criar cópias extras temporárias (maxSurge), algo que uma equipe limitada a dois carros não tem. Além disso, na F1 dois carros com especificações diferentes convivem sem problema, e a troca conjunta só se justifica quando a mudança atinge algo compartilhado, como o sistema de dados da mureta; no cluster, o Recreate é escolhido justamente porque as duas versões não podem atender ao mesmo tempo (por exemplo, por causa de um banco de dados que só uma delas entende), e o preço é o serviço fora do ar até as réplicas novas subirem.
- Etapa 04: o setup base e a folha de ajuste são documentos de engenharia interpretados por pessoas; o chart é um template que, com os mesmos values, gera sempre o mesmo YAML, e o Helm calcula sozinho a diferença em relação ao que está instalado.
- Etapa 05: passar o número de corrida para outro chassi só acontece entre sessões, com os carros parados; no Blue/Green, os dois ambientes ficam ligados e prontos ao mesmo tempo, a troca do selector vale em segundos para as novas conexões, e o principal risco (um banco de dados que as duas versões precisam ler) não tem par num carro.
- Etapa 06: com dois carros, o menor teste possível coloca a peça nova em metade da equipe, e os dois carros têm pilotos diferentes; o canário começa em uma fração pequena do tráfego, como 1% ou 5%, com requisições do mesmo tipo nas duas versões, e com service mesh o peso é exato, independente do número de réplicas.
- Etapa 07: num fim de semana, as garagens são definidas antes do evento e não mudam; o Karpenter cria e remove máquinas no meio da operação, em segundos ou minutos, pagas pelo tempo de uso, e as instâncias Spot (baratas, mas que o provedor pode retomar com aviso curto) não têm equivalente na logística da F1.
- Etapa 08: acionar a equipe de apoio leva horas e o número de pessoas tem limite; o KEDA liga uma réplica em segundos quando chega o primeiro evento, desliga todas quando a fila fica vazia pelo tempo configurado e não tem limite de pessoal, só o máximo de réplicas declarado.
- Etapa 09: o passe é um objeto físico conferido por pessoas na entrada; a ServiceAccount é um token verificado pelo API Server a cada pedido, o RBAC só soma permissões (não existe regra de proibição) e o certificado é renovado pelo cert-manager sem ninguém envolvido.
- Etapa 10: a comparação vale peça por peça, mas preparar o carro para um fim de semana envolve dezenas de pessoas e dias de trabalho; no cluster, a composição inteira cabe num chart instalado com um comando, e a promoção com
helm upgrade --atomicdesfaz a mudança sozinha se a release não ficar saudável no prazo.
Etapa 01 probes + requests/limits
Saúde da aplicação e gerenciamento de recursos
O problema
É Black Friday e a API de pedidos de um e-commerce entra em deadlock às 3h da manhã. O processo continua de pé, então para o Kubernetes está tudo Running, mas toda requisição recebe erro 500. Pelo lado dos recursos, o problema vem de outro Pod: um serviço de relatórios com vazamento de memória consome tudo o que encontra no nó e derruba os vizinhos, inclusive a API de pagamento.
São duas falhas diferentes com a mesma raiz: o cluster, sem informação extra, só sabe se o processo existe e não sabe quanto cada Pod pode usar. As ferramentas desta etapa dão essa informação ao Kubernetes: probes (sondas de saúde) e requests/limits (contrato de recursos).
O conceito
Probes. Você já viu as três no guia básico; aqui o foco é o comportamento sob falha.
- Liveness pergunta "o container travou?". Se falhar o número de vezes definido em
failureThreshold, o kubelet reinicia o container. Serve para travamentos irrecuperáveis (deadlock), não para lentidão passageira, senão o app entra em um ciclo de reinícios. Se o processo simplesmente morre, quem recria o container é orestartPolicydo Pod (o padrão éAlways), sem participação da liveness; a liveness cobre o caso em que o processo continua vivo, mas travado. - Readiness pergunta "pode receber requisições?". Se falhar, o Pod é removido dos endpoints do Service e não é reiniciado. Volta sozinho quando passa de novo. É o que garante um rollout sem erros para o usuário.
- Startup pergunta "terminou de subir?". Enquanto não passa, liveness e readiness ficam suspensas. Protege apps de boot lento, que de outra forma seriam mortos antes de ficarem prontos.
Requests e limits. Todo container pode declarar dois valores por recurso:
- requests é o que o container *reserva*. O scheduler usa esse valor para decidir em qual nó o Pod cabe. É o piso garantido.
- limits é o teto que ele não pode ultrapassar. Passar do limite de memória faz o kernel encerrar o container (OOMKill). Passar do limite de CPU não mata nada: o kernel desacelera o processo (throttling) para mantê-lo dentro da cota.
CPU é medida em milicores (100m é 0,1 CPU) e memória em bytes com sufixos binários (128Mi).
Classe de QoS. Da combinação de requests e limits nasce a classe de QoS do Pod, que pesa na decisão de quem sai primeiro sob pressão:
- Guaranteed: todos os containers têm requests iguais a limits, tanto para CPU quanto para memória.
- Burstable: pelo menos um container declara request ou limit, mas o Pod não se enquadra em Guaranteed. Usa folga ociosa e cede sob contenção.
- BestEffort: nenhum container declara requests nem limits. É o primeiro a ser sacrificado.
Um ponto contraintuitivo: limite de CPU pode piorar a latência. O kernel Linux aplica o limite por cotas em períodos de 100 ms (CFS quota). Um serviço com vários threads pode gastar a cota inteira do período em um pico curto e ficar parado até o próximo período, mesmo com uso médio baixo. A Buffer relatou publicamente que removeu os limits de CPU de serviços sensíveis a latência e viu o p99 (a latência abaixo da qual ficam 99% das requisições) cair de forma expressiva (o relatório de origem fala em 5 a 10 vezes). A lição prática: em um cluster compartilhado por vários times, limits dão isolamento; em um serviço sensível a latência, vale considerar manter o request e retirar o limit de CPU, mantendo o limit de memória.
Disponibilidade e sinais. A disponibilidade de um serviço é A = MTBF / (MTBF + MTTR): o tempo médio entre falhas dividido por ele somado ao tempo médio de recuperação. Com réplicas independentes, as probabilidades de falha se multiplicam: se cada Pod fica fora do ar 1% do tempo, a chance de dois Pods estarem fora ao mesmo tempo é 0,01 × 0,01 = 0,0001, ou seja, 0,01%, e o conjunto chega a cerca de 99,99% de disponibilidade, desde que as falhas sejam independentes. O Service funciona como um "OU lógico", porque basta um Pod Ready. Para saber se o serviço está saudável de verdade, o Google SRE propõe os quatro *golden signals*: latência, tráfego, erros e saturação. Probes cobrem erro e parte da saturação; para o resto, usa-se Prometheus e Grafana.

Os conceitos-chave
Liveness difere de readiness
liveness reinicia o container; readiness só tira o Pod do tráfego. Confundir as duas causa reinícios em cascata.
Liveness e restartPolicy
se o processo morre, o restartPolicy recria o container; a liveness cobre o processo vivo e travado.
Startup probe
dá tempo ao app para subir antes de as outras probes valerem.
requests e limits
requests é a reserva usada no agendamento; limits é o teto (OOMKill na memória, throttling na CPU). Sempre defina requests.
QoS
Guaranteed, Burstable e BestEffort; a classe influencia a ordem de despejo sob pressão.
CPU throttling
o limite de CPU pode adicionar latência mesmo com uso médio baixo, por causa da cota do CFS.
Disponibilidade
A = MTBF / (MTBF + MTTR); as probabilidades de falha de réplicas independentes se multiplicam, e a disponibilidade do conjunto cresce.
Golden signals
latência, tráfego, erros e saturação.
Exemplos comentados
Para que o exemplo seja executável, usamos o podinfo do guia básico, que expõe /healthz e /readyz na porta 9898. Para conferir se a tag existe no registry, rode docker manifest inspect stefanprodan/podinfo:6.14.1: se o comando imprimir um JSON, a tag existe; se responder no such manifest, escolha outra tag publicada.
# deploy-saude.yamlapiVersion: apps/v1kind: Deploymentmetadata:name: apispec:replicas: 3 # três cópias, como no guia básicoselector:matchLabels:app: apitemplate:metadata:labels:app: api # precisa casar com o selectorspec:containers:- name: apiimage: stefanprodan/podinfo:6.14.1 # versão fixa; confirme a tag com o comando acimaports:- containerPort: 9898startupProbe: # protege o boot lentohttpGet:path: /healthzport: 9898failureThreshold: 30 # até 30 tentativasperiodSeconds: 10 # a cada 10s: até 5min para subirlivenessProbe: # travou? reinicia o containerhttpGet:path: /healthzport: 9898periodSeconds: 10failureThreshold: 3 # 3 falhas seguidas antes de reiniciarreadinessProbe: # pronto? entra no ServicehttpGet:path: /readyzport: 9898periodSeconds: 5resources:requests: # reserva usada pelo schedulercpu: 100mmemory: 64Milimits:memory: 128Mi # teto de memória; sem limit de CPU, para evitar throttling---apiVersion: v1kind: Servicemetadata:name: apispec:selector:app: api # acha os Pods pelo labelports:- port: 80targetPort: 9898
Este Pod é Burstable: tem requests e um limit de memória, mas não declara limit de CPU, então requests e limits não são iguais em todos os recursos.
Comandos essenciais desta etapa
Liveness probe failed e OOMKilled)Mão na massa
- Aplique
deploy-saude.yamle confirme 3 PodsRunningcomkubectl get pods -l app=api. Rode o comando deqosClasse observeBurstable. - Anote os nomes de dois Pods da lista (
<pod-1>e<pod-2>). Desligue a readiness do primeiro comkubectl exec <pod-1> -- curl -s -X POST localhost:9898/readyz/disable. ObserveREADY 0/1comRESTARTS 0e um endpoint a menos emkubectl get endpoints api. - Derrube o processo do segundo Pod com
kubectl exec <pod-2> -- curl -s localhost:9898/panice acompanhe comkubectl get pods -w. ObserveRESTARTSsubir para<pod-2>. Quem reiniciou foi orestartPolicy: o processo morreu e o kubelet recriou o container, sem participação da liveness. Se o primeiro/panicnão derrubar o processo, repita. - Aplique
liveness-falha.yamle acompanhe comkubectl get pod liveness-falha -w. ObserveRESTARTSsubir depois de 30 a 40 segundos, embora o processo continue vivo, e confirme emkubectl describe pod liveness-falhao parLiveness probe failedeKilling. Essa é a liveness agindo sobre um app vivo e travado. - Aplique
pods-qos.yamle confirme as três classes com ocustom-columns. Observe que a classe é calculada pelo Kubernetes a partir dos requests e limits, sem você declará-la. - Aplique
pod-oom.yamle observe o statusOOMKilled(confirme comdescribe pode procureReason: OOMKilled). - Limpe:
kubectl delete -f deploy-saude.yaml -f pods-qos.yaml -f pod-oom.yaml -f liveness-falha.yaml.
Dica: Não coloque verificação de banco de dados na liveness probe. Se o banco cair, todas as réplicas falham a liveness ao mesmo tempo, reiniciam juntas e você transforma uma indisponibilidade de dependência em uma falha em cascata. Verifique dependências na startup (para não subir sem elas) e degrade graciosamente depois; se a dependência faltar, a readiness é o lugar certo para refletir isso.
Anota aí: Liveness reinicia, readiness só tira do tráfego, e requests e limits dizem ao cluster quanto cada Pod reserva e até onde pode ir.
Etapa 02 taints + affinity + spread
Agendamento avançado e comportamento de nós
O problema
Por padrão, o scheduler coloca o Pod em qualquer nó em que ele caiba. Isso quebra em três cenários reais. Um job de treinamento de machine learning precisa de GPU, e os nós com GPU são caros demais para receberem qualquer Pod. As três réplicas do banco de dados acabam todas no mesmo nó, e um defeito de hardware derruba o serviço inteiro. E quando um nó fica sem disco por causa de logs, o cluster precisa decidir quem sai, sem que um Pod crítico seja sacrificado por acaso. Esta etapa é sobre controlar *onde* os Pods rodam e *como* o cluster se protege.
O conceito
Taints e tolerations: repelir. O *taint* é uma marca colocada no nó, que diz "não agende Pods aqui, a menos que eles tolerem esta marca". A *toleration* é a declaração no Pod: "eu aceito essa marca, posso ir". Um taint tem chave, valor e efeito:
NoSchedule: não agenda Pods que não toleram; os que já rodam ali continuam.PreferNoSchedule: evita, mas não é absoluto.NoExecute: além de barrar novos, expulsa os Pods que não toleram e já estavam no nó (útil para esvaziar um nó).
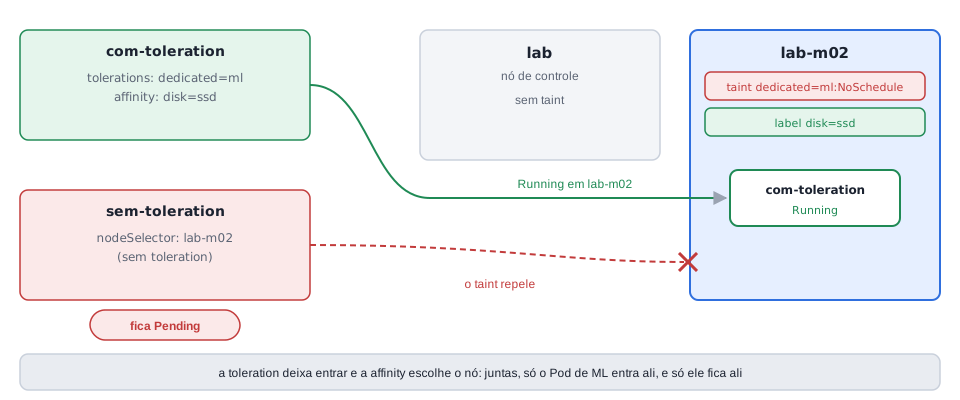
Ponto crucial: o taint só repele, não atrai. Um Pod que tolera o taint do nó de GPU pode ir para o nó de GPU ou para um nó comum. Para garantir que ele vá *apenas* para a GPU, combine com node affinity.
Node affinity: atrair. É a contraparte positiva: "quero ir para nós com este label". Existem dois modos, escritos nos campos requiredDuringSchedulingIgnoredDuringExecution (obrigatório: sem o label, o Pod fica Pending) e preferredDuringSchedulingIgnoredDuringExecution (preferência, com peso: se não houver, agenda em outro lugar). O trecho IgnoredDuringExecution indica que a regra vale só no agendamento; se o label do nó mudar depois, o Pod não é movido.
Pod affinity e anti-affinity: relacionar Pods entre si. Em vez de olhar labels do nó, olham os Pods que já estão lá. *Affinity* aproxima (cache perto do frontend, na mesma zona); *anti-affinity* separa (não colocar duas réplicas do banco no mesmo nó). A zona é uma área física separada dentro da mesma região do provedor de nuvem, com energia e rede próprias. A documentação do Kubernetes não recomenda usar regras inter-pod em clusters de várias centenas de nós, porque o cálculo é caro para o scheduler.
Topology Spread Constraints: espalhar com garantia numérica. É a alternativa preferida para distribuir réplicas. Você declara um topologyKey (o critério de agrupamento, por exemplo kubernetes.io/hostname para nós ou topology.kubernetes.io/zone para zonas), um maxSkew (a diferença máxima permitida de quantidade de Pods entre dois grupos) e whenUnsatisfiable: DoNotSchedule (rígido, o Pod fica Pending se violar) ou ScheduleAnyway (preferência). Com 4 réplicas, 2 nós e maxSkew: 1, a única distribuição aceita é 2 e 2; 3 e 1 é rejeitada, porque a diferença seria 2.
Eviction sob pressão: a autoproteção do nó. Quando o nó fica sem memória, disco ou PIDs, o kubelet age antes do colapso. Primeiro tenta liberar espaço (containers mortos, imagens não usadas). Se não bastar, começa a despejar Pods. A ordem segue a documentação: primeiro os Pods cujo uso do recurso em falta excede o request, depois a prioridade (PriorityClass), depois o tamanho do uso em relação ao request. Na prática, BestEffort e Burstable que passaram de seus requests saem antes, e Guaranteed e Pods de alta prioridade saem por último. Detalhes que importam:
- O despejo por pressão de recursos ignora o PodDisruptionBudget, porque é uma emergência.
- O parâmetro de kubelet
eviction-minimum-reclaimfaz o kubelet liberar uma margem além do limite, para evitar um efeito dominó de despejos repetidos. - Eviction não é OOMKill. O OOMKill é o kernel encerrando *um container* que passou do limit de memória; o eviction é o kubelet retirando *Pods* para salvar o *nó*.
Manutenção planejada: cordon, drain e PodDisruptionBudget. Quando você precisa esvaziar um nó de propósito (atualização, troca de máquina), usa kubectl cordon (marca o nó como não agendável) e kubectl drain (cordon, mais evicção ordenada dos Pods). Esse tipo de interrupção, decidida e agendada por alguém, é chamado de disrupção voluntária; a interrupção que acontece sem pedido (um nó sem memória, uma máquina retomada pelo provedor) é involuntária. O PodDisruptionBudget (PDB) define quantos Pods de uma aplicação podem ficar indisponíveis durante uma disrupção voluntária, em minAvailable (mínimo que precisa seguir de pé) ou maxUnavailable (máximo que pode sair). O drain respeita o PDB: se retirar um Pod violaria o orçamento, a evicção é recusada e repetida até ser possível. Já o despejo por pressão de recursos, descrito acima, é involuntário e não respeita o PDB.
PriorityClass e a natureza do scheduler. A PriorityClass atribui prioridade numérica a Pods. Pods de sistema (system-cluster-critical e system-node-critical) têm prioridade altíssima e quase nunca são despejados. Alocar Pods em nós com múltiplas restrições é um problema de bin packing, NP-difícil; o scheduler usa uma heurística gulosa em duas fases (filtra os nós que servem, pontua os que sobraram, escolhe o melhor), rápida mas não necessariamente ótima.
Os conceitos-chave
Taint repele, affinity atrai
para isolamento forte (nó de GPU só para ML), combine os dois.
Efeitos de taint
NoSchedule, PreferNoSchedule e NoExecute (este expulsa).
required e preferred
a affinity pode ser obrigatória (hard) ou uma preferência com peso (soft).
Anti-affinity e Topology Spread
ambos espalham réplicas; o Topology Spread usa maxSkew e escala melhor.
Ordem de despejo
uso acima do request, depois prioridade, depois uso relativo ao request.
Disrupção voluntária e involuntária
a primeira é decidida por alguém (drain, upgrade de nó) e respeita o PDB; a segunda acontece sem pedido e não respeita.
PodDisruptionBudget
limita disrupções voluntárias; não protege contra despejo por pressão.
PriorityClass
pods de sistema têm prioridade quase máxima.
Scheduler guloso
filtra, pontua e escolhe; é rápido, mas não garante a melhor distribuição possível.
Exemplos comentados
Este exemplo exige um nó com GPU e o plugin de dispositivo da NVIDIA instalado, então não roda no Minikube. A versão executável vem em seguida.
# pod-gpu.yaml# Passo prévio, feito uma vez por quem administra o cluster:# kubectl taint nodes gpu-node-1 nvidia.com/gpu=true:NoSchedule# kubectl label nodes gpu-node-1 accelerator=nvidia-gpuapiVersion: v1kind: Podmetadata:name: treino-mlspec:tolerations: # aceita o taint do nó de GPU- key: "nvidia.com/gpu"operator: "Equal"value: "true"effect: "NoSchedule"affinity:nodeAffinity: # E exige ir para um nó com GPUrequiredDuringSchedulingIgnoredDuringExecution:nodeSelectorTerms:- matchExpressions:- key: "accelerator"operator: Invalues: ["nvidia-gpu"]containers:- name: treinoimage: myregistry/treino:1.0 # imagem fictíciaresources:limits:nvidia.com/gpu: 1 # pede uma GPU ao plugin de dispositivo
A toleration sozinha deixaria o Pod livre para cair em um nó comum. A affinity sozinha não impediria Pods comuns de ocuparem o nó de GPU. Juntas, só o Pod de ML entra ali, e só ele fica ali.
Comandos essenciais desta etapa
- ao final do efeito para remover)MemoryPressure, DiskPressure, PIDPressure)Mão na massa
- Se o perfil padrão do Minikube estiver ligado, rode
minikube stop. Suba o cluster de 2 nós (minikube start -p lab --nodes 2), aplique o taint e o label emlab-m02e aplique os dois Pods do exemplo. Observesem-tolerationemPendinge a mensagemuntolerated taintnodescribe; observecom-tolerationemRunningnolab-m02. - Remova o taint (
kubectl taint nodes lab-m02 dedicated=ml:NoSchedule-), apague os dois Pods e apliqueweb-spread.yamlepdb-web.yaml. Observe com-o wideos 4 Pods divididos em 2 e 2 e, emkubectl get pdb web, o valor1emALLOWED DISRUPTIONS. - Apague o
webe opdb-webcomkubectl delete -f web-spread.yaml -f pdb-web.yaml, apliquepdb-drain.yaml, rode odraindolab-m02e observe a recusaCannot evict pod as it would violate the pod's disruption budget. Interrompa com Ctrl+C e rodekubectl uncordon lab-m02. - Rode
kubectl describe node labe observe a seçãoConditions:MemoryPressure,DiskPressureePIDPressureemFalsesão o estado saudável. O despejo por pressão (que ignora o PDB) só acontece quando uma delas viraTrue; ele não é reproduzido aqui porque exigiria esgotar o nó. - Limpe:
minikube delete -p lab. Essa remoção apaga também o contextolabdokubectl, então volte ao cluster padrão comminikube start(se você parou o perfil padrão no passo 1) ou comkubectl config use-context minikube, e confirme comkubectl get nodesantes de seguir para a Etapa 03.
Dica: Monitore o uso de disco e de memória dos nós e alerte antes de chegar ao limite de despejo do kubelet. Por padrão, o kubelet inicia o despejo forçado de Pods quando o espaço livre do sistema de arquivos do nó cai abaixo de 10% (disco cerca de 90% cheio) ou a memória disponível cai abaixo de 100Mi, valores configuráveis. Um alerta em torno de 80% a 85% de uso de disco, somado a rotação de logs, evita um despejo em cadeia. Entre reagir drenando o nó manualmente e deixar o kubelet despejar em emergência, prefira sempre a primeira opção.
Anota aí: Taint repele, affinity atrai, topology spread distribui com números, e o PodDisruptionBudget protege as manutenções planejadas, mas não o despejo por pressão de recursos.
Etapa 03 estratégias de atualização
Estratégias de atualização e rollouts
O problema
A versão 2.0 do checkout precisa ir ao ar na sexta, às 18h, durante uma campanha. Dois riscos aparecem: derrubar o serviço durante a troca e misturar duas versões que não são compatíveis entre si (por exemplo, quando a 2.0 depende de uma migração de banco que quebra a 1.0). O Deployment resolve os dois casos, com duas estratégias nativas, e dá ferramentas para detectar quando a troca emperrou.
O conceito
RollingUpdate (o padrão) substitui os Pods aos poucos, mantendo o serviço no ar. O Deployment cria um novo ReplicaSet com a versão nova e reduz o antigo na medida em que os novos ficam prontos. Dois parâmetros controlam o ritmo da troca:
- maxUnavailable: o piso de capacidade, isto é, quantos Pods podem ficar indisponíveis durante a troca. Padrão: 25%.
- maxSurge: a folga extra, isto é, quantos Pods a *mais* que o desejado podem existir temporariamente. Padrão: 25%.
Com N réplicas e os valores padrão, durante o rollout existem no mínimo cerca de 75% de Pods disponíveis e no máximo cerca de 125% de Pods em execução. O Kubernetes arredonda maxSurge para cima e maxUnavailable para baixo; com 10 réplicas, o padrão resulta em 3 de surge e 2 de unavailable, ou seja, no mínimo 8 disponíveis e no máximo 13 em execução. Os dois parâmetros não podem ser zero ao mesmo tempo, porque a troca não teria como progredir.
Recreate derruba *todos* os Pods da versão antiga antes de subir os da nova. Há downtime, mas as duas versões nunca coexistem. É a escolha quando a v1 e a v2 são incompatíveis.
O ajuste é um compromisso. Um maxUnavailable alto permite trocar mais Pods ao mesmo tempo, o que acelera a troca, mas reduz a capacidade que atende os usuários durante ela, e a fila de requisições cresce. Em teoria de filas, λ é a taxa de chegada de requisições, μ é quanto cada Pod atende por segundo e c é o número de Pods; a utilização ρ = λ/(cμ) é a fração da capacidade em uso. Com menos Pods (c menor), ρ sobe, e a latência cresce muito rápido quando ρ se aproxima de 1. Um maxSurge alto também acelera, mas dobra o número de Pods e de conexões, e isso pode saturar o banco de dados. Duas receitas úteis:
- Disponibilidade primeiro:
maxUnavailable: 0(nunca reduz a capacidade) emaxSurgedentro do orçamento de recursos do cluster. - Menor tempo sob orçamento: escolher
maxSurgeemaxUnavailableo mais altos possível, de modo que o pico de Pods ((1 + surge) × N) caiba no orçamento de recursos e o piso ((1 - unavailable) × N) não degrade o serviço além do aceitável.
Ferramentas de garantia:
minReadySeconds(padrão 0): quantos segundos um Pod precisa permanecerReadyantes de contar como disponível. Evita seguir adiante com um Pod que cai logo depois de subir.progressDeadlineSeconds(padrão 600): se o rollout não progride nesse tempo, o Deployment recebe a condiçãoProgressDeadlineExceeded. O Deployment não faz rollback sozinho; quem faz é você (ou uma ferramenta).revisionHistoryLimit(padrão 10): quantas revisões antigas (ReplicaSets) guardar para rollback.
O rollout só é disparado por mudanças em .spec.template. Mudar o número de réplicas ou uma annotation do próprio Deployment não conta.
Estratégias mais sofisticadas. Blue/Green e canário (próximas etapas) não são nativos do objeto Deployment. Controladores como Argo Rollouts e Flagger os implementam, com passos de promoção e análise automática de métricas.
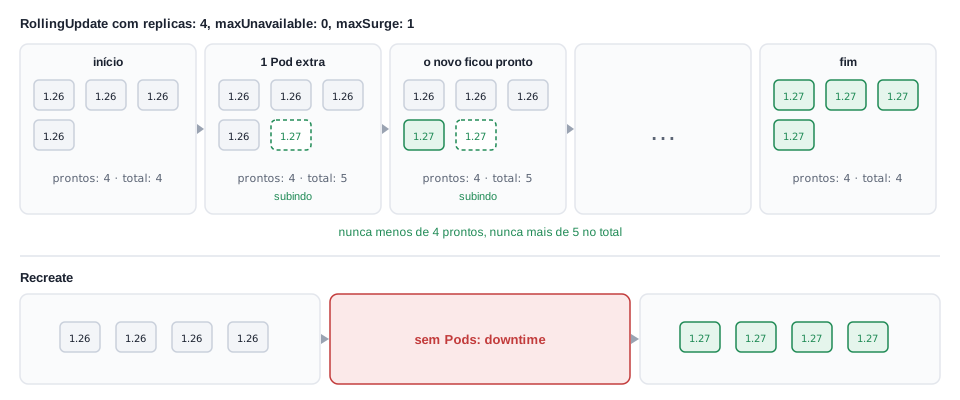
maxUnavailable: 0 e maxSurge: 1, a troca nunca baixa de 4 Pods prontos e nunca passa de 5 no total. O Recreate evita que as versões coexistam, ao custo de um intervalo sem nenhum Pod.Diagrama: feito para este guiaOs conceitos-chave
RollingUpdate e Recreate
zero downtime versus consistência total ao custo de uma pausa.
maxSurge e maxUnavailable
maxUnavailable define o piso de capacidade (quantos Pods podem sair) e maxSurge é a folga extra (quantos Pods a mais podem existir); padrões de 25% cada, com arredondamento para cima no surge e para baixo no unavailable.
Os dois zerados
não é permitido.
minReadySeconds
evita contar como pronto um Pod que ainda pode cair.
progressDeadlineSeconds
detecta rollout travado, sem fazer rollback automático.
Gatilho do rollout
só mudanças em .spec.template.
Argo Rollouts e Flagger
adicionam canário e blue/green com análise automática de métricas.
RollingUpdate com disponibilidade em primeiro lugar
# myapp.yamlapiVersion: apps/v1kind: Deploymentmetadata:name: myappannotations:kubernetes.io/change-cause: "nginx 1.26" # aparece no rollout historyspec:replicas: 4minReadySeconds: 10 # o Pod precisa ficar 10s Ready para contar como disponívelprogressDeadlineSeconds: 600 # padrão: 10 minutos para o rollout progredirrevisionHistoryLimit: 10 # padrão: guarda 10 revisões para rollbackstrategy:type: RollingUpdaterollingUpdate:maxUnavailable: 0 # nunca reduz a capacidademaxSurge: 1 # cria 1 Pod extra por vezselector:matchLabels:app: myapptemplate:metadata:labels:app: myappspec:containers:- name: appimage: nginx:1.26readinessProbe: # sem readiness, o Pod conta como pronto assim que sobehttpGet:path: /port: 80
Comandos essenciais desta etapa
change-cause--to-revision=N para uma revisão específica)kubectl rollout resume deployment/myapp retomaMão na massa
- Aplique
myapp.yamle confirme 4 PodsRunning. Em um segundo terminal, rodekubectl get pods -w. - Rode
kubectl set image deployment/myapp app=nginx:1.27. Observe no segundo terminal que sempre existem 4 Pods prontos e que no máximo 1 Pod extra aparece: é omaxUnavailable: 0commaxSurge: 1em ação. - Registre a mudança com
kubectl annotatee confirme emkubectl rollout history deployment/myappque a revisão 2 mostranginx 1.27. - Reduza o prazo com o
patchdeprogressDeadlineSeconds: 30, troque a imagem paranginx:nao-existee rodekubectl rollout status deployment/myapp. Observe a mensagemexceeded its progress deadlinee confirme o código de saída comecho $?. - Observe com
kubectl get podsque os Pods antigos continuamRunning: o serviço nunca caiu. Volte comkubectl rollout undo deployment/myapp. - Limpe:
kubectl delete -f myapp.yaml.
Dica: Sempre preencha a annotation kubernetes.io/change-cause. Sem ela, o rollout history mostra <none> e, na hora de um incidente às 3h da manhã, você não sabe para qual revisão voltar. A flag --record, que fazia isso automaticamente, está obsoleta; prefira kubectl annotate ou o próprio manifesto.
Anota aí: RollingUpdate troca sem derrubar, maxSurge dá folga para criar Pods extras e maxUnavailable define o piso de capacidade, e o Deployment só avisa que o rollout travou, quem desfaz é você.
Etapa 04 pacotes + values
Gerenciador de pacotes com Helm Charts
O problema
Uma aplicação real tem Deployment, Service, ConfigMap, HPA e mais alguns objetos, e existe em pelo menos três ambientes: dev, staging e produção. Os manifestos dos três ambientes são quase idênticos (talvez 95% dos campos), e mudam só réplicas, imagem e recursos. Manter três cópias dos mesmos arquivos faz com que alguém corrija um bug em um ambiente e esqueça os outros, e deixa difícil saber o que está de fato instalado em produção e como voltar atrás. O Helm resolve isso: empacota os manifestos em charts parametrizados, versionados e reutilizáveis.
O conceito
O Helm funciona como o gerenciador de pacotes do Kubernetes (comparável ao apt ou ao yum). Um chart tem uma estrutura simples:
- `Chart.yaml`: metadados do pacote.
versioné a versão do *chart*;appVersioné a versão da *aplicação* empacotada. Ambas seguem SemVer, e separá-las permite evoluir o chart sem trocar o app e vice-versa. - `values.yaml`: os valores padrão configuráveis (réplicas, imagem, porta, recursos). Tudo o que varia por ambiente fica aqui; cada ambiente usa o seu arquivo de values, com
-f. - `templates/`: os manifestos escritos como templates da linguagem Go, com funções Sprig.
{{ .Values.replicaCount }}insere um valor; arquivos como_helpers.tplconcentram trechos reutilizáveis (nomes e labels).
Um template Helm se comporta como uma função: dados os mesmos values, produz o mesmo YAML, e você confere o resultado antes de aplicar com helm template. Isso dá previsibilidade e permite testar. Funções como lookup, now e randAlphaNum quebram essa regra (leem o cluster ou geram valores diferentes a cada execução), então use-as com consciência.
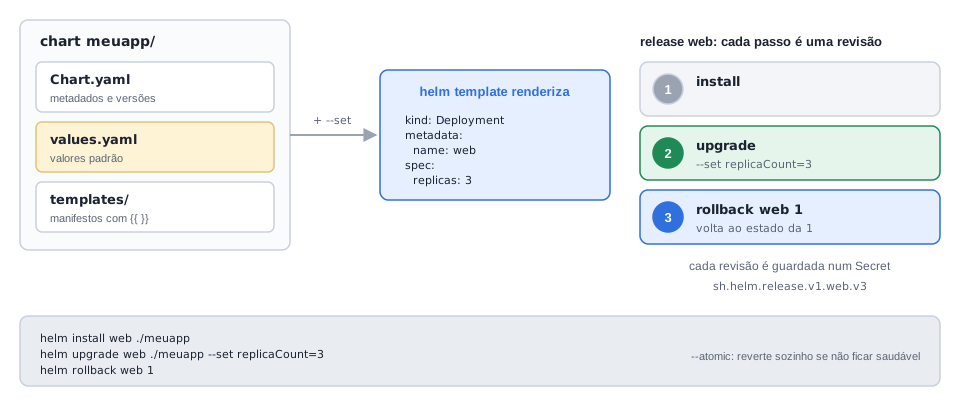
Ciclo de vida de uma release. Cada instalação de um chart é uma release, com nome e histórico:
helm installcria a release e registra o estado como um Secret no namespace (sh.helm.release.v1.<nome>.v<revisão>).helm upgraderenderiza os templates de novo, calcula as diferenças em relação ao que está instalado, aplica só o que mudou e cria uma nova revisão. Rodarhelm upgradesem mudar nada não altera os recursos do cluster, mas o Helm registra uma nova revisão mesmo assim.helm rollback <release> <revisão>volta ao estado de uma revisão anterior, e o rollback também gera uma revisão nova. As revisões antigas não são alteradas, e é isso que torna o rollback confiável.
O Helm 3 não tem servidor central (o antigo Tiller foi removido). O cliente usa as credenciais do seu kubeconfig, então o RBAC do usuário limita o que o Helm consegue fazer.
Governança em escala. Charts seguem SemVer (uma mudança de versão maior indica quebra e pede revisão humana), são distribuídos por repositórios (Artifact Hub, repositórios privados) e podem ser assinados (GPG, com um arquivo .prov), o que protege a cadeia de suprimentos. Um chart deve embutir RBAC de menor privilégio (ServiceAccounts dedicadas, Roles limitadas). Subcharts permitem composição (um chart "guarda-chuva" que junta o app e o banco), e values.schema.json valida os values como um esquema de tipos. Em fluxos de GitOps (Argo CD, Flux), o chart fica no Git, a sincronização é automática e cada release vira um commit auditável.
Os conceitos-chave
Chart, values, templates
pacote reutilizável, parâmetros e manifestos parametrizados.
version e appVersion
versão do chart e versão do app; ambas SemVer.
Template
dado o mesmo values, gera o mesmo YAML; confira com helm template.
Release e revisão
cada install, upgrade e rollback gera uma revisão; o histórico fica em Secrets.
Helm 3 e o RBAC
sem Tiller; o Helm só faz o que o usuário pode fazer.
--atomic
reverte o upgrade automaticamente se a release não ficar saudável no prazo.
Governança
SemVer, repositórios, assinatura (.prov), RBAC mínimo e values.schema.json.
Um chart mínimo, do zero
Instale o Helm (helm.sh/docs/intro/install) e confirme com helm version. Crie a pasta meuapp/ com três arquivos.
# Chart.yamlapiVersion: v2 # versão do formato de chart do Helm 3name: meuappdescription: Chart de estudotype: applicationversion: 0.1.0 # versão do chartappVersion: "1.26" # versão da aplicação empacotada (informativa)
Comandos essenciais desta etapa
Mão na massa
- Crie a pasta
meuapp/com os três arquivos, rodehelm lint ./meuappehelm template web ./meuapp --set replicaCount=3. Observereplicas: 3no YAML renderizado: o values foi sobrescrito sem tocar no arquivo. - Rode
helm install web ./meuappekubectl get secret -l owner=helm. Observe o Secret que guarda a revisão 1. - Rode
helm upgrade web ./meuapp --set replicaCount=3, depoishelm rollback web 1ehelm history web. Observe que o rollback criou uma revisão nova (a 3) em vez de apagar a 2. - Rode o upgrade com
--set image.tag=nao-existe --atomic --timeout 30s. Observe o erroUPGRADE FAILED ... rolled backe quekubectl get deploy webcontinua com os Pods antigos saudáveis. - Limpe:
helm uninstall web.
Dica: Rode helm diff upgrade (plugin helm-diff, instalado com helm plugin install https://github.com/databus23/helm-diff) antes de aplicar em produção. Ver o que vai mudar no cluster evita a insegurança de aplicar um template "às cegas", uma queixa comum de quem começa com Helm.
Anota aí: O Helm transforma manifestos repetidos em um chart com values por ambiente, registra cada mudança como uma revisão e permite voltar atrás com um comando.
Etapa 05 troca de ambiente inteiro
Deploy Blue/Green
O problema
O rolling update da Etapa 03 mistura versões durante a troca: por alguns minutos, parte dos usuários vê a v1 e parte vê a v2. Para uma mudança grande no checkout, isso é inaceitável, e voltar atrás em caso de erro leva tempo, porque o cluster precisa trocar os Pods de novo. Seria melhor ter a versão nova já pronta, testada, esperando, e trocar tudo de uma vez, com a possibilidade de voltar em segundos. Essa é a ideia do Blue/Green.
O conceito
Você mantém dois ambientes de produção idênticos. O Blue é a versão atual, servindo 100% do tráfego. O Green é a versão nova, com todos os Pods prontos, mas sem tráfego. Quando o Green é validado, você troca o tráfego para ele. Se der problema, troca de volta.
No Kubernetes, os dois conjuntos de Pods são dois Deployments, com labels diferentes (env: blue e env: green, além do app comum). Um Service aponta para um deles por meio do selector. A promoção é um patch no selector do Service: o controlador de endpoints recalcula a lista de Pods do Service e o kube-proxy reconfigura o roteamento. O rollback é o patch inverso. Como os Pods antigos continuam de pé (apenas sem tráfego), a volta não exige reimplantar nada. Uma observação prática: a troca vale para as novas conexões; conexões já abertas (por exemplo, keep-alive de HTTP) podem continuar nos Pods antigos até serem encerradas.
Formalmente, é uma transição de um estado para outro com uma única operação, e o rollback é a mesma operação no sentido contrário. Se a v2 falha, o dano se limita ao tempo até a detecção: reverter na hora reduz esse tempo ao mínimo.
Armadilhas:
- Compatibilidade de dados e esquema. É o maior desafio prático. Se a Green altera o banco de forma incompatível, voltar para a Blue quebra. A solução é fazer a mudança em duas fases (padrão conhecido como expand/contract): primeiro migrar o banco para suportar as *duas* versões, validar, e só então trocar o código. Sem isso, dados escritos pela Green podem inutilizar a Blue.
- Custo. Dois ambientes completos significam cerca de 100% de capacidade extra durante a transição. Boa prática: reduzir o ambiente inativo a zero réplicas depois que a nova versão estabilizar.
- Tempestade de conexões e cache frio. Trocar 100% do tráfego de uma vez joga toda a carga sobre a Green de repente, e caches frios podem gerar um pico. Uma mitigação é aquecer a Green com tráfego sombra antes.
Antipadrão clássico: deixar de tratar a Green como produção o tempo todo. Se você acumula mudanças esperando o "momento certo" para trocar, o salto entre as versões fica grande e arriscado. Blue/Green de verdade é fazer deploy contínuo no ambiente inativo e virar a chave quando houver confiança.
Ferramentas. O Argo Rollouts suporta blueGreen de forma nativa (com serviço de preview e promoção manual ou automática por métricas); o Flagger se integra com service mesh. O padrão também é chamado de Red/Black em contextos como Netflix e Spinnaker.
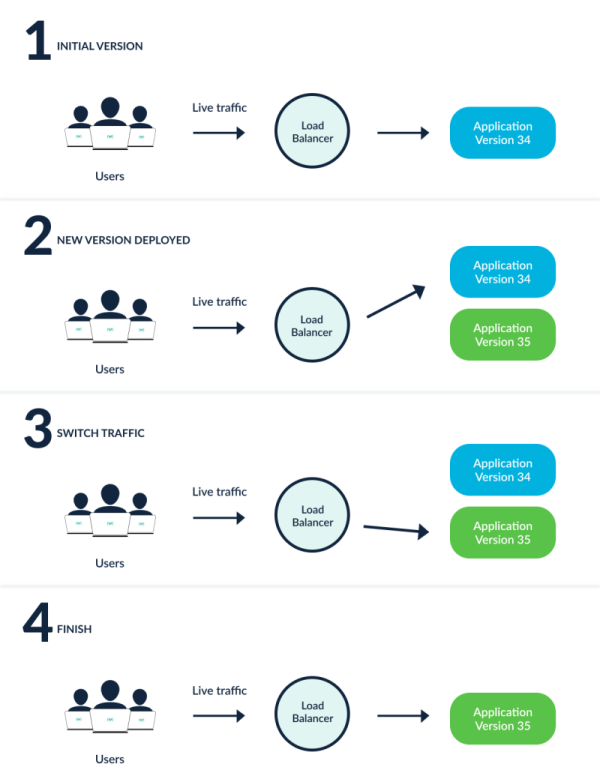
Os conceitos-chave
Dois ambientes idênticos
só um serve tráfego por vez.
A troca é um patch no selector do Service
o roteamento muda em segundos para novas conexões.
Rollback rápido
os Pods antigos continuam prontos; basta o patch inverso.
Compatibilidade de esquema
migre o banco de forma retrocompatível antes de trocar o código.
Custo
cerca de 100% de capacidade extra na transição; reduza o ambiente inativo depois.
Green é produção contínua
senão o salto vira um big bang arriscado.
Tudo ou nada
se quiser progressivo, é canário (próxima etapa).
Um Service que aponta para blue e depois para green
Usamos a imagem hashicorp/http-echo, que responde com o texto passado em -text, para ver qual versão atende.
# bluegreen.yamlapiVersion: apps/v1kind: Deploymentmetadata:name: myapp-bluespec:replicas: 2selector:matchLabels:app: myappenv: bluetemplate:metadata:labels:app: myappenv: blue # identifica o ambientespec:containers:- name: appimage: hashicorp/http-echo:1.0args: ["-text=blue v1"] # responde com este texto, na porta 5678ports:- containerPort: 5678---apiVersion: apps/v1kind: Deploymentmetadata:name: myapp-greenspec:replicas: 2selector:matchLabels:app: myappenv: greentemplate:metadata:labels:app: myappenv: greenspec:containers:- name: appimage: hashicorp/http-echo:1.0args: ["-text=green v2"]ports:- containerPort: 5678---apiVersion: v1kind: Servicemetadata:name: myapp-servicespec:selector:app: myappenv: blue # a chave: troque para green na promoçãoports:- port: 80targetPort: 5678
Comandos essenciais desta etapa
selectorMão na massa
- Aplique
bluegreen.yaml, rodekubectl get endpoints myapp-servicee owgetpelo Podcliente. Observeblue v1e apenas os 2 IPs dos Pods blue. - Faça a promoção com o
kubectl patchdo exemplo e consulte de novo. Observegreen v2e os 2 IPs dos Pods green emget endpoints, sem que nenhum Pod tenha sido criado ou removido. - Faça o rollback com o patch inverso e observe
blue v1de volta, porque os Pods blue continuaram existindo. - Escale
myapp-bluepara 0, rodekubectl get endpoints myapp-servicee observe que, com o selector em blue, o Service ficou sem endpoints (<none>). É por isso que o desligamento do ambiente antigo só deve ser feito depois de promover e estabilizar o novo. - Limpe:
kubectl delete -f bluegreen.yaml.
Dica: Antes de virar a chave, confirme que o banco aceita as duas versões. A pergunta é sempre esta: "se eu precisar voltar para a Blue daqui a 5 minutos, os dados que a Green escreveu vão quebrar a Blue?". Se a resposta for sim, o cutover ainda não está pronto.
Anota aí: Blue/Green mantém duas versões prontas e troca o tráfego com um patch no selector do Service, e a reversão só é segura se o banco aceita as duas versões.
Etapa 06 tráfego progressivo
Deploy canário
O problema
O Blue/Green troca 100% do tráfego de uma vez. Se a v2 tem um defeito que só aparece com tráfego real (um erro raro, uma consulta lenta com dados de produção), todos os usuários o sentem ao mesmo tempo, mesmo que você consiga voltar em segundos. Seria melhor expor a v2 a uma fração pequena de usuários, medir o resultado e só ampliar se estiver tudo bem. É o deploy canário.
O conceito
No canário, você mantém as duas versões rodando e transfere o tráfego aos poucos (por exemplo, 1%, 5%, 25%, 50% e 100%), validando métricas reais a cada passo. Se algo degrada, o impacto ficou restrito aos poucos por cento e você reverte. Em contraste, Blue/Green é "tudo ou nada"; o canário é progressivo.
Duas formas de dividir o tráfego:
- Por proporção de réplicas, de forma nativa. Dois Deployments com um label em comum (por exemplo
app: myapp), e um Service que seleciona só por esse label. O Service distribui as requisições entre todos os Pods, então 4 Pods estáveis e 1 canário resultam em cerca de 20% do tráfego no canário. É simples, não exige nada além do Kubernetes, mas a granularidade depende do número de réplicas (para 1% você precisaria de 100 Pods). - Por peso, com service mesh ou ingress com suporte a peso. Com Istio ou Linkerd, ou com um ingress controller compatível, você define percentuais exatos (por exemplo 90% e 10%), independentes do número de réplicas. No Istio, um
VirtualServicedivide o tráfego entre *subsets* (v1 e v2), que são declarados em umDestinationRulea partir de labels dos Pods.
Decisão guiada por métricas. O que decide promover ou reverter são métricas em tempo real: taxa de erro (5xx), latência (p95 e p99, as latências abaixo das quais ficam 95% e 99% das requisições), uso de recursos, métricas de negócio. Isso fecha um laço de realimentação que pode ser automatizado: se o erro do canário fica abaixo do limite, aumenta o peso; se viola, volta para a v1.
Ferramentas. O Argo Rollouts e o Flagger implementam os passos (pesos, pausas, análises) como objetos do Kubernetes. No Argo Rollouts, o objeto Rollout substitui o Deployment e declara a estratégia em steps. Sem um roteador de tráfego configurado (trafficRouting), o setWeight é aproximado por meio do número de réplicas, igual à técnica nativa; com Istio ou um ingress compatível, o peso é exato.
Vocabulário de teoria, para saber que existe:
- Teste A/B contínuo: o canário é um experimento estatístico entre a v1 (controle) e a v2. A hipótese nula é "não há diferença"; avalia-se com testes de significância (teste z de proporções, qui-quadrado, Mann-Whitney). O Kayenta, usado com o Spinnaker na Netflix, faz análise de canário com o teste de Mann-Whitney.
- Testes sequenciais (SPRT de Wald): avaliam continuamente e param cedo quando há evidência suficiente para promover ou abortar, reduzindo a exposição dos usuários.
- Teoria de filas: mesmo 10% do tráfego pode degradar a latência se esses 10% quase saturam os poucos Pods da v2. O tempo de espera cresce muito rápido perto da saturação, o que também serve para estimar se a v2 aguenta 100%.
- Multi-armed bandits (Thompson Sampling): alocam tráfego de forma adaptativa, equilibrando testar e favorecer a melhor versão.
Casos relatados. O material de origem cita a Shopify (cerca de 5% do tráfego por alguns minutos, com análise automática antes de ir a 100%), a Netflix (canary analysis automatizada com Kayenta no Spinnaker) e o Nubank (feature flags combinadas com canário). Os números exatos vêm do relato original e não foram verificados aqui. A tendência é guiar o canário por SLOs (frear se a meta de erro for violada).
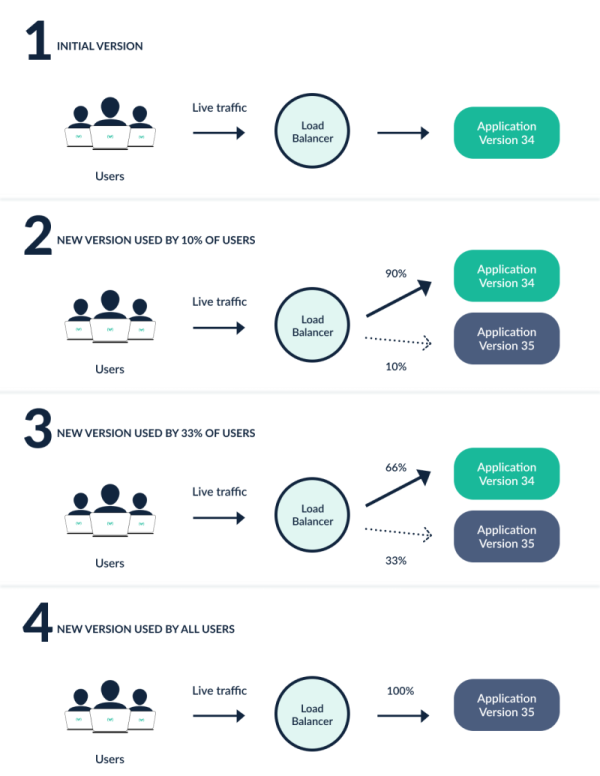
Os conceitos-chave
Canário
rollout progressivo com validação por métricas a cada passo.
Blue/Green versus canário
tudo de uma vez versus gradual e observável.
Proporção de réplicas
técnica nativa, granularidade limitada pelo número de Pods.
Roteamento por peso
via service mesh ou ingress; independe do número de réplicas.
Decisão por dados
erro, p95, p99 e SLOs; promoção ou reversão podem ser automáticas.
Canary analysis
teste estatístico entre baseline e canário (Kayenta); funciona como um portão automático.
Argo Rollouts e Flagger
implementam passos e análise como objetos do cluster.
Exemplos comentados
# canario.yamlapiVersion: apps/v1kind: Deploymentmetadata:name: myapp-stablespec:replicas: 4 # 4 de 5 Pods: cerca de 80% do tráfegoselector:matchLabels:app: myapptrack: stabletemplate:metadata:labels:app: myapp # label comum, usado pelo Servicetrack: stable # label que distingue a versãospec:containers:- name: appimage: hashicorp/http-echo:1.0args: ["-text=v1 estavel"]ports:- containerPort: 5678---apiVersion: apps/v1kind: Deploymentmetadata:name: myapp-canaryspec:replicas: 1 # 1 de 5 Pods: cerca de 20% do tráfegoselector:matchLabels:app: myapptrack: canarytemplate:metadata:labels:app: myapptrack: canaryspec:containers:- name: appimage: hashicorp/http-echo:1.0args: ["-text=v2 canario"]ports:- containerPort: 5678---apiVersion: v1kind: Servicemetadata:name: myappspec:selector:app: myapp # sem o label "track": o Service enxerga os dois Deploymentsports:- port: 80targetPort: 5678
Comandos essenciais desta etapa
kubectl argo rollouts abort myapp abortaMão na massa
- Aplique
canario.yamle rodekubectl get endpoints myapp. Observe os 5 endpoints (4 estáveis e 1 canário). - Rode o laço de 20 requisições com o Pod
cliente. Observe a contagem aproximada de 80% parav1 estavele 20% parav2 canario. Rode de novo e observe que os números mudam: a divisão é estatística, não exata. - Aborte o canário com
kubectl scale deployment myapp-canary --replicas=0e repita o laço. Observe que sóv1 estavelresponde. - Reflita sobre o limite da técnica: para um canário de 1%, quantas réplicas seriam necessárias? Esse é o motivo de existirem service mesh e Argo Rollouts com roteamento por peso.
- Limpe:
kubectl delete -f canario.yaml.
Dica: Amarre o canário aos seus SLOs, não a métricas arbitrárias. Se o SLO de erro é 0,1%, o canário deve parar automaticamente quando a v2 violar esse limite. Assim, o monitoramento de produção e o monitoramento de deploy viram a mesma coisa, e a decisão de promover deixa de ser subjetiva.
Anota aí: O canário expõe a versão nova a uma fração do tráfego e só avança com métricas boas; sem service mesh a fração depende do número de réplicas, e com ele o peso é exato.
Etapa 07 escala de nós
Escalabilidade de nós com Karpenter
O problema
As etapas anteriores escalam Pods. Mas na Black Friday, quando o HPA pede 30 réplicas a mais, o cluster inteiro já está cheio: os Pods novos ficam Pending, porque não há nó com CPU e memória livres. É preciso aumentar o número de nós. O Cluster Autoscaler tradicional faz isso, mas trabalha com grupos de nós fixos (por exemplo, Auto Scaling Groups da AWS), pré-configurados por tipo de instância e por zona, o que é trabalhoso de manter e lento para reagir. Um Pod pequeno pode acionar um nó grande, e o nó fica ocioso.
O conceito
O Karpenter (criado pela AWS, open source, com providers para outras nuvens) provisiona nós sob demanda, dimensionados para os Pods que estão pendentes, sem grupos fixos. Reage em segundos a poucos minutos, escolhe o tipo de instância mais adequado (incluindo Spot) e remove nós ociosos sozinho. Empresas relatam economias de até 30% em custo de computação, valor que depende do ambiente.
O fluxo de provisionamento:
- Pods ficam unschedulable: o scheduler não encontrou nó (
Pending, com o eventoFailedScheduling). - O Karpenter observa esses Pods e soma as requisições de recursos deles.
- Calcula que tipo de instância acomoda melhor o conjunto, dentro das regras do NodePool.
- Provisiona o nó (via um
NodeClaim), e os Pods são agendados nele.
O fluxo inverso, a consolidação: o Karpenter identifica nós subutilizados, move os Pods para outros nós e remove o nó que sobrou, ou troca uma instância cara por uma mais barata. A consolidação espera um tempo configurável (consolidateAfter) antes de agir, para não reagir a oscilações curtas.
Configuração em dois objetos:
- NodePool: define as regras dos nós que o Karpenter pode lançar (tipos de instância permitidos, zonas, Spot ou On-Demand, limites de recursos). Versões antigas chamavam esse objeto de Provisioner. A recomendação é restringir o mínimo possível, para dar liberdade de otimização.
- EC2NodeClass (na AWS): define o que é específico do provedor (AMI, sub-redes, security groups, IAM role dos nós). O NodePool aponta para ele por
nodeClassRef.
O problema de fundo é bin packing multidimensional (cada Pod é um item com um vetor de CPU e memória, e cada nó é um recipiente), que é NP-difícil. O Karpenter usa heurística gulosa: descarta tipos que não servem (sem GPU quando o Pod pede GPU, zona errada), ordena por custo e adequação e busca uma solução com pouca sobra, parecida com First-Fit Decreasing. A diferença-chave para o Cluster Autoscaler é o right-sizing: nó pequeno para Pod pequeno, nó grande quando chegam Pods grandes, misturando tipos conforme a necessidade.
Custos e Spot. Instâncias Spot custam bem menos que On-Demand (a ordem de 70% a 90% de desconto, conforme o tipo e o momento), mas o provedor pode retirá-las com aviso curto (2 minutos na AWS). O Karpenter lida com isso com interrupção proativa: detecta o aviso, marca o nó como terminando, aplica taint e drena os Pods para outro nó antes do corte. Duas precisões importantes:
- Para disrupções voluntárias (consolidação, drift, expiração), o Karpenter respeita os PodDisruptionBudgets e não derruba Pods além do que o orçamento permite.
- A interrupção Spot é involuntária: o provedor vai retirar a máquina de qualquer forma, e o prazo de 2 minutos pode não bastar para drenar tudo. Por isso, o PDB reduz o risco, mas não o elimina.
Boas práticas: PDB para limitar quantos Pods saem juntos, Topology Spread para distribuir réplicas entre nós e zonas, e NodePools separados para cargas críticas (On-Demand) e cargas tolerantes a interrupção (Spot).
Casos relatados. O material de origem cita o Mercado Livre (uso do Karpenter para misturar tipos de instância e usar Spot e capacidade reservada, eliminando dezenas de grupos de nós) e a Tinybird (corte de cerca de 20% da conta AWS, 90% no ambiente de CI, ao consolidar tudo em dois NodePools: um crítico On-Demand e outro stateless 100% Spot). Os números vêm do relato original.
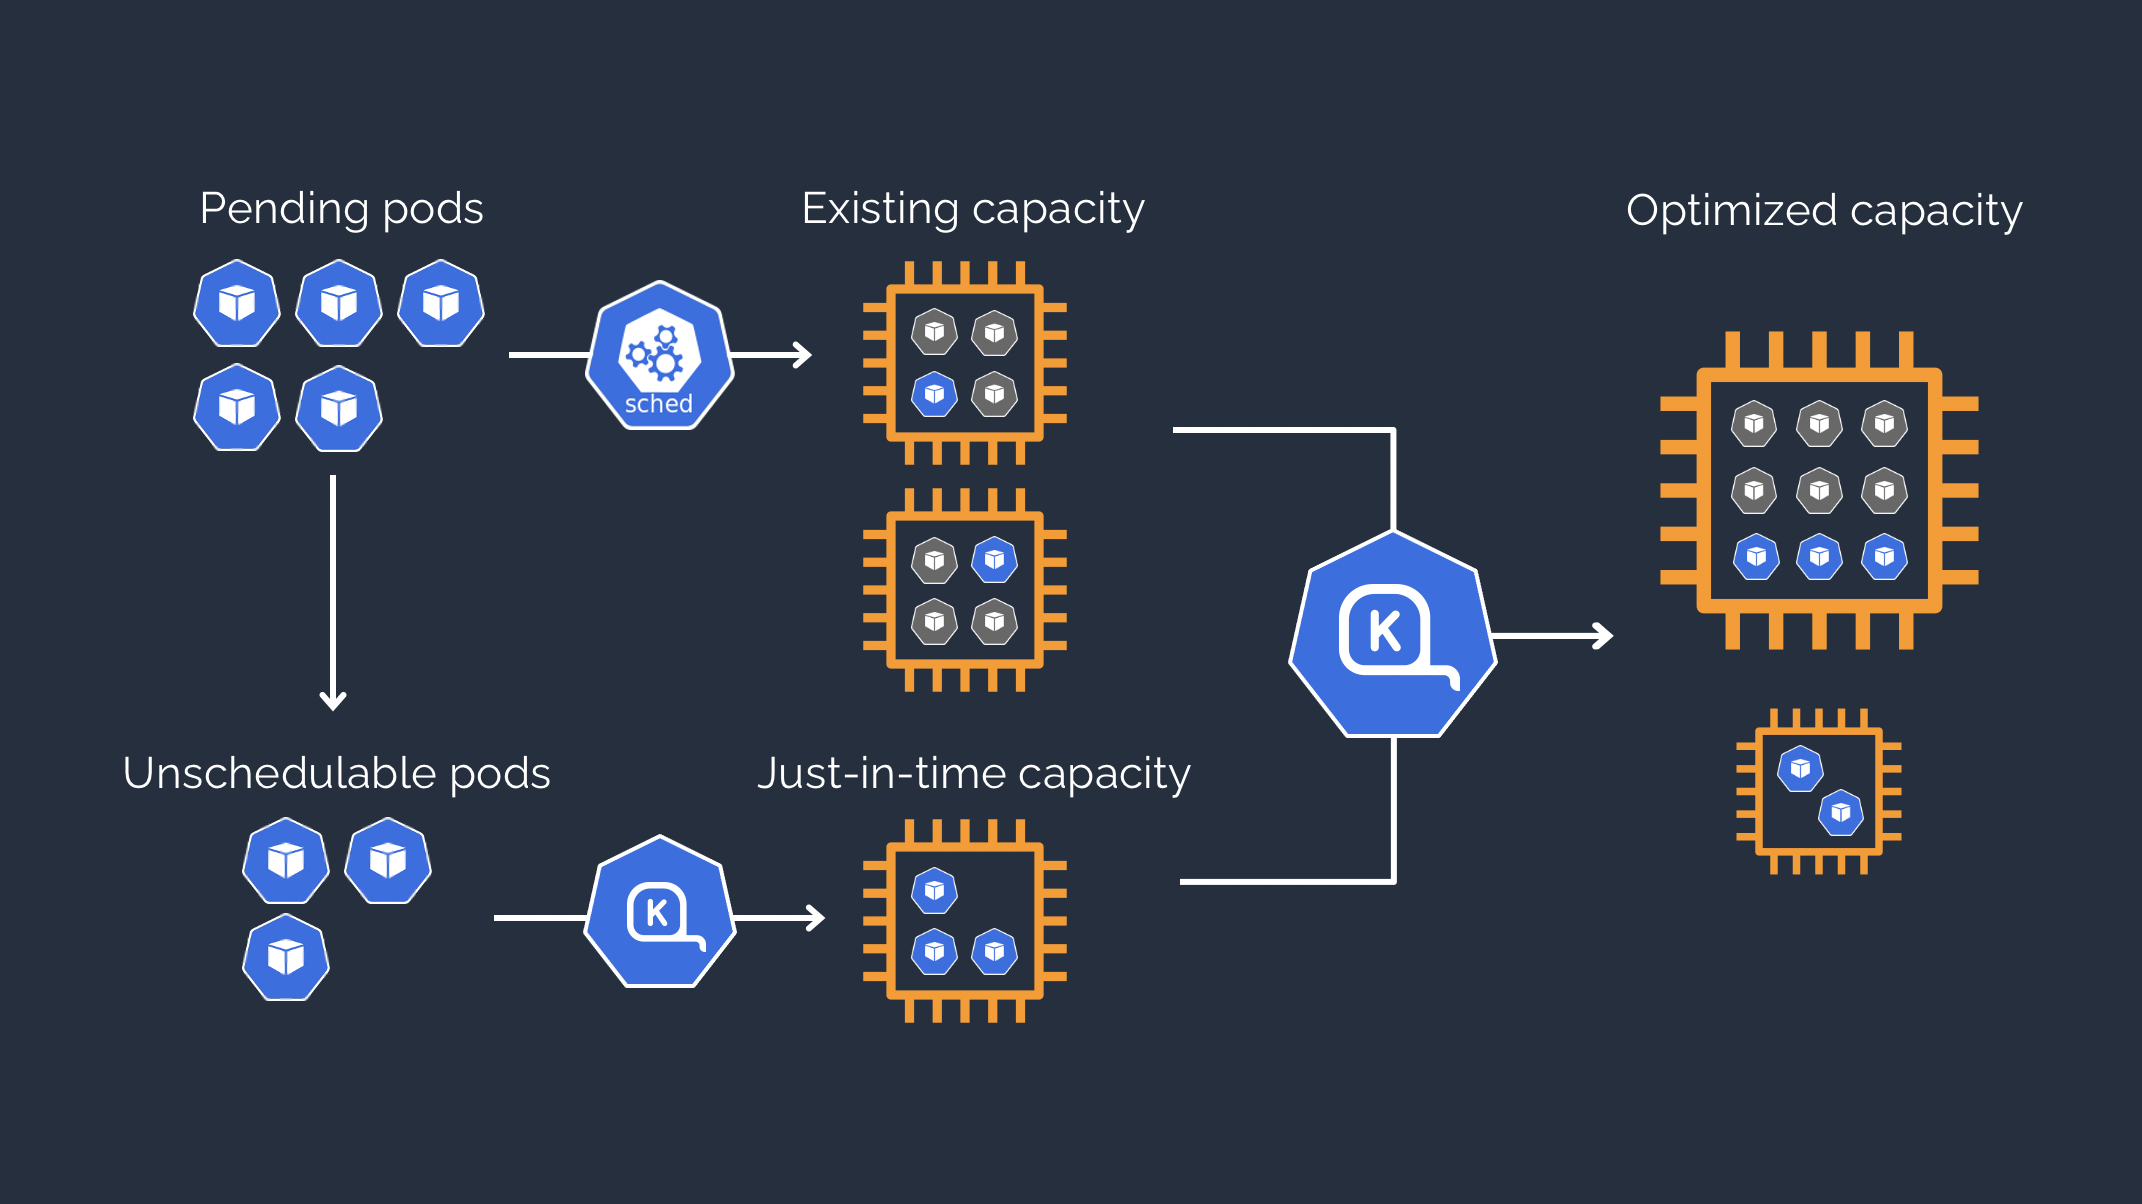
Pending com FailedScheduling, o mesmo que você provoca no laboratório. Ele cria o nó do tamanho necessário e, mais tarde, consolida nós ociosos ou subutilizados.Diagrama: karpenter.sh, projeto Karpenter, Apache 2.0Os conceitos-chave
Karpenter
autoscaling de nós sob demanda, dimensionado para os Pods pendentes, sem grupos fixos.
Cluster Autoscaler versus Karpenter
grupos fixos e mais lento, contra flexível, rápido e com right-sizing.
NodePool e EC2NodeClass
regras dos nós (tipos, zonas, Spot, limites) e detalhes do provedor; restrinja o mínimo.
Bin packing NP-difícil
o Karpenter usa heurística gulosa de menor desperdício.
Consolidação
remove ou troca nós ociosos, com uma espera configurável (consolidateAfter).
Spot
bem mais barato; interrupção proativa com drain; respeita o PDB em disrupções voluntárias, mas a interrupção Spot é involuntária.
Isolar cargas
NodePools distintos para carga crítica (On-Demand) e tolerante (Spot).
Exemplos comentados
Exige um cluster EKS com o Karpenter instalado. Os nomes do cluster, da role e das tags são marcadores; o exemplo serve para leitura.
# nodepool.yamlapiVersion: karpenter.sh/v1kind: NodePoolmetadata:name: defaultspec:template:spec:requirements:- key: karpenter.sh/capacity-typeoperator: Invalues: ["spot", "on-demand"] # permite os dois; o Karpenter prioriza Spot quando é possível- key: kubernetes.io/archoperator: Invalues: ["amd64"]nodeClassRef: # em v1 o nodeClassRef precisa de group, kind e namegroup: karpenter.k8s.awskind: EC2NodeClassname: defaultlimits:cpu: "1000" # teto de CPU somada dos nós deste NodePoolmemory: 1000Gidisruption:consolidationPolicy: WhenEmptyOrUnderutilized # consolida nós vazios ou subutilizadosconsolidateAfter: 30s # espera 30s antes de agir---apiVersion: karpenter.k8s.aws/v1kind: EC2NodeClassmetadata:name: defaultspec:role: "KarpenterNodeRole-meu-cluster" # IAM role dos nós (marcador)amiSelectorTerms:- alias: al2023@latest # AMI Amazon Linux 2023subnetSelectorTerms:- tags:karpenter.sh/discovery: meu-cluster # descobre as sub-redes por tagsecurityGroupSelectorTerms:- tags:karpenter.sh/discovery: meu-cluster
Comandos essenciais desta etapa
Mão na massa
- Aplique
pod-grande.yamlno Minikube e rodekubectl get pods. Observe o Pod emPending. - Rode
kubectl describe pod -l app=grandee observe em Events a mensagemFailedSchedulingcomInsufficient cpu. Esse é o sinal que o Karpenter usa para decidir criar um nó. - Rode
kubectl get nodes -L karpenter.sh/capacity-typee observe a coluna vazia: nenhum nó foi provisionado pelo Karpenter, o que confirma que ele não está instalado. - Leia o NodePool do exemplo e responda: o que acontece se
limits.cpufor atingido? (Resposta: o Karpenter não cria novos nós nesse NodePool e os Pods seguemPending.) - Limpe:
kubectl delete -f pod-grande.yaml.
Dica: Rode cargas stateless e tolerantes a interrupção em Spot, e reserve On-Demand para o que é crítico ou stateful, em NodePools separados. Combine com PodDisruptionBudget e Topology Spread, para que uma interrupção de Spot nunca derrube réplicas demais do mesmo serviço ao mesmo tempo.
Anota aí: O Karpenter cria nós sob medida quando há Pods sem lugar e remove os ociosos, e Spot só é seguro com PDB e topology spread, porque a interrupção Spot é involuntária e pode chegar antes de o drain terminar.
Etapa 08 escala por eventos
Escalabilidade de aplicações com KEDA
O problema
O HPA padrão escala por CPU e memória. Mas considere um e-commerce com workers que processam pedidos de uma fila: quando 5 mil pedidos entram na fila durante uma promoção relâmpago, os workers talvez nem estejam usando muita CPU (estão esperando I/O), então o HPA não reage, e a fila cresce. Na madrugada, a fila está vazia e ainda assim há workers ligados, gastando recursos. Falta um jeito de escalar pelo tamanho da fila, e até zero quando não há trabalho.
O conceito
O KEDA (Kubernetes Event-driven Autoscaler) escala com base em eventos externos: filas (RabbitMQ, SQS, Kafka, Redis), métricas do Prometheus, cron, entre outros, e suporta scale-to-zero.
O objeto central é o ScaledObject. Ele aponta para um Deployment alvo e define um ou mais triggers. Como funciona na prática:
- O KEDA consulta a fonte do trigger a cada
pollingIntervalsegundos. - Fila vazia: mantém o Deployment em 0 réplicas (se
minReplicaCount: 0). - Chega um evento: o KEDA ativa o Deployment (de 0 para 1).
- A partir de 1, quem calcula o número de réplicas é um HPA que o próprio KEDA cria: por exemplo, com
value: "10"no modoQueueLength, 40 mensagens resultam em 4 Pods. - A fila fica vazia e permanece assim por
cooldownPeriodsegundos: o KEDA leva o Deployment de volta a 0.
Três pontos de precisão. Primeiro, o HPA sozinho não consegue ir a zero (o mínimo é 1), então a ativação de 0 para 1 e o retorno a 0 são responsabilidades do KEDA. Segundo, o cooldownPeriod (padrão 300 segundos) conta o tempo em que o gatilho está inativo (fila vazia) e só vale para a ida a zero. Terceiro, a diferença entre as duas formas de descer: quando o gatilho fica inativo, o KEDA zera o Deployment direto, de qualquer número de réplicas (de 4 para 0, por exemplo), ao fim do cooldownPeriod; já a janela de estabilização de scale down do HPA (padrão de 5 minutos, ajustável no ScaledObject em advanced.horizontalPodAutoscalerConfig.behavior) vale para reduções enquanto a fila ainda está ativa, como ir de 5 para 3 réplicas com a fila diminuindo, mas ainda com itens.
Teoria de filas. Chamando de λ a taxa de chegada de eventos e de μ a taxa com que cada Pod processa, com c Pods a capacidade é c·μ. A condição de estabilidade é λ < c·μ: se a chegada for sustentadamente maior que a capacidade, a fila cresce sem limite e nenhum autoscaling resolve. A Lei de Little (L = λ·W) relaciona o número médio de itens no sistema L, a taxa de chegada λ e o tempo médio no sistema W: se o backlog cresce com λ constante, W está aumentando, ou seja, faltam Pods.
Oscilação. Um desafio de controle é evitar o sobe e desce de réplicas, causado pelo atraso da realimentação (um Pod novo leva tempo para ficar pronto) e por limiares fixos. Mecanismos que o HPA e o KEDA oferecem: uma tolerância (o HPA padrão só reage quando a métrica passa de cerca de 110% ou cai abaixo de cerca de 90% do alvo, uma margem de 10%), janelas de estabilização e o cooldownPeriod. Um conceito geral de controle é a banda morta (escalar para cima em um limiar e para baixo em outro, mais baixo); ele ilustra a ideia de histerese, mas não é uma configuração direta do HPA ou do KEDA, que usam tolerância e janelas. Como filas absorvem rajadas, aceita-se um backlog temporário enquanto os Pods novos sobem.
O KEDA é independente de provedor (AKS, EKS, GKE, on-premises) e complementa o HPA, sem substituí-lo. Um caso típico: workers de pedidos escalados pela fila do SQS ou do Service Bus em promoções relâmpago, voltando a zero na madrugada. Para fontes de eventos que o KEDA não suporta, existem scalers externos via gRPC.
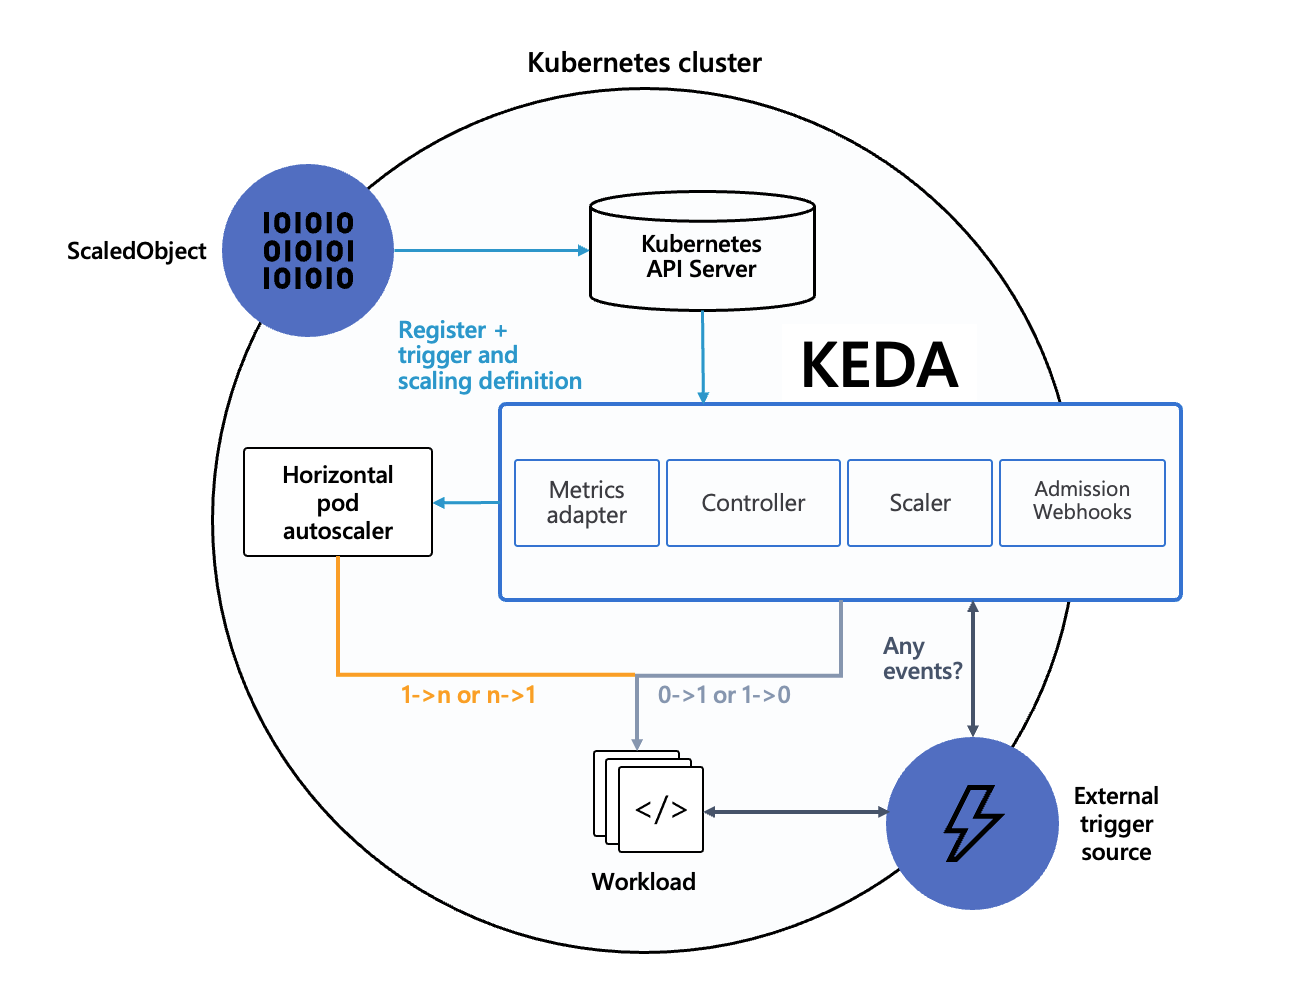
cooldownPeriod do KEDA, e não a janela do HPA.Diagrama: keda.sh, The KEDA Authors, Apache 2.0Os conceitos-chave
KEDA
autoscaling orientado a eventos (filas, métricas, cron); complementa o HPA.
Scale-to-zero
o KEDA liga o Deployment no primeiro evento e o desliga depois do cooldownPeriod com o gatilho inativo, de qualquer número de réplicas.
ScaledObject
o objeto central (alvo, triggers, mínimo e máximo de réplicas, intervalos).
cooldownPeriod e janela do HPA
o primeiro governa a ida a zero com a fila vazia; a janela de 5 minutos do HPA governa reduções com a fila ainda ativa.
Teoria de filas
estabilidade com λ < c·μ; Lei de Little L = λ·W.
Oscilação
contida com tolerância (cerca de 10%), janelas de estabilização e cooldownPeriod.
Banda morta
conceito geral de controle; não é um campo do HPA nem do KEDA.
Independente de nuvem
extensível com scalers externos via gRPC.
Exemplos comentados
Exige um RabbitMQ acessível pelo cluster; serve para leitura.
# scaledobject-rabbitmq.yamlapiVersion: keda.sh/v1alpha1kind: ScaledObjectmetadata:name: worker-scalerspec:scaleTargetRef:name: worker # Deployment alvominReplicaCount: 0 # permite scale-to-zeromaxReplicaCount: 5cooldownPeriod: 60 # fila vazia por 60s antes de ir a zeropollingInterval: 15 # consulta a fila a cada 15striggers:- type: rabbitmqmetadata:queueName: pedidosprotocol: amqpmode: QueueLength # escala pelo tamanho da filavalue: "10" # um Pod para cada 10 mensagenshostFromEnv: RABBITMQ_URL # variável com a URL do broker, definida no container do Deployment alvo
Comandos essenciais desta etapa
keda-hpa-)Mão na massa
- Instale o KEDA com o Helm e aplique
keda-lab.yaml. Rodekubectl get scaledobjecte observeREADY TrueeACTIVE False(nenhum trabalho). - Rode
kubectl get deployment workere observe0/0: o worker foi a zero, algo que o HPA sozinho não faz. - Em um segundo terminal, rode
kubectl get deployment worker -w. No primeiro, empurre 20 itens comLPUSH. Observe o número de réplicas subir até 4, e confira comkubectl get hpao HPA criado pelo KEDA. - Apague a fila com
redis-cli DEL filae observe o Deployment ir de 4 réplicas direto para 0 depois de cerca de 30 segundos (ocooldownPerioddo exercício). Isso é mais rápido que os 5 minutos de estabilização do HPA porque, com a fila vazia, o gatilho fica inativo e o KEDA zera o Deployment sem passar pela descida gradual; a janela do HPA só valeria se a fila estivesse diminuindo, mas ainda com itens. - Empurre 100 itens e observe o limite
maxReplicaCount: 5: mesmo com a fila pedindo 20 Pods, o KEDA respeita o teto. - Limpe:
kubectl delete -f keda-lab.yamlehelm uninstall keda -n keda.
Dica: Ajuste pollingInterval e cooldownPeriod à dinâmica da sua carga. Um cooldown curto demais derruba Pods bons no meio de uma rajada intermitente; um cooldown longo demais desperdiça recursos. E lembre: se λ ≥ c·μ de forma sustentada, nenhum autoscaling resolve, porque o gargalo é a capacidade ou o código, e não o número de Pods.
Anota aí: O KEDA escala pelo evento (fila, métrica, cron), liga e desliga o Deployment com scale-to-zero e entrega o resto ao HPA, mas nada compensa uma carga permanentemente maior que a capacidade.
Etapa 09 rbac + identidade + tls
Segurança no cluster
O problema
Um cluster real roda dezenas de serviços de vários times. Se um deles for comprometido (uma dependência vulnerável, uma imagem com falha), o invasor passa a ter o que aquele Pod tem: o token de ServiceAccount, as permissões dela e as credenciais de nuvem que tenha por perto. Se todos os Pods usam a mesma identidade genérica, com permissões amplas, o invasor chega ao cluster inteiro. Um incidente conhecido (Tesla, 2018) combinou um painel do Kubernetes aberto sem senha com credenciais da AWS dentro de um Pod, e terminou em mineração de criptomoeda na conta da empresa. A defesa é limitar o estrago de antemão, com três pilares: identidade (ServiceAccounts), autorização (RBAC de menor privilégio) e criptografia (TLS automatizado), sob a filosofia *Zero Trust*: nada é confiável por padrão.
O conceito
Identidade: ServiceAccounts. Cada aplicação deve ter a sua própria ServiceAccount, nunca a default do namespace. A ServiceAccount dá ao Pod um token para falar com o API Server. Identidades separadas por aplicação permitem delimitar o estrago quando um Pod é comprometido. Se a aplicação nunca fala com o API Server, desligue até a montagem do token com automountServiceAccountToken: false.
Autorização: RBAC. Permissões são concedidas por Roles (restritas a um namespace) ou ClusterRoles (em todo o cluster) e ligadas a sujeitos por RoleBindings (ou ClusterRoleBindings). O modelo é um grafo: sujeito, binding, role e permissão. Regras de menor privilégio:
- Prefira Role (namespaced) a ClusterRole.
- Conceda só os verbos necessários (
get,list) e só os recursos necessários. - Evite o curinga
*em verbos e recursos.
O RBAC do Kubernetes é aditivo: só existem regras que dão permissão, não há regras de negação, e o que não foi concedido está negado. Isso o torna auditável: é possível listar de forma determinística quem pode fazer o quê. O ABAC (baseado em atributos) é mais expressivo, porém opaco, e é um mecanismo legado, raramente usado. Para políticas condicionais ("negar Pod sem limits", "só aceitar imagens de determinado registro"), usa-se um mecanismo de admission como OPA/Gatekeeper, com a linguagem Rego (política como código), ou os recursos nativos de admission policy do Kubernetes. Quanto mais expressiva a política, mais difícil provar suas propriedades.
Identidade federada com a nuvem. Aplicações precisam acessar S3, buckets e cofres de segredos sem embutir chaves estáticas no container. A solução é federar a ServiceAccount do Kubernetes com uma identidade da nuvem por meio de OIDC, recebendo credenciais de curta duração:
- IRSA (IAM Roles for Service Accounts) no EKS: a ServiceAccount recebe uma annotation com o ARN de uma IAM Role. Cada aplicação tem a sua Role, com o mínimo necessário. (O EKS também oferece o EKS Pod Identity como alternativa mais recente.)
- Workload Identity no GKE e no AKS: a ServiceAccount é associada a uma identidade de nuvem (conta de serviço no GKE, identidade gerenciada no AKS).
Isso elimina segredos estáticos e restringe a credencial ao contexto do Pod. O mesmo princípio vale para o IAM: o ataque conhecido como SCARLETEEL (2023, documentado pela Sysdig) usou credenciais obtidas de containers para se mover em ambientes de nuvem, e o episódio reforça a lição de manter permissões do IAM no mínimo e não deixar segredos estáticos nos Pods.
TLS automatizado: cert-manager. Gerenciar certificados à mão não escala: eles expiram e ficam inconsistentes. O cert-manager automatiza o ciclo de vida por CRDs: Issuer e ClusterIssuer (quem emite: autoassinado, CA interna, ACME/Let's Encrypt, Vault) e Certificate (o que emitir, com nome, SANs, duração e renewBefore para renovação antecipada). Ele gera a requisição, obtém a assinatura, preenche um Secret com tls.crt e tls.key e renova sozinho. O certificado é X.509, parte de uma cadeia de confiança que termina em uma CA raiz. O próprio Kubernetes usa mais de uma CA (etcd, API server, front-proxy) para compartimentalizar: se uma vaza, as outras seguem intactas.
Rotação de segredos. Segredos devem ser trocados para reduzir a janela de exposição. Uma troca instantânea é impraticável em sistemas distribuídos (não há bloqueio global), então usa-se um período de convivência: a credencial nova e a antiga valem ao mesmo tempo até todos migrarem, e então a antiga é invalidada. Segredos dinâmicos (Vault, tokens curtos) já são efêmeros e quase dispensam rotação. Na rotação da chave de criptografia do etcd, todos os API servers precisam conhecer a nova chave *antes* de ela passar a ser usada para escrever, senão um API server que não a conhece não consegue ler os dados gravados com ela.
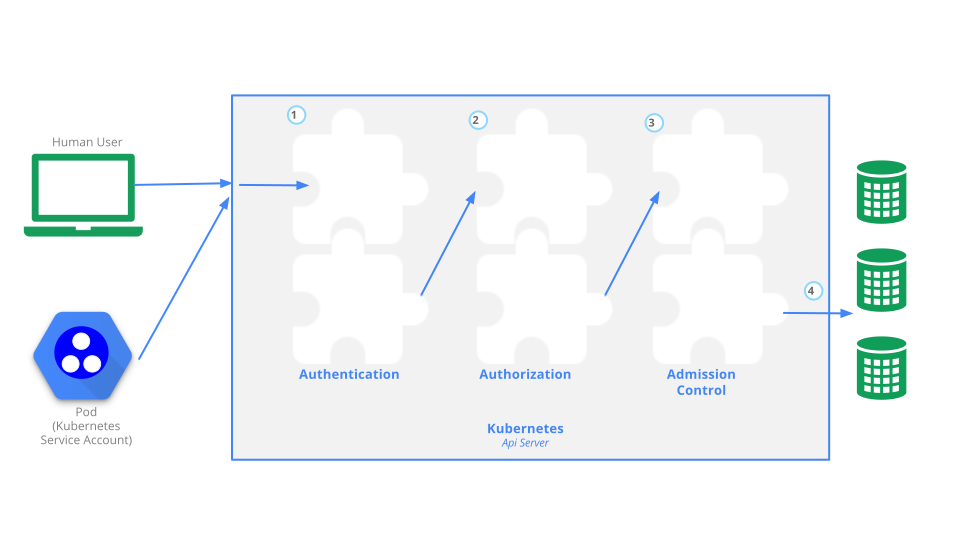
Os conceitos-chave
Três pilares
ServiceAccount (identidade), RBAC (autorização) e cert-manager (criptografia), sob Zero Trust.
Uma ServiceAccount por aplicação
nunca a default.
RBAC de menor privilégio
Role no namespace, verbos e recursos específicos, sem *.
RBAC é aditivo e auditável
só há regras que dão permissão; ABAC é legado; OPA/Gatekeeper cobre políticas condicionais.
Identidade federada
IRSA e Workload Identity entregam credenciais de curta duração, sem chave estática no Pod.
cert-manager
Issuer e Certificate automatizam emissão e renovação; múltiplas CAs compartimentalizam a confiança.
Rotação com convivência
a credencial nova e a antiga valem juntas até todos migrarem.
Lições de incidentes
IAM de menor privilégio e segredos fora dos Pods limitam o estrago.
Exemplos comentados
O RBAC roda no Minikube. A annotation de IRSA só tem efeito no EKS com o provedor OIDC configurado, mas o YAML é aceito normalmente pelo cluster local, que apenas ignora a annotation.
# rbac-analytics.yamlapiVersion: v1kind: ServiceAccountmetadata:name: analytics-sanamespace: analyticsannotations:eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/S3Reader # IRSA: só funciona no EKS; ARN fictício---apiVersion: rbac.authorization.k8s.io/v1kind: Role # restrita ao namespace, não é ClusterRolemetadata:name: analytics-readnamespace: analyticsrules:- apiGroups: [""] # grupo "core" da APIresources: ["pods"]verbs: ["get", "list"] # só leitura, sem "*"- apiGroups: [""]resources: ["configmaps"]verbs: ["get"]---apiVersion: rbac.authorization.k8s.io/v1kind: RoleBindingmetadata:name: bind-analytics-readnamespace: analyticsroleRef: # qual RoleapiGroup: rbac.authorization.k8s.iokind: Rolename: analytics-readsubjects: # para quem- kind: ServiceAccountname: analytics-sanamespace: analytics
Comandos essenciais desta etapa
Mão na massa
- Crie o ambiente de teste de RBAC:
kubectl create namespace lab,kubectl create serviceaccount leitor -n lab,kubectl create role ler-pods --verb=get,list --resource=pods -n labekubectl create rolebinding bind-leitor --role=ler-pods --serviceaccount=lab:leitor -n lab. - Teste com
kubectl auth can-i list pods -n lab --as=system:serviceaccount:lab:leitor. Observeyes. - Teste
delete podseget secrets(que não foram concedidos). Observenonos dois. Teste tambémlist pods -n default: observeno, porque a Role só vale no namespacelab. - Aplique
rbac-analytics.yaml(depois de criar o namespaceanalytics) e rodekubectl create token analytics-sa -n analytics. Observe que o token é gerado na hora, com validade limitada, em vez de uma credencial permanente. - Instale o cert-manager, aplique
pki.yamle rodekubectl get certificate. ObserveREADY Truenos dois certificados e confira com oopenssloissuerdo certificado do serviço (oopensslprecisa estar instalado na sua máquina; sem ele, usekubectl describe certificate service-a-cert). Isso demonstra a emissão automática; a renovação acontece sozinha,renewBeforeantes do vencimento. - Leia o exemplo de IRSA sem executar e liste o que faltaria para funcionar (cluster EKS, provedor OIDC, IAM Role com a relação de confiança com a ServiceAccount).
- Limpe:
kubectl delete namespace lab analytics,kubectl delete -f pki.yaml,kubectl delete secret ca-interna-tls service-a-tls(o cert-manager não apaga por padrão os Secrets que criou) ehelm uninstall cert-manager -n cert-manager.
Dica: Use kubectl auth can-i --as=... no CI para validar que suas ServiceAccounts têm *exatamente* as permissões esperadas e nada além. Combine com IRSA ou Workload Identity de escopo mínimo: assim, mesmo que um container seja comprometido, o invasor fica limitado ao que aquela identidade específica pode fazer, dentro e fora do cluster.
Anota aí: Uma ServiceAccount por aplicação, um RBAC com só os verbos necessários e credenciais de curta duração transformam um container comprometido em um incidente contido.
Etapa 10 bônus · podinfo em produção
Bônus, o podinfo do módulo básico vai para produção
O problema
A Etapa 09 do guia básico deixou o podinfo funcionando com um ConfigMap, um Deployment de 3 réplicas, um Service NodePort e um HPA entre 2 e 8 réplicas. Funciona, mas tem lacunas que as etapas deste guia ensinaram a fechar. Existe um único ambiente, com os YAMLs copiados à mão. O Pod roda com a ServiceAccount default. Nada garante que as réplicas não caiam todas no mesmo nó, e uma drenagem de nó pode tirar réplicas demais ao mesmo tempo. O limit de CPU pode causar throttling num serviço sensível a latência. E não existe como testar uma versão nova sem expor todas as réplicas a ela de uma vez.
O conceito
Esta etapa transforma os manifestos da Etapa 09 do básico em um chart Helm e reforça o Deployment com as peças deste guia. Cada peça vem da etapa que a ensinou:
- Helm (Etapa 04): o ConfigMap, o Service e o HPA entram no chart sem mudanças relevantes, como templates. O mesmo chart serve dev, staging e produção, trocando apenas o arquivo de values.
- ServiceAccount mínima (Etapa 09): o podinfo ganha uma ServiceAccount própria. Ele é um servidor HTTP que nunca chama o API Server, então não recebe nenhum Role nem RoleBinding, e o token nem é montado no Pod (
automountServiceAccountToken: false). É o menor privilégio levado ao limite: nenhuma credencial onde nenhuma é necessária. - Sem limit de CPU (Etapa 01): o podinfo é sensível a latência, então o chart mantém requests de CPU e memória e um limit só de memória, para evitar throttling. O Pod fica Burstable.
- Topology Spread (Etapa 02): espalha as réplicas entre nós com
maxSkew: 1, para que a queda de um nó não leve todas as réplicas. Em produção multi-nó, useDoNotSchedule; no Minikube, de um nó só,ScheduleAnyway, porqueDoNotScheduledeixaria as réplicas além da primeira emPendingpara sempre. - PodDisruptionBudget (Etapa 02): garante um piso de réplicas durante disrupções voluntárias (drain, upgrade de nó, consolidação do Karpenter). Como visto na Etapa 02, ele não protege contra despejo por pressão de recursos.
- Rollout ajustado (Etapa 03):
maxUnavailable: 0para nunca reduzir a capacidade,maxSurge: 1para criar um Pod extra por vez,minReadySecondse a annotationchange-causepara registrar cada troca. - Canário (Etapa 06): uma segunda release do mesmo chart, com 1 réplica e a versão nova, recebe uma fração do tráfego do mesmo Service (a técnica nativa por proporção de réplicas). A promoção é um
helm upgrade --atomic.
Por que o chart precisa distinguir o canário. Duas releases do mesmo chart não podem criar objetos com o mesmo nome (o Helm recusa, porque o objeto pertence a outra release). Por isso, o nome do Deployment vem de .Release.Name, e Service, ConfigMap, HPA, ServiceAccount e PDB só são criados pela release estável (canary: false). Os Pods distinguem a versão com um label track (stable ou canary), usado no selector de cada Deployment, para que dois Deployments não disputem os mesmos Pods. O Service seleciona só por app: podinfo, então enxerga os dois.
O que fica de fora, e por quê:
- Karpenter e IRSA ou Workload Identity são conceitos de nuvem, sem efeito num Minikube de um nó; ficam só na leitura das Etapas 07 e 09.
- cert-manager: sem ingress com TLS neste laboratório, não há o que emitir ou renovar.
- KEDA: o HPA que já existe cobre o perfil do podinfo, uma API HTTP que não deve ir a zero; o scale-to-zero por fila faz sentido para workers de fila.
- Blue/Green: para um único Service público, escolhe-se uma estratégia de promoção. O canário, progressivo e guiado por métricas, combina melhor com um serviço que já expõe
/healthze/readyz. - PVC: continua fora, pelo mesmo motivo do guia básico (volume
ReadWriteOncecompartilhado entre várias réplicas). - podAntiAffinity: o chart segue o conselho da Etapa 02 e usa Topology Spread em vez de afinidade entre Pods.
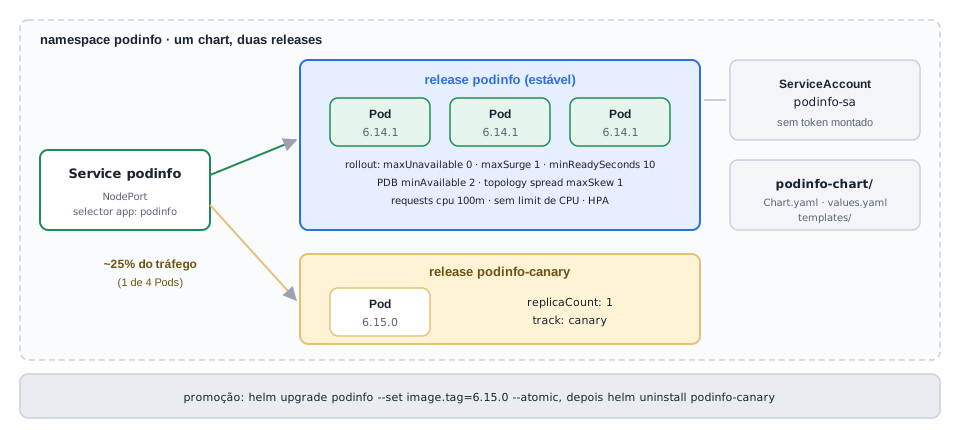
helm upgrade --atomic da release estável seguido da remoção do canário.Diagrama: feito para este guiaOs conceitos-chave
Helm como base
um chart, um values por ambiente, o mesmo molde para todos.
ServiceAccount sem permissões
identidade própria, sem Role e sem token montado.
Sem limit de CPU
evita throttling em serviço sensível a latência; o Pod fica Burstable.
Topology Spread com maxSkew: 1
espalha as réplicas; ScheduleAnyway no Minikube e DoNotSchedule em produção multi-nó.
PDB
piso de réplicas em disrupções voluntárias; não vale para despejo por pressão.
Rollout ajustado
maxUnavailable: 0, maxSurge: 1, minReadySeconds e change-cause.
Canário por release paralela
segunda release com label track: canary, mesmo Service, promoção por helm upgrade --atomic.
Exemplos comentados
A estrutura de pastas é podinfo-chart/ com Chart.yaml, values.yaml e, dentro de templates/, seis arquivos. Os arquivos de template abaixo estão identificados pelo nome no comentário da primeira linha.
# Chart.yamlapiVersion: v2name: podinfodescription: podinfo em formato de produçãotype: applicationversion: 0.1.0 # versão do chartappVersion: "6.14.1" # versão da aplicação
Comandos essenciais desta etapa
--set)Mão na massa
- Monte a pasta
podinfo-chart/comChart.yaml,values.yamle os seis arquivos detemplates/. Rodehelm lint ./podinfo-chartehelm template podinfo ./podinfo-charte observe o YAML renderizado, com o Deployment, o Service, o HPA, a ServiceAccount e o PDB. - Rode
helm template podinfo-canary ./podinfo-chart --set canary=truee observe que só o Deployment aparece como objeto (com nomepodinfo-canaryetrack: canary); os outros arquivos aparecem vazios ou só com o comentário da primeira linha, sob# Source:. É isso que evita colisão de nomes entre as duas releases. - Confira as tags com
docker manifest inspect stefanprodan/podinfo:6.14.1edocker manifest inspect stefanprodan/podinfo:6.15.0. Com as duas confirmadas, instale a produção:helm install podinfo ./podinfo-chart -n podinfo --create-namespace, e confirme 3 PodsRunningcomkubectl get pods -n podinfo -o wide. - Rode as três chamadas
kubectl auth can-iparapodinfo-sa. Observenonas três: o app não tem motivo para chamar o API Server, então não recebeu credencial alguma. - Rode
kubectl get pdb podinfo -n podinfoe observeALLOWED DISRUPTIONS 1(3 Pods saudáveis, mínimo de 2). - Suba o canário com
helm install podinfo-canary ... --set canary=true --set replicaCount=1 --set image.tag=6.15.0e observe emkubectl get endpoints podinfo -n podinfoos 4 IPs, um deles com a versão nova servindo tráfego real. - Promova com
helm upgrade podinfo ... --set image.tag=6.15.0 --atomic, remova o canário comhelm uninstall podinfo-canary -n podinfoe confirme emkubectl rollout history deployment/podinfo -n podinfoque a troca ficou registrada. - Limpe as duas releases: o canário já saiu no passo 7, então rode
helm uninstall podinfo -n podinfoekubectl delete namespace podinfo.
Dica: O --atomic não é uma garantia completa: ele desfaz a release se as probes não ficarem saudáveis, mas só depois de tentar. Combine sempre com o PDB e com maxUnavailable: 0, para que uma tentativa fracassada nunca reduza a capacidade enquanto o Helm ainda decide desistir. Duas precisões sobre o chart: minAvailable igual ao minReplicas do HPA (2, neste caso) deixa ALLOWED DISRUPTIONS em 0 quando o HPA está no piso, e um drain nesse momento fica bloqueado (considere maxUnavailable: 1 no PDB). E o campo replicas do Deployment é reaplicado pelo valor do chart a cada helm upgrade, o que pode desfazer o ajuste do HPA; uma prática comum é omitir replicas do template quando o HPA está ativo.
Anota aí: Um deploy de produção é a composição certa e não mais YAML: Helm empacota, uma ServiceAccount sem permissões isola a identidade, topology spread e PDB protegem contra falha de nó e manutenção, o rollout ajustado evita queda de capacidade e o canário testa a versão nova com tráfego real.
Etapa 11 · revisão
Checklist de autoavaliação
Etapa 01: Saúde e recursos
- Sei dizer o que acontece quando cada probe falha (liveness, readiness, startup).
- Tirei um Pod do Service com
/readyz/disablee confirmei o endpoint a menos, sem reinício. - Derrubei o processo com
/panice sei explicar que quem reiniciou foi orestartPolicy, e não a liveness. - Vi uma liveness falhar de verdade, com o processo vivo, e o container ser reiniciado por isso.
- Provoquei um OOMKill e sei explicar a diferença entre estourar o limit de memória e o de CPU.
- Consultei as três classes de QoS com
qosClasse sei o que determina cada uma. - Sei explicar por que um limit de CPU pode aumentar a latência.
Etapa 02: Agendamento e nós
- Vi um Pod
Pendingporuntolerated tainte o fiz rodar com toleration e affinity. - Sei explicar por que o taint sozinho não garante que o Pod vá para o nó dedicado.
- Distribuí 4 réplicas em 2 nós com
topologySpreadConstraintsemaxSkew: 1. - Vi um
drainser recusado por um PodDisruptionBudget e voltei ao cluster padrão depois de apagar o perfillab. - Sei explicar a diferença entre disrupção voluntária e involuntária, e por que o despejo por pressão de recursos ignora o PDB e não é OOMKill.
Etapa 03: Rollouts
- Fiz um rolling update com
maxUnavailable: 0emaxSurge: 1e observei o ritmo. - Detectei um rollout travado com
progressDeadlineSecondse voltei comrollout undo. - Registrei a
change-causee a vi norollout history. - Sei dizer quando usar Recreate em vez de RollingUpdate.
Etapa 04: Helm
- Criei um chart do zero e o renderizei com
helm templateehelm lint. - Instalei, atualizei e voltei uma release, e vi o histórico de revisões.
- Vi um
--atomicdesfazer um upgrade que não ficou saudável. - Sei explicar a diferença entre
versioneappVersion.
Etapa 05: Blue/Green
- Fiz a promoção e o rollback com
kubectl patchno selector do Service. - Sei explicar por que a compatibilidade do banco é o principal risco.
- Sei dizer por que o ambiente inativo só deve ser desligado depois de estabilizar.
Etapa 06: Canário
- Montei um canário por proporção de réplicas e medi a divisão com 20 requisições.
- Sei explicar o limite dessa técnica e por que um service mesh ou o Argo Rollouts permitem peso exato.
- Sei dizer a diferença entre Blue/Green e canário.
Etapa 07: Karpenter
- Provoquei um Pod
PendingporInsufficient cpue li o eventoFailedScheduling. - Sei explicar o fluxo do Karpenter (Pod pendente, cálculo, nó novo, consolidação).
- Sei dizer por que o PDB reduz, mas não elimina, o risco de uma interrupção Spot.
Etapa 08: KEDA
- Instalei o KEDA e vi o Deployment ir a zero e subir conforme a fila.
- Sei dizer o que o KEDA faz que o HPA sozinho não faz.
- Sei explicar a condição
λ < c·μe o que ocooldownPeriodcontrola. - Sei explicar por que, com a fila vazia, o Deployment vai direto de 4 réplicas a 0, sem esperar os 5 minutos de estabilização do HPA.
Etapa 09: Segurança
- Criei uma ServiceAccount com Role de só leitura e validei com
kubectl auth can-i. - Gerei um token de curta duração com
kubectl create token. - Emiti um certificado com o cert-manager, conferi o emissor com
openssle apaguei também os Secrets que ele criou. - Sei explicar o que IRSA e Workload Identity evitam.
Etapa 10: Bônus
- Montei o chart do podinfo e renderizei as releases estável e canário com
helm template. - Conferi as tags do podinfo com
docker manifest inspectantes de instalar. - Provei com
kubectl auth can-ique a ServiceAccount do podinfo não pode nada. - Subi o canário, vi 4 endpoints e promovi com
helm upgrade --atomic. - Sei explicar por que o chart precisa do label
tracke das condiçõesif not .Values.canary.
Próximos passos: com todos os itens marcados, refaça a Etapa 10 do zero sem consultar o guia, desta vez num perfil do Minikube com vários nós (como o da Etapa 02) e com whenUnsatisfiable: DoNotSchedule, e confira a distribuição das réplicas com kubectl get pods -o wide. Depois, se tiver acesso a uma conta de nuvem de teste, execute os trechos que aqui foram só leitura: o NodePool do Karpenter, o IRSA ou o Workload Identity e o canário com peso exato do Istio ou do Argo Rollouts.
Notas do professor: precisões técnicas
- Este bloco reúne detalhes que ajudam a ler os exemplos com segurança. Nada aqui muda o caminho dos exercícios; são esclarecimentos sobre comportamentos que costumam gerar dúvida.
- Sobre o que você vai ver no terminal
- Saídas de exemplo: as saídas mostradas são formatos típicos. Nomes de Pods, hashes de ReplicaSet, IPs, idades, colunas, textos de eventos e mensagens do Helm variam conforme a versão do Kubernetes, do Minikube e do Helm. Compare a estrutura e o comportamento, não o texto exato. As saídas marcadas como aproximadas dependem ainda do tempo de resposta do seu ambiente.
- `kubectl get endpoints` (Etapas 01, 05, 06 e 10): a partir do Kubernetes 1.33, o comando pode exibir um aviso de depreciação em favor de EndpointSlices. Ele continua útil para os exercícios; a alternativa é
kubectl get endpointslices. - Números atribuídos a empresas (Etapas 01, 06 e 07): os ganhos citados para Buffer, Shopify, Netflix, Nubank, Mercado Livre e Tinybird, e a economia de até 30% do Karpenter, são relatos públicos dessas empresas. Dependem do ambiente de cada uma e servem como ordem de grandeza, não como promessa.
- Sobre comportamentos que surpreendem
- Throttling de CPU (Etapa 01): o throttling é o comportamento esperado da cota do CFS (períodos de 100 ms), não um defeito do Kubernetes. Um serviço com picos curtos pode esgotar a cota do período e ficar parado até o próximo, mesmo com uso médio baixo. Versões antigas do kernel agravavam o efeito com falhas já corrigidas, mas o mecanismo em si permanece.
- Classes de QoS (Etapa 01): Guaranteed exige requests iguais a limits em CPU e em memória, em todos os containers. Um Pod com limit só de memória, como o do exemplo, é Burstable.
- Quem reinicia o quê (Etapa 01): o kubelet recria containers cujo processo terminou, por causa do
restartPolicy, com ou sem probe. A liveness existe para o processo que continua vivo, mas não responde. Um endpoint que derruba o processo (como o/panicdo podinfo) demonstra o primeiro caso; o Podliveness-falhademonstra o segundo. - Ordem de despejo (Etapa 02): o kubelet despeja primeiro os Pods cujo uso do recurso em falta excede o request, depois considera a prioridade e, por último, o uso relativo ao request. Por padrão, o despejo forçado começa com menos de 10% de espaço livre no sistema de arquivos do nó (disco cerca de 90% cheio) ou menos de 100Mi de memória disponível; os valores são configuráveis.
- PDB só vale para disrupção voluntária (Etapas 02, 07 e 10): o
drain, o upgrade de nó e a consolidação do Karpenter respeitam o PodDisruptionBudget. O despejo por pressão de recursos e a retirada de uma instância Spot pelo provedor são involuntários e não esperam o orçamento. Por isso o PDB reduz o risco de uma interrupção Spot, mas não o elimina. - Contexto do `kubectl` (Etapa 02):
minikube delete -p labapaga também o contextolab. Depois dele, volte ao cluster padrão comminikube startoukubectl config use-context minikubee confirme comkubectl get nodesantes de seguir. - Percentuais do RollingUpdate (Etapa 03): o Kubernetes arredonda
maxSurgepara cima emaxUnavailablepara baixo. Com 10 réplicas e os padrões de 25%, o rollout admite no máximo 13 Pods em execução e no mínimo 8 disponíveis, e não exatamente 125% e 75%. - `--record` está obsoleto (Etapa 03): para registrar o motivo de uma troca, use a annotation
kubernetes.io/change-causeno Deployment, comkubectl annotateou no próprio manifesto. - Templates e revisões do Helm (Etapa 04): um template produz o mesmo YAML para os mesmos values, exceto quando usa funções como
lookup,nowourandAlphaNum.helm upgradesem mudanças não altera os recursos do cluster, mas registra uma nova revisão, ehelm rollbacktambém cria uma revisão nova em vez de apagar as intermediárias. - Troca de selector e conexões abertas (Etapa 05): a troca do selector vale para novas conexões. Conexões já abertas, como as de HTTP keep-alive, podem continuar nos Pods antigos até serem encerradas.
- Versões de API do Istio e peso no Argo Rollouts (Etapa 06): o
VirtualServiceprecisa de umDestinationRuleque declare os subsets, e instalações antigas do Istio usamnetworking.istio.io/v1beta1. No Argo Rollouts, semtrafficRoutingosetWeighté aproximado pelo número de réplicas, como na técnica nativa; só com um roteador compatível o peso é exato. - `nodeClassRef` no Karpenter (Etapa 07): em
karpenter.sh/v1, onodeClassRefexigegroup,kindename. Os nomes de cluster, role e tags dos exemplos são marcadores. - `cooldownPeriod` e janela do HPA no KEDA (Etapa 08): o
cooldownPeriodconta o tempo com o gatilho inativo e só vale para a ida a zero, que o KEDA faz direto, de qualquer número de réplicas. A janela de estabilização de 5 minutos do HPA vale para reduções com a fila ainda ativa. A banda morta (limiares diferentes para subir e descer) é um conceito geral de controle; HPA e KEDA usam tolerância e janelas, não limiares separados. - Conexão do RabbitMQ no KEDA (Etapa 08): o gatilho
rabbitmqprecisa da informação de conexão com o broker, comohostFromEnv, lida de uma variável do container do Deployment alvo. A saída doredis-clino exemplo mostra só números porque okubectl execsem-tnão abre terminal. - Limpeza do cert-manager (Etapa 09): o cert-manager não apaga por padrão os Secrets que criou. Depois de remover os Certificates, apague também
ca-interna-tlseservice-a-tls. - RBAC, ABAC e federação com a nuvem (Etapa 09): o RBAC só tem regras que dão permissão; para negar por condição usa-se um mecanismo de admission, como OPA/Gatekeeper. O ABAC é um mecanismo legado, raramente usado. No EKS, o EKS Pod Identity é uma alternativa mais recente ao IRSA. Na rotação da chave de criptografia do etcd, todos os API servers precisam conhecer a nova chave antes de ela passar a ser usada para escrever.
- Nomes de objetos em releases paralelas (Etapa 10): duas releases do mesmo chart não podem criar objetos com o mesmo nome. O chart usa
.Release.Nameno Deployment para que a release do canário não colida com a principal, cria Service, ConfigMap, HPA, ServiceAccount e PDB só na release estável (canary: false) e usa o labeltracknos selectors para que os dois Deployments não disputem os mesmos Pods. - `replicas` e PDB com o HPA (Etapa 10): o
replicasdo Deployment é reaplicado pelo valor do chart a cadahelm upgrade, o que pode desfazer o ajuste do HPA; uma prática comum é omiti-lo do template quando o HPA está ativo. Além disso,minAvailableigual aominReplicasdo HPA deixaALLOWED DISRUPTIONSem 0 quando o HPA está no piso, e umdrainnesse momento fica bloqueado. - Pontos a verificar antes de executar
- Tags de imagem (Etapas 01 e 10):
stefanprodan/podinfo:6.14.1e6.15.0não foram verificadas aqui. Confira comdocker manifest inspect stefanprodan/podinfo:<tag>: um JSON indica que a tag existe, eno such manifestindica que não. Se não existirem, use tags publicadas. O formato do JSON de resposta do podinfo, usado nogrepda Etapa 10, também pode variar. - Imagens de laboratório:
polinux/stress(Etapa 01),busybox(Etapas 01, 05, 06 e 08),hashicorp/http-echo(Etapas 05 e 06),redis:7(Etapa 08) ecurlimages/curl(Etapa 10) são imagens públicas comuns. Confirme a disponibilidade no momento da execução. - Nomes de nó (Etapa 02): o perfil
labdo Minikube nomeia os nós comolabelab-m02. Se o seu ambiente usar outros nomes, ajuste os comandos de taint, label e drain.