guia de estudo · servidores web em 14 etapas
Servidores web
pela lente da F1.
Este guia ensina, em 14 etapas, o caminho que uma requisição faz do navegador até a aplicação e como configurar cada peça desse caminho. Você começa entendendo para que serve um servidor web, como o HTTP evoluiu da versão 1.1 ao HTTP/3 e a diferença entre forward proxy e reverse proxy; depois estuda os modelos de processamento do Apache (MPMs), a arquitetura orientada a eventos do Nginx, o balanceamento de carga com seus algoritmos e os health checks com failover e diagnóstico de 502 e 504. No Kubernetes, você publica serviços com Ingress e TLS automático pelo cert-manager e, com o Istio, estuda a arquitetura da service mesh, o deploy gradual com VirtualService e DestinationRule, e o mTLS com autorização e observabilidade; por fim, calcula metas de disponibilidade (SLA e SLO), testa o failover de um IP virtual com Keepalived e protege a borda com WAF, rate limiting e HSTS. Antes das etapas, a seção seguinte apresenta a lente de F1 do guia: uma comparação geral que mostra o mesmo caminho funcionando dentro de uma equipe de Fórmula 1.
Cada etapa só depende do que foi explicado antes dela e termina com um exercício pequeno que prova que você entendeu. Servidores se aprendem derrubando e religando peças de propósito, então não pule os blocos "Mão na massa".
O que você precisa ter: um terminal com curl e o Docker (com Compose v2), que bastam para as Etapas 01 a 07, 13 e 14. As Etapas 08 a 12 rodam no Minikube e partem do que os guias de Kubernetes ensinam: Pods, Deployments, Services e o kubectl com YAML declarativo vêm do guia de Kubernetes básico, e o Helm, usado aqui para instalar o cert-manager, é apresentado no guia de Kubernetes avançado. Se esses temas forem novos para você, estude esses guias antes da Etapa 08.
Como usar este guia: mantenha um terminal aberto ao lado do texto. Os laboratórios assumem Linux (Ubuntu ou Debian), Docker com Compose v2 (comando docker compose), curl, python3 e openssl. O utilitário ab (Apache Bench) vem no pacote apache2-utils (sudo apt install apache2-utils). Organize os arquivos em uma pasta por etapa (etapa01/, etapa02/ e assim por diante), porque nomes como compose.yaml e nginx.conf se repetem, e rode docker compose down no fim de cada etapa antes de seguir. Quando um exemplo mostra a saída esperada, compare com a sua: versões, IPs, tempos e contagens vão variar, e a estrutura da saída é o que importa. Saídas abreviadas estão marcadas com (...) e saídas que dependem de versão ou de ambiente aparecem como aproximadas.
O que roda onde: as Etapas 01 a 07, 13 e 14 rodam em Docker (Compose), sem instalar nginx nem apache2 no seu computador. A Etapa 04 traz, além do caminho em Docker, os comandos equivalentes para um Apache instalado no host (sudo apt install apache2), e a Etapa 05 pode ser repetida com um Nginx instalado no host (sudo apt install nginx). As Etapas 08 e 09 rodam no Minikube (com o addon ingress e o cert-manager instalado por Helm). As Etapas 10, 11 e 12 rodam no Minikube com o Istio instalado por istioctl; recomenda-se um perfil com 4 CPUs e 8 GB de memória, ajustado ao que a sua máquina tem. Ficam só como leitura: a emissão de certificados reais com Let's Encrypt (exige domínio público), a política de circuit breaking com ejeção de endpoints e a coleta de traces com Jaeger (exige configurar um provedor de tracing). A Etapa 13 usa Docker em Linux, com permissão de rede (NET_ADMIN) para o Keepalived.
A lente de F1 deste guia
A equipe de F1 vista pela recepção
Os guias de Kubernetes apresentaram o cluster como uma equipe de Fórmula 1 num fim de semana de Grande Prêmio. Na mureta (o pit wall, a bancada voltada para a pista) ficam os engenheiros que decidem, nas garagens ficam os mecânicos que executam, e os carros na pista fazem o trabalho. Cada carro é chamado pelo seu número de corrida, o número que aparece no rádio e na cronometragem, mesmo quando o chassi embaixo dele é trocado. Este guia olha para a mesma equipe por outro ângulo: por onde os pedidos e as pessoas entram nela, por onde passam e quem responde. Em volta das garagens fica o paddock, a área de trabalho das equipes, fechada ao público. Só entra quem tem credencial, e a entrada é feita por catracas que leem o passe de cada pessoa.
Dentro do paddock, cada equipe tem uma recepção na sua área de hospitalidade (o motorhome, a estrutura onde a equipe recebe imprensa e convidados). Todo pedido de fora chega a ela. O que já está pronto, como o comunicado de imprensa ou a folha de tempos da sessão, a recepção entrega na hora. O resto ela encaminha a quem resolve: uma pergunta técnica vai ao engenheiro responsável, e a resposta volta pela recepção. Quem perguntou não sabe qual engenheiro respondeu nem quantos existem atrás da recepção, e o engenheiro recebe, junto com a pergunta, um bilhete dizendo quem perguntou de verdade. No sentido contrário, a saída também tem um ponto único. Quando um engenheiro precisa de algo de um fornecedor, o pedido passa pelo setor de compras, que aprova ou recusa, registra e faz o pedido em nome da equipe. O fornecedor só conhece o setor de compras.
As conversas da equipe seguem dois formatos. No rádio de voz, entre o engenheiro de corrida (quem acompanha um carro na mureta) e o piloto, só um fala por vez: o engenheiro faz uma pergunta, espera a resposta e só então faz a próxima, mesmo que a segunda fosse rápida. A telemetria funciona de outro jeito. Os sensores do carro enviam dados continuamente à garagem, e centenas de fluxos, cada um identificado pelo sensor de origem, viajam juntos pelo mesmo link, sem que um fluxo espere o outro.
A recepção pode organizar o atendimento de jeitos diferentes. Num deles, cada visitante ganha uma sala e um atendente só para ele: um problema numa sala não afeta as outras, mas com centenas de visitantes faltam salas. Em outro, poucas salas recebem vários atendentes cada, que dividem mesa e arquivos: cabe mais gente, mas um atendente que derruba o arquivo atrapalha a sala inteira. Uma variação desse segundo jeito põe uma pessoa só para vigiar os visitantes que estão sentados sem pedir nada, e libera os atendentes para quem está falando. Há ainda um jeito bem diferente: poucos atendentes, um por mesa, que nunca ficam parados esperando. Quando a resposta depende de um engenheiro, o atendente anota o pedido, combina que será avisado quando ela chegar e atende o próximo. Com poucas pessoas, a recepção acompanha muitos visitantes ao mesmo tempo.
Muitos pedidos podem ser respondidos por qualquer um de um grupo de analistas de dados que fazem o mesmo trabalho. Quem decide qual analista recebe cada pedido é a própria recepção, no mesmo balcão onde o pedido chegou, e não outra pessoa em outro lugar. Ela pode revezar em ordem, dar o dobro de pedidos ao analista mais rápido, escolher quem tem menos pedidos abertos ou mandar os pedidos de um carro sempre ao mesmo analista, que já tem o histórico dele na mesa. Pode decidir só pelo remetente (de qual carro veio) ou ler o pedido e mandar a dúvida de aerodinâmica a quem cuida disso.
A recepção também acompanha a saúde do grupo. Ela nota quando um pedido volta sem resposta e chama cada analista de tempos em tempos, como no radio check (a chamada de rotina no rádio para confirmar que o canal funciona). Quem não responde sai da escala, e um analista reserva só entra quando todos os titulares estão fora.
A recepção não inventa para onde mandar cada pedido. Ela segue uma folha de encaminhamento escrita pela equipe: perguntas sobre o carro 1 vão para quem atende pelo número 1, convidados vão para a hospitalidade, fornecedores vão para a logística. A folha só funciona porque há alguém na recepção que a lê e age; uma folha pregada numa porta sem ninguém não encaminha nada. A recepção também precisa provar que é mesmo da equipe. Ela exibe uma credencial emitida pelo escritório de credenciamento do evento, que qualquer visitante pode conferir. Cada credencial tem validade, e quem cuida dos passes pede a renovação antes do vencimento, sem esperar alguém perceber que venceu.
Por dentro, a equipe conversa pelo intercom, o sistema de rádio interno com canais separados (estratégia, carro 1, carro 2, garagem). Cada pessoa usa um rádio de cinto ligado ao fone, e é esse aparelho, não a pessoa, que cifra a conversa, repete a mensagem que não teve confirmação e grava tudo com horário. As regras de cada aparelho saem de uma central, onde o engenheiro de comunicações define os canais e quem fala em cada um. Só entra num canal um rádio registrado no passe de quem o usa, e estar registrado não basta: a central também diz quem pode falar no canal de estratégia. A gravação com horário permite reconstruir por onde uma decisão passou e onde ela demorou.
Para estrear uma novidade, a equipe usa o caminho cauteloso do guia avançado: a peça nova vai só no carro 1, e o carro 2 continua com a antiga. Um software de estratégia novo pode rodar na fábrica em paralelo, recebendo os mesmos dados ao vivo, sem que a mureta use a resposta dele. A equipe também evita depender de uma peça única. O rádio da garagem tem um equipamento principal e um reserva, que respondem pelo mesmo canal: se o principal cai, o reserva assume, e quem chama não precisa trocar de canal. Cada sistema crítico tem uma meta de tempo no ar, e a equipe treina as trocas com falhas provocadas de propósito, com hora para começar e para parar.
Na entrada, a proteção também vem em camadas. A catraca do paddock confere só a credencial e o portão por onde a pessoa passa. Na hospitalidade, a segurança revista o que a pessoa carrega, soma as suspeitas e só barra quem passa de um limite. E cada veículo de imprensa tem um número máximo de pedidos de entrevista por dia.
É o mesmo caminho que uma requisição faz até a aplicação. A recepção é o servidor web na função de reverse proxy: entrega o conteúdo estático (o comunicado pronto), encaminha o resto ao backend (o engenheiro) e anota o cliente real no X-Forwarded-For (o bilhete). O setor de compras é o forward proxy. As regras da conversa são o HTTP: no rádio de voz um fala por vez e a segunda pergunta espera a primeira resposta, como no HTTP/1.1, enquanto a telemetria, com muitos fluxos identificados no mesmo link, é a multiplexação do HTTP/2. A sala por visitante é o MPM Prefork do Apache, as salas com vários atendentes são o Worker, a pessoa que vigia quem só espera é o Event, e o atendente que anota e passa ao próximo é o worker do Nginx com seu event loop.
A recepção, quando escolhe o analista, é o balanceador de carga: o mesmo Nginx que faz o proxy, com o grupo de analistas declarado no bloco upstream. Decidir pelo remetente é a camada 4, ler o pedido é a camada 7, e os quatro critérios são Round Robin, weight, least_conn e ip_hash. A chamada periódica é o health check ativo, o pedido sem resposta é o passivo, e o analista reserva é o servidor backup. A folha de encaminhamento é o Ingress, e quem a lê na recepção é o Ingress Controller. A credencial da recepção é o certificado TLS, o escritório de credenciamento é o Issuer, e a renovação antes do vencimento é o trabalho do cert-manager.
O intercom é o service mesh: o rádio de cinto é o sidecar Envoy (o data plane), a central do engenheiro de comunicações é o Istiod (o control plane), e a mensagem repetida sem confirmação é o retry. O rádio registrado no passe é o mTLS, com identidade derivada da ServiceAccount, a permissão de falar no canal é a AuthorizationPolicy, e a gravação com horário é o tracing distribuído. A peça só no carro 1 é o canário, e o software em paralelo é o mirroring. O equipamento reserva no mesmo canal é o IP virtual movido pelo Keepalived, a meta de tempo no ar é o SLO, e os treinos de falha são o chaos engineering. A catraca é o firewall de rede, a revista é o WAF, e o limite de pedidos de entrevista é o rate limiting.
As regras dos guias de Kubernetes continuam valendo: cada chassi montado é um Pod, cada garagem é um nó e o número de corrida é o Service. Este guia acrescenta uma: a recepção é sempre a borda. Todo pedido de fora passa por ela antes de chegar a qualquer engenheiro, e quem está atrás dela não precisa saber lidar com a fila, a credencial ou a revista.
Os termos em palavras simples
70
O quadro abaixo traduz cada termo técnico do guia para uma ideia do dia a dia, sem F1 e sem jargão. Não precisa decorar; volte a ele quando um termo aparecer no texto.
| Termo técnico | Em palavras simples |
|---|---|
| Servidor web | O balcão de atendimento de um prédio: recebe quem chega, entrega na hora o que já está pronto (folhetos, formulários) e encaminha os pedidos mais complicados para o setor responsável. |
| Backend (servidor de aplicação) | O setor que de fato resolve o pedido, como o departamento que calcula o preço de uma entrega. Fica atrás do balcão e não precisa lidar com a fila. |
| Conteúdo estático | Material que é igual para todo mundo, como um folheto impresso: basta entregar o arquivo, sem calcular nada. |
| Requisição e resposta | O pedido que o cliente faz e a resposta que volta, como entregar um formulário no balcão e receber o carimbo de volta. |
| Cabeçalho e código de status | Cabeçalho é a etiqueta colada na correspondência, com informações sobre ela (quem enviou, tipo de conteúdo). Código de status é o resultado resumido em um número: 200 "tudo certo", 404 "não achei", 502 e 504 "o setor de trás falhou ou demorou". |
| Terminação TLS | Abrir o envelope lacrado (criptografado) em um único guichê na entrada, em vez de cada setor ter que saber abrir envelopes. |
| Cache | Uma gaveta com cópias de respostas que se repetem, para não ir ao arquivo a cada pedido. |
| Sem estado (stateless) | Cada atendimento começa do zero, como um balcão que não reconhece quem já passou ali. Por isso o cliente carrega um comprovante (cookie) que o identifica. |
| Cookie e sessão | O comprovante que o cliente apresenta a cada visita (cookie) e a ficha que o prédio guarda sobre ele (sessão). |
| Conexão persistente (keep-alive) | Deixar a linha telefônica aberta entre uma pergunta e outra, em vez de ligar de novo a cada pergunta. |
| Head-of-line blocking | Uma fila de caixa única em que o primeiro cliente demora e todos atrás esperam, mesmo com pedidos simples. |
| Multiplexação | Vários pedidos andando juntos pela mesma linha, cada um com seu número, de modo que a resposta de um não precise esperar a do outro. |
| HTTP/1.1, HTTP/2 e HTTP/3 | Três gerações das regras de conversa entre cliente e servidor, cada uma criada para eliminar um tipo de espera da geração anterior. |
| QUIC | Uma forma de entregar as mensagens em que cada conversa tem a sua própria esteira, então uma encomenda perdida em uma esteira não para as outras. |
| Proxy | Um intermediário que recebe um pedido e o repassa a outro lugar em nome de alguém. |
| Forward proxy | A portaria de saída de uma empresa: os funcionários só falam com o exterior por ela, e o exterior só enxerga a portaria. |
| Reverse proxy | A recepção de uma empresa: quem vem de fora fala só com a recepção, que encaminha cada pedido ao setor certo sem que o visitante saiba quantos setores existem. |
| Upstream | O grupo de setores de trás, para onde a recepção encaminha os pedidos. |
| X-Forwarded-For | Um bilhete que a recepção anexa ao pedido dizendo quem o enviou de verdade, já que o setor de trás só vê a recepção entregando. |
| Processo e thread | Processo é uma sala de trabalho independente, com mesa e arquivos próprios. Thread é uma pessoa trabalhando dentro de uma sala, dividindo mesa e arquivos com os colegas. |
| Thread-safe | Uma ferramenta que várias pessoas podem usar ao mesmo tempo sem se atrapalhar. Uma ferramenta que não é thread-safe só funciona bem quando uma pessoa a usa por vez. |
| MPM | A regra que o Apache usa para organizar o atendimento: uma sala por cliente, poucas salas com várias pessoas, ou pessoas que vigiam vários clientes em espera. |
| Prefork, Worker e Event | As três regras de organização do Apache: uma sala isolada por cliente; poucas salas com várias pessoas cada; e a segunda regra com um jeito de não prender uma pessoa a um cliente que só está esperando. |
| mod_php e PHP-FPM | No primeiro, o programa PHP trabalha dentro da sala do Apache. No segundo, ele é um setor separado que o Apache chama quando precisa. |
| I/O não bloqueante e event loop | Em vez de ficar parado diante de um cliente esperando uma resposta, o atendente anota "me avise quando chegar" e atende outro. O event loop é o ciclo de olhar a lista de avisos, tratar o que está pronto e voltar à lista. |
| Worker (Nginx) | Cada atendente que executa esse ciclo; costuma haver um por núcleo do processador. |
| Balanceador de carga | Quem distribui os pedidos entre vários guichês iguais, seguindo uma regra: revezamento, quem tem menos fila ou sempre o mesmo guichê para o mesmo cliente. |
| Camada 4 e camada 7 | Camada 4 decide olhando só endereço e porta, como separar cartas pelo CEP sem abrir o envelope. Camada 7 abre e lê o conteúdo para decidir. |
| Round Robin, weight, least_conn e ip_hash | Revezamento em ordem; revezamento dando mais vezes ao guichê mais forte; escolher o guichê com menos clientes agora; e mandar o mesmo cliente sempre ao mesmo guichê, a partir do endereço dele. |
| Afinidade de sessão | Preferir que o mesmo cliente seja sempre atendido no mesmo guichê, porque a ficha dele está lá. |
| Health check passivo e ativo | Passivo: perceber que um guichê está falhando porque clientes reais reclamaram. Ativo: alguém passar de tempos em tempos perguntando a cada guichê se ele está funcionando. |
| Failover e servidor backup | Failover é redirecionar o atendimento quando um guichê falha. O backup é um guichê reserva, que só abre quando os principais estão fechados. |
| Percentil (p95) | Dizer que 95% dos atendimentos foram mais rápidos que um certo tempo. Mostra a experiência dos mais lentos, que a média esconde. |
| stub_status | Um painel simples do balcão que mostra quantos clientes estão sendo atendidos agora. |
| Ingress e Ingress Controller | O Ingress é o quadro de avisos na portaria de um condomínio ("bloco A vai para o prédio 1, bloco B para o prédio 2"). O Controller é o porteiro que lê o quadro e age. Sem porteiro, o quadro não muda nada. |
| ClusterIP, NodePort e LoadBalancer | Três jeitos de dar um endereço estável a um grupo de programas: só para uso interno; uma porta em cada máquina; ou um endereço externo próprio. |
| Annotation | Observação extra colada em um recurso, que só é lida por quem sabe interpretá-la. |
| pathType | A regra que diz se um endereço precisa ser exatamente igual ao combinado ou só começar igual a ele. |
| Certificado, ACME e Let's Encrypt | Certificado é o documento que prova que o site é quem diz ser. ACME é o protocolo automático para pedir e renovar esse documento. Let's Encrypt é uma entidade gratuita que o emite. |
| SNI | O nome do destino que o visitante diz logo no início da conversa segura, para que uma mesma entrada possa apresentar o documento certo de cada site. |
| Issuer, ClusterIssuer e Certificate | Issuer é o cartório que emite documentos para uma área; ClusterIssuer é o cartório de todas as áreas; Certificate é o pedido de um documento específico. |
| HTTP-01 e DNS-01 | Duas formas de provar ao cartório que o domínio é seu: publicar um arquivo no site ou publicar um registro no cadastro de endereços (DNS). |
| Secret | Um cofre pequeno para senhas e chaves. O conteúdo é apenas codificado; quem protege é o controle de quem pode abrir o cofre. |
| Service mesh | Uma rede de fiscais ao lado de cada programa, que cuidam da comunicação entre eles (reenvio, criptografia, medição) para que os programas não precisem cuidar disso. |
| Sidecar e Envoy | Sidecar é o assistente que trabalha ao lado do programa, na mesma mesa. Envoy é o assistente que o Istio usa. |
| Data plane e control plane | Control plane é a central que decide as regras; data plane são os assistentes que as aplicam a cada pedido. |
| Istiod | A central do Istio: distribui regras, endereços e identidades aos assistentes. |
| ServiceAccount | O crachá de um programa dentro do cluster, que diz em nome de quem ele trabalha. |
| VirtualService e DestinationRule | O primeiro define para onde cada pedido vai (rotas e porcentagens). O segundo dá nome aos grupos de destino e define regras sobre eles. |
| Subset | Um subgrupo nomeado de programas iguais com uma etiqueta em comum, por exemplo "versão 1". |
| Canary, A/B e mirroring | Canário: testar com poucos clientes antes de liberar para todos. A/B: dar versões diferentes a grupos escolhidos por alguma característica. Mirroring: mandar uma cópia do pedido à versão nova só para observar, sem entregar a resposta dela ao cliente. |
| Retry e timeout | Retry é tentar de novo um pedido que falhou. Timeout é o tempo máximo de espera antes de desistir. |
| Circuit breaking | O disjuntor: parar de enviar pedidos a um destino que está falhando, para não piorar a situação. |
| mTLS | As duas pontas mostram o crachá uma à outra antes de conversar, e a conversa é em código. |
| PeerAuthentication e AuthorizationPolicy | A primeira exige crachá na conversa. A segunda é a lista de quem, com crachá, pode pedir o quê. |
| Tracing distribuído | Um número de protocolo que acompanha um pedido por todos os setores, para ver onde ele demorou mais. |
| SLA e SLO | SLA é a promessa escrita ao cliente, com consequências se falhar. SLO é a meta interna, em geral mais rigorosa. |
| Orçamento de erro | A quantidade de falha que a meta permite no período, como um limite de faltas. |
| SPOF | Um ponto único de falha: a única chave de uma porta. Se ela se perde, ninguém entra. |
| Ativo-passivo e ativo-ativo | Uma recepção principal com uma reserva parada, ou duas recepções trabalhando juntas. |
| VRRP, Keepalived e IP virtual | Dois atendentes combinam um número de telefone compartilhado. O telefone toca no que está de plantão e passa para o outro se ele sair. |
| RTO e RPO | O tempo máximo aceito para voltar a atender e a quantidade máxima de informação (medida em tempo) que se aceita perder. |
| HA e DR | HA é manter o atendimento quando uma peça falha. DR é o plano para recomeçar depois de um desastre grande, como a perda de todo o prédio. |
| Chaos engineering | Um simulado de incêndio: provocar uma falha controlada, com hipótese e hora para parar, para ver se o plano funciona. |
| WAF | Segurança de portaria que lê o conteúdo do pedido procurando golpes conhecidos, além de conferir documentos. |
| ModSecurity e OWASP CRS | O mecanismo que aplica as regras de segurança e o livro de regras mantido pela comunidade. |
| Pontuação de anomalia e modo de detecção | Cada suspeita soma pontos e só quem passa de um limite é barrado. No modo de detecção, o segurança apenas anota o que barraria, sem barrar, para calibrar. |
| Rate limiting | Um limite de quantos pedidos por minuto cada pessoa pode fazer. |
| HSTS | O aviso que o site dá ao navegador: "daqui para a frente, só fale comigo pela via segura". |
| Defesa em camadas | Várias barreiras em sequência (portaria, catraca, porta), de modo que a falha de uma não deixe tudo exposto. |
Onde a comparação para
14
A comparação ajuda a fixar quem faz o quê na borda, mas não é uma equivalência perfeita. Estes são os pontos em que a F1 deixa de valer para cada etapa:
- Etapa 01: na equipe, a recepção e os engenheiros são pessoas diferentes por natureza; no software, a aplicação pode atender direto a internet (um Node.js na porta 3000, sem nada na frente), e separar o servidor web da aplicação é uma decisão de arquitetura, não algo dado.
- Etapa 02: o rádio de voz é conduzido por pessoas que lembram da conversa e pedem para repetir; o HTTP é sem estado, cada requisição chega sem memória das anteriores, e o contexto do usuário precisa vir de cookie ou sessão. A troca do TCP pelo QUIC no HTTP/3, que limita o atraso de um pacote perdido ao stream afetado, não tem equivalente no rádio de voz.
- Etapa 03: o bilhete que a recepção anexa é confiável porque só ela o escreve; o X-Forwarded-For pode ser forjado pelo próprio cliente, e o backend só deve confiar nele quando vier de um proxy conhecido. Além disso, o visitante sabe que fala com uma recepção, enquanto o reverse proxy é transparente para o cliente.
- Etapa 04: na recepção, o limite é o número de pessoas e salas; no Apache, o MPM é escolhido na configuração, só um fica ativo por vez, e o limite é a memória de cada processo. No Worker e no Event, um erro grave numa thread pode derrubar o processo filho inteiro e as conexões que ele atendia, e a exigência de módulos thread-safe não tem par numa equipe de pessoas.
- Etapa 05: um atendente que anota pedidos precisa lembrar de cada um; o worker do Nginx recebe do kernel (epoll) a lista do que ficou pronto, e o limite passa a ser CPU, memória e descritores de arquivo. Como proxy, cada cliente ocupa duas conexões (uma com o cliente e outra com o backend), conta que não aparece na recepção.
- Etapa 06: os analistas são pessoas com ritmos diferentes; os backends de um upstream são cópias idênticas da mesma aplicação. O ip_hash agrupa clientes pelo endereço, então muitos usuários atrás do mesmo NAT ou VPN caem num backend só, e a recomendação é guardar a sessão fora do backend (Redis ou token assinado), ao contrário do analista, que guarda o histórico na própria mesa.
- Etapa 07: o radio check é uma chamada ativa feita por pessoas; no Nginx Open Source a verificação é só passiva, a partir de requisições reais (max_fails e fail_timeout), e o Nginx tenta outro backend sozinho em caso de erro de conexão ou timeout. A distinção entre 502 (resposta inválida ou conexão recusada) e 504 (resposta que não chegou a tempo) não tem equivalente.
- Etapa 08: a folha de encaminhamento é lida por pessoas que interpretam uma regra ambígua; no Ingress, o pathType (Prefix, Exact) define a correspondência exata, as annotations valem para o Ingress inteiro, e com mais de um Controller o ingressClassName escolhe quem lê cada folha. Se o Service de destino não tem Pods prontos, o Ingress não tem para onde encaminhar.
- Etapa 09: a credencial do paddock é um objeto físico conferido por pessoas; o certificado é verificado por software a cada conexão, a chave privada fica num Secret que é só codificado em base64 (a proteção vem do RBAC), e a prova de controle do domínio (HTTP-01 ou DNS-01) não tem equivalente no credenciamento.
- Etapa 10: o rádio de cinto é entregue a cada pessoa no começo do dia; o sidecar só é injetado na criação do Pod, então Pods que já existiam precisam ser recriados para entrar na malha. E cada sidecar consome CPU e memória e soma latência a cada salto, custo que, com poucos serviços, pode não compensar.
- Etapa 11: com dois carros, a peça nova vai para metade da equipe; o VirtualService divide o tráfego por pesos exatos que somam 100, ou por header, cookie ou path. Repetir uma mensagem no rádio não sobrecarrega ninguém, enquanto retries sem limite multiplicam a carga sobre um serviço que já falha, e por isso existe o circuit breaking, que ejeta endpoints com falhas seguidas.
- Etapa 12: a gravação do intercom já sai completa e com horário; no tracing distribuído, a aplicação precisa propagar os headers de rastreamento em cada chamada seguinte, e sem isso o trace quebra mesmo com os sidecars saudáveis. E uma AuthorizationPolicy ALLOW nega com HTTP 403 tudo o que não casa com uma regra, sem o bom senso de quem administra um canal.
- Etapa 13: na garagem, basta o equipamento reserva estar ligado no mesmo canal; com VRRP, os dois balanceadores trocam anúncios o tempo todo, o de maior prioridade com saúde confirmada responde pelo IP virtual, a configuração dos dois precisa ser mantida igual por automação, e em muitas redes de nuvem o VRRP não funciona como numa rede local. As contas de disponibilidade (componentes em série multiplicam, réplicas independentes em paralelo melhoram) não têm par direto.
- Etapa 14: a segurança da hospitalidade reconhece um comportamento que nunca viu; o WAF só pontua padrões descritos nas regras do CRS, níveis de paranoia maiores trazem mais falsos positivos, e ele não corrige a falha no código, só reduz a exposição. O rate limiting conta por IP, então usuários atrás do mesmo NAT dividem o mesmo limite, e ele não protege contra um ataque distribuído em que cada origem envia pouco.
Etapa 01 papel do servidor web
Para que serve um servidor web
O problema
Uma equipe publica uma aplicação Node.js e a deixa atendendo diretamente na porta 3000, sem nada na frente dela. No começo funciona bem. Conforme o produto cresce, aparecem dores que não têm relação com a regra de negócio. As imagens e os arquivos CSS e JavaScript do site passam a competir pelo mesmo processo que executa a lógica da aplicação, e tudo fica mais lento.
Chega a hora de renovar o certificado HTTPS, e como ele está configurado dentro do código, a renovação exige mexer na aplicação e reiniciar o processo mesmo sem nenhuma mudança de regra de negócio. O tráfego sobe e uma única instância não aguenta mais, mas distribuir o tráfego entre réplicas vira uma decisão manual a cada requisição. Por fim, um bot começa a fazer scraping agressivo do catálogo, e não existe camada nenhuma filtrando esse tráfego antes de ele bater direto na aplicação.
Todos esses problemas são de infraestrutura de borda, não de regra de negócio. Resolvê-los dentro do código da aplicação mistura responsabilidades que deveriam estar separadas, e é exatamente esse conjunto de responsabilidades que um servidor web como o Apache HTTP Server ou o Nginx assume.
O conceito
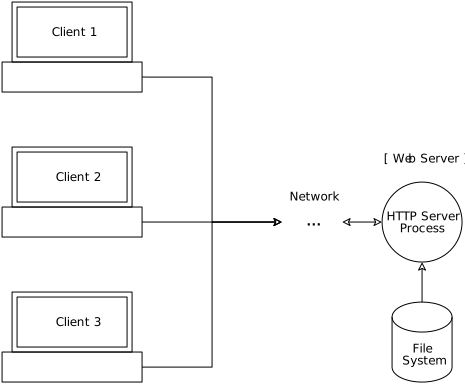
Um servidor web é o ponto por onde toda requisição HTTP entra antes de chegar (ou não) à aplicação. A aplicação, também chamada de backend ou servidor de aplicação (Node.js, PHP-FPM, Tomcat, Gunicorn), executa a lógica de negócio. O servidor web cuida de tudo o que está ao redor dela. Um servidor web moderno assume, tipicamente, seis funções:
- Servir conteúdo estático: entrega HTML, CSS, JavaScript, imagens e vídeos direto do disco, sem acionar código de aplicação.
- Fazer proxy para aplicações dinâmicas: encaminha requisições para PHP-FPM, Tomcat, Node.js, Gunicorn e similares.
- Balancear carga: distribui as requisições entre vários servidores de aplicação.
- Terminar TLS: gerencia certificados e criptografia em um ponto central, em vez de espalhar essa tarefa por cada instância.
- Fazer cache: guarda respostas já produzidas para entregá-las mais rápido depois, sem repetir o trabalho.
- Controlar acesso e segurança: filtra tráfego malicioso e aplica autenticação antes que o ataque chegue perto da aplicação.
O Apache HTTP Server teve seu primeiro lançamento em 1995, então a categoria tem mais de três décadas de uso. Quando o servidor web responde antes de qualquer aplicação existir (por exemplo, um 404 para um arquivo inexistente), ele mostra que é uma camada própria, e o cabeçalho Server da resposta identifica qual software atendeu. As etapas seguintes aprofundam cada função: proxy na Etapa 03, MPMs do Apache na Etapa 04, arquitetura do Nginx na Etapa 05 e balanceamento na Etapa 06.
Os conceitos-chave
Servidor web
software na borda que recebe as requisições HTTP e decide se responde sozinho ou encaminha à aplicação.
Backend
o processo que executa a regra de negócio; não deveria cuidar de TLS, arquivos estáticos nem filtragem de tráfego.
Conteúdo estático
arquivo pronto servido direto do disco, sem código de aplicação.
Proxy para aplicação dinâmica
o servidor web repassa ao backend o que só ele sabe responder.
Terminação TLS
a criptografia é aberta em um único ponto, e a renovação de certificado deixa de tocar na aplicação.
Cabeçalho Server
identifica o software que respondeu e permite descobrir rapidamente quem está na frente.
Um servidor web mínimo e o cabeçalho Server
O bloco abaixo mostra a sintaxe de uma configuração Nginx que serve uma página estática. Ele é ilustrativo: a imagem oficial do Nginx já sobe com uma configuração equivalente, então você não precisa criar este arquivo para fazer o exercício desta etapa.
# default.confserver {listen 80; # a porta que o Nginx escutaserver_name localhost; # o nome que este bloco atendelocation / { # regra para todas as URLs que começam com "/"root /usr/share/nginx/html; # a pasta onde estão os arquivos estáticosindex index.html; # arquivo servido quando a URL termina em "/"}}
Cada location é uma regra de roteamento. Aqui não há aplicação nenhuma por trás: é conteúdo estático servido diretamente pelo servidor web. O comando curl -I mostra só os cabeçalhos da resposta, e o Server revela quem atendeu.
Comandos essenciais desta etapa
stable é móvel; fixe a versão quando precisar reproduzir um resultado)Mão na massa
- Suba os dois containers:
docker run -d --name nginx-lab -p 8080:80 nginx:stableedocker run -d --name apache-lab -p 8081:80 httpd:2.4. - Rode
curl -I http://localhost:8080ecurl -I http://localhost:8081. Observe o cabeçalhoServerde cada um e o200 OK. - Peça um caminho que não existe (
curl -I http://localhost:8080/nao-existe) e observe o404 Not Found. Essa resposta veio do servidor web, sem nenhuma aplicação ter sido acionada. - Rode
docker logs nginx-labe observe as linhas de acesso com as suas requisições, inclusive a que resultou em 404. - Limpe:
docker rm -f nginx-lab apache-lab.
Dica: Use curl -I para inspecionar só os cabeçalhos. É o jeito mais rápido de descobrir qual servidor está respondendo antes de aprofundar uma investigação. Lembre que o cabeçalho Server também informa a versão do software, o que é útil para você e para quem ataca; a Etapa 14 mostra como ocultar a versão.
Anota aí: Um servidor web não executa a regra de negócio: ele cuida de tudo ao redor dela (estático, proxy, TLS, cache, segurança) para que a aplicação não precise cuidar disso.
Etapa 02 evolução do protocolo
HTTP e sua evolução, de 1.1 a HTTP/3
O problema
Duas cenas explicam por que o HTTP precisou evoluir. Na primeira, a página de um produto de e-commerce carrega o HTML principal e mais 40 miniaturas de imagem. Mesmo com conexões persistentes (keep-alive), o HTTP/1.1 processa uma requisição de cada vez dentro de uma conexão: a segunda imagem só começa a baixar depois que a resposta da primeira terminar de chegar. Os navegadores contornam parcialmente isso abrindo várias conexões TCP em paralelo com o mesmo domínio (em geral cerca de seis), mas isso apenas troca um custo por outro, porque agora há várias conexões para gerenciar.
Na segunda cena, mesmo com a primeira resolvida, um usuário em uma rede móvel instável ainda sente lentidão. Basta um único pacote se perder no caminho para que o carregamento inteiro trave até a retransmissão chegar, mesmo que todos os outros pacotes já tenham chegado ao destino.
A primeira cena motivou o HTTP/2. A segunda motivou o HTTP/3.
O conceito
Antes das versões, um fato estrutural: o HTTP é um protocolo sem estado (stateless). Cada requisição é tratada de forma independente, sem memória das anteriores. Isso simplifica a escala, mas exige mecanismos por cima do protocolo (cookies e sessões) para manter o contexto de um mesmo usuário.
- HTTP/1.1 (1997): introduziu conexões persistentes (keep-alive), permitindo várias requisições e respostas na mesma conexão TCP e reduzindo o custo de abrir uma conexão nova por recurso. A limitação é o head-of-line blocking: se a primeira requisição demora, as seguintes na mesma conexão esperam.
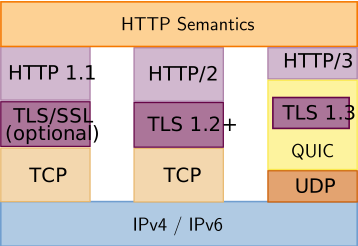
- HTTP/2 (2015): resolve o head-of-line blocking da primeira cena, na camada de aplicação. Várias requisições e respostas (streams) trafegam ao mesmo tempo pela mesma conexão TCP, sem uma bloquear a outra. Também trouxe priorização de recursos, compressão de cabeçalhos (HPACK) e o Server Push, que caiu em desuso porque os principais navegadores removeram ou restringiram o suporte, já que o ganho raramente compensava a complexidade. Na web, o HTTP/2 é usado sobre TLS, e cliente e servidor combinam a versão durante o handshake TLS (extensão ALPN).
- HTTP/3 (QUIC sobre UDP): o HTTP/2 resolveu o problema na aplicação, mas o TCP garante que os bytes cheguem em ordem estrita. Se um pacote se perde, tudo o que veio depois dele espera a retransmissão, mesmo que pertença a outro stream. O HTTP/3 troca o TCP pelo QUIC, que roda sobre UDP: cada stream é independente, e a perda de um pacote só atrasa o stream afetado. O QUIC também combina o handshake de transporte com o de TLS 1.3, o que tende a estabelecer a conexão mais rápido. O ganho é maior em redes com perda de pacotes ou latência alta, como conexões móveis.
Na prática, o cliente descobre que o servidor oferece HTTP/3 pelo cabeçalho de resposta Alt-Svc. Redes que bloqueiam UDP na porta 443 fazem o cliente voltar para HTTP/2 ou HTTP/1.1.
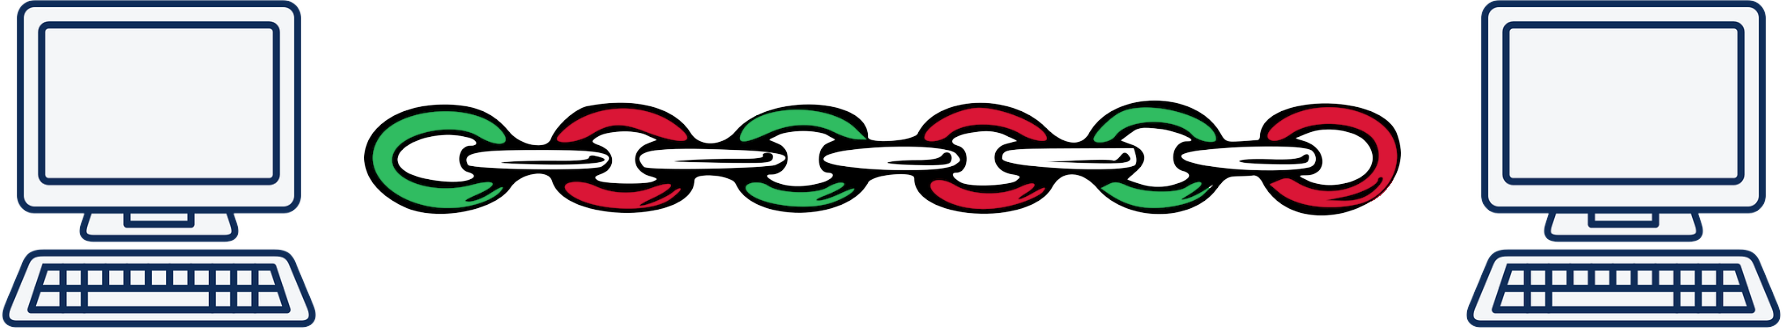
HTTP/2: os streams vermelho e verde dividem a mesma conexão TCP. Se um elo se perde, tudo o que vem depois dele espera a retransmissão, seja de qual stream for.
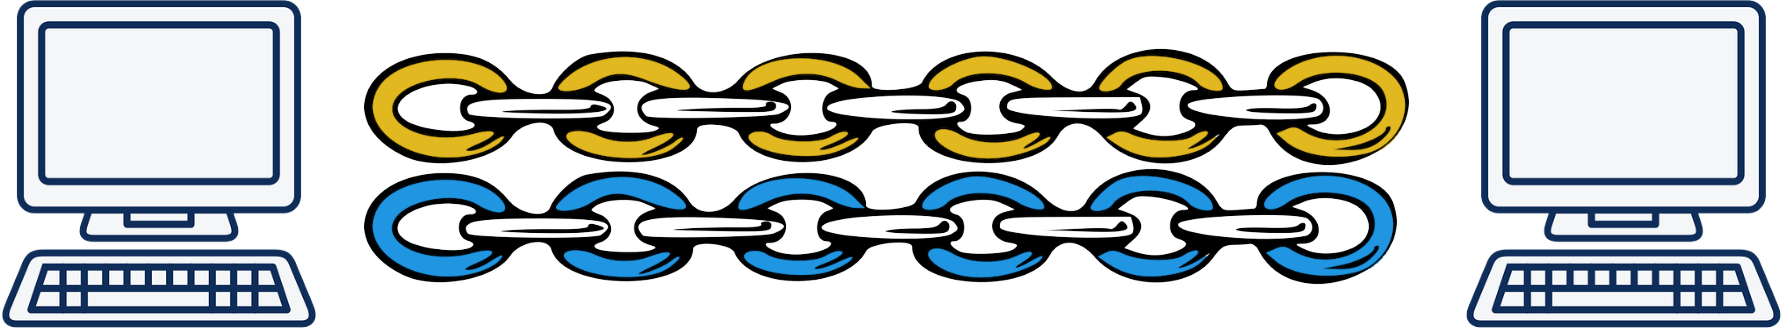
HTTP/3: no QUIC, cada stream é uma corrente independente, e a perda de um elo só atrasa a corrente em que ele estava.
Os conceitos-chave
Stateless
cada requisição é independente; cookies e sessões simulam contexto por cima.
Keep-alive (HTTP/1.1)
reaproveita a conexão TCP, mas atende uma requisição por vez nela.
Head-of-line blocking
um item lento segura os que vêm depois dele na mesma fila.
Multiplexação (HTTP/2)
vários streams na mesma conexão TCP; resolve o bloqueio na aplicação.
QUIC (HTTP/3)
streams independentes sobre UDP; resolve o bloqueio no transporte.
ALPN e Alt-Svc
ALPN negocia h2 durante o handshake TLS; Alt-Svc anuncia o HTTP/3.
Perguntando ao curl qual versão foi negociada
# Deixa o curl negociar livremente e mostra a versão usada (saída aproximada)$ curl -so /dev/null -w 'Protocolo negociado: HTTP/%{http_version}\n' https://www.cloudflare.comProtocolo negociado: HTTP/2# Força HTTP/1.1, mesmo que o servidor suporte versões mais novas$ curl --http1.1 -so /dev/null -w 'Protocolo negociado: HTTP/%{http_version}\n' https://www.cloudflare.comProtocolo negociado: HTTP/1.1# Força HTTP/3 (exige um curl compilado com suporte a QUIC)$ curl --http3 -so /dev/null -w 'Protocolo negociado: HTTP/%{http_version}\n' https://www.cloudflare.comProtocolo negociado: HTTP/3
Nem todo curl vem com suporte a HTTP/3 (depende de uma biblioteca QUIC). Rode curl --version | grep -i http3 para conferir antes de usar --http3. Os resultados dependem de o domínio escolhido suportar cada versão e de a sua rede permitir UDP. Para ver a negociação acontecer em um servidor seu, sem depender da internet, suba um Nginx com HTTP/2 usando um certificado autoassinado.
Comandos essenciais desta etapa
h2.conf não aparece depois do reloadMão na massa
- Escolha um domínio que suporte HTTP/2 (por exemplo,
www.cloudflare.com) e rode os dois primeiros comandos do exemplo. Observe o valor de%{http_version}mudando conforme a flag. - Rode
curl -v --http2 https://www.cloudflare.com 2>&1 | grep -i "HTTP/2"e observe a linha que confirma a versão negociada no handshake. - Se o seu curl tiver suporte a HTTP/3, repita com
--http3e compare-w '%{time_total}\n'nas três variantes. Não espere uma diferença grande em uma rede estável. - Gere o certificado, crie
h2.confe suba oh2-lab. ObserveHTTP/2na primeira chamada eHTTP/1.1com--http1.1. - Apague a linha
http2 on;doh2.conflocal e rodedocker exec h2-lab nginx -s reload. Repita ocurlsem flag e observe que a versão volta a serHTTP/1.1, porque o servidor deixou de oferecer h2 no handshake. Atenção: o arquivo é montado individualmente no container, e alguns editores e osed -isubstituem o arquivo por um novo em vez de alterar o original. Nesse caso o container continua vendo a versão antiga e oreloadparece não fazer nada; rodedocker restart h2-labe repita o teste. - Limpe:
docker rm -f h2-lab.
Dica: O HTTP/2 eliminou a fila na camada de aplicação, e o HTTP/3 resolveu o mesmo problema na camada de transporte. Ao diagnosticar lentidão, pergunte primeiro em qual camada a espera acontece.
Anota aí: Cada versão do HTTP resolveu o head-of-line blocking em uma camada diferente: o HTTP/2 na aplicação, com multiplexação, e o HTTP/3 no transporte, trocando TCP por QUIC sobre UDP.
Etapa 03 intermediários
Forward proxy e reverse proxy
O problema
Duas necessidades simétricas, uma do lado do cliente e outra do lado do servidor. No lado do cliente, uma empresa quer que todo o tráfego de saída dos funcionários passe por um ponto de controle único, para bloquear sites indesejados, registrar acessos por conformidade e evitar que o IP interno de cada máquina fique exposto diretamente à internet.
No lado do servidor, a mesma empresa mantém cinco servidores de aplicação atrás de um único domínio público. Não faz sentido expor o IP de cada servidor, repetir a configuração do certificado TLS em cada um deles, nem deixar cada servidor decidir sozinho se aguenta mais uma conexão.
São duas necessidades diferentes com uma peça em comum: um intermediário entre quem pede e quem responde. A diferença está em qual lado o intermediário representa e protege.
O conceito
Forward proxy, o intermediário de saída. Fica entre um cliente (geralmente em uma rede privada) e a internet, e é configurado explicitamente no lado do cliente (navegador, sistema operacional ou aplicação). O fluxo é este: o cliente envia a requisição ao proxy indicando o destino; o proxy analisa e decide se encaminha ou bloqueia; se encaminha, faz a requisição em nome do cliente; a resposta volta ao proxy, que a repassa ao cliente. Para HTTPS, o cliente pede ao proxy um túnel (método CONNECT), e o proxy só enxerga o conteúdo se fizer inspeção de TLS. Casos de uso: segurança e conformidade, controle de conteúdo, anonimato (mascarar o IP do cliente) e cache. O Squid é um exemplo de software que cumpre esse papel.
Reverse proxy, o intermediário de entrada. Fica na borda da infraestrutura, recebe as requisições da internet e as distribui para os servidores de aplicação atrás dele. É transparente para o cliente, que nem sabe que ele existe. O fluxo: o cliente envia a requisição ao IP público do proxy; com base em regras, o proxy escolhe o backend; encaminha a requisição; o backend responde ao proxy; o proxy entrega a resposta ao cliente. Funções principais: balanceamento de carga, terminação TLS centralizada (tirando essa carga dos backends), cache, uma primeira camada de segurança, compressão (Gzip ou Brotli) e roteamento entre serviços. Sobre a segurança, o proxy puro filtra certos padrões de tráfego, mas bloquear ataques como XSS normalmente exige regras de WAF (Etapa 14).
A regra prática para distinguir os dois: pergunte quem configurou o apontamento para o intermediário. Se foi o cliente, é forward proxy. Se foi a infraestrutura do servidor e o cliente não sabe, é reverse proxy.
Há uma consequência para o backend: ele só enxerga o proxy abrindo a conexão. Para saber quem fez o pedido de verdade, o proxy repassa o IP do cliente em cabeçalhos como X-Real-IP e X-Forwarded-For (não padronizados, mas amplamente usados; o cabeçalho padronizado é o Forwarded). O backend só deve confiar nesses cabeçalhos quando vierem de um proxy conhecido, porque um cliente pode enviá-los forjados.
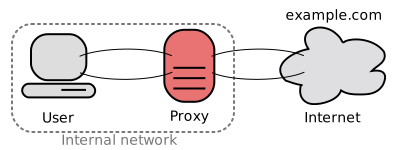
Forward proxy: o proxy fica na rede do cliente, e é o cliente que o usa para sair. O site externo só enxerga o proxy.
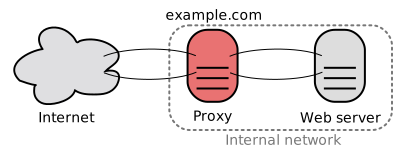
Reverse proxy: o proxy fica na rede do servidor, e quem vem da internet fala só com ele, sem saber qual servidor respondeu.
Os conceitos-chave
Forward proxy
do lado do cliente, configurado por ele, representa o cliente perante a internet.
Reverse proxy
do lado do servidor, configurado pela infraestrutura, transparente ao cliente.
upstream
o grupo de backends para onde o reverse proxy encaminha.
proxy_pass
a diretiva do Nginx que encaminha a requisição ao backend.
X-Real-IP e X-Forwarded-For
cabeçalhos que carregam o IP do cliente original até o backend.
Host
sem proxy_set_header Host, o Nginx envia ao backend o nome do upstream, e não o domínio que o cliente usou.
Reverse proxy Nginx e forward proxy Squid no mesmo laboratório
Primeiro, um backend didático em Python (só biblioteca padrão). Ele devolve o próprio nome, o caminho recebido e, em /headers, os cabeçalhos que chegaram e o IP de quem abriu a conexão. Este mesmo backend.py será reaproveitado nas etapas seguintes.
# backend.pyimport osimport timefrom http.server import BaseHTTPRequestHandler, ThreadingHTTPServerNAME = os.environ.get("NAME", "backend") # nome devolvido nas respostasPORT = int(os.environ.get("PORT", "3000")) # porta de escutaDELAY = float(os.environ.get("DELAY", "0")) # atraso artificial, em segundosclass Handler(BaseHTTPRequestHandler):protocol_version = "HTTP/1.1" # permite conexões persistentesdef responder(self, com_corpo):if self.path == "/slow":time.sleep(10) # simula um backend travadoelif self.path != "/healthz":time.sleep(DELAY) # simula um backend lentoif self.path.endswith("/headers"):linhas = [f"peer: {self.client_address[0]}"] # quem abriu a conexão TCPlinhas += [f"{k}: {v}" for k, v in self.headers.items()]corpo = "\n".join(linhas) + "\n"else:corpo = f"{NAME} recebeu {self.path}\n"dados = corpo.encode()self.send_response(200)self.send_header("Content-Length", str(len(dados)))self.end_headers()if com_corpo: # HEAD não envia corpoself.wfile.write(dados)def do_GET(self):self.responder(True)def do_HEAD(self):self.responder(False)ThreadingHTTPServer(("0.0.0.0", PORT), Handler).serve_forever()
Comandos essenciais desta etapa
nginx.conf não aparece depois do reloadMão na massa
- Crie a pasta
etapa03/combackend.py,nginx.conf,squid.confecompose.yaml, e rodedocker compose up -d. Confirme os três serviços comdocker compose ps. - Rode
curl -s http://localhost:8080/headerse observeX-Real-IP,X-Forwarded-ForeHost: localhost. Em seguida rodecurl -sI http://localhost:8080/e observeServer: nginx, mesmo com o conteúdo vindo do Python. - Apague a linha
proxy_set_header Host $host;donginx.conf, rodedocker compose exec nginx nginx -s reloade repita o/headers. ObserveHost: backend_app, o nome do upstream, em vez do domínio que o cliente pediu. Atenção: onginx.confé montado como arquivo único, e alguns editores e osed -io substituem por um arquivo novo, o que deixa o container vendo a versão antiga. Se a mudança não aparecer depois do reload, rodedocker compose restart nginx. - Restaure a linha, apague
proxy_set_header X-Real-IP $remote_addr;, recarregue e repita. Observe queX-Real-IPdesaparece, mas oX-Forwarded-Forcontinua trazendo o IP do cliente, e quepeermostra o IP do Nginx (opeersempre foi o Nginx, porque é ele quem abre a conexão com o backend). Apague também a linha doX-Forwarded-For, recarregue e repita: sem os dois cabeçalhos, o backend só enxerga o Nginx. - Restaure as linhas e rode
curl -s -x http://localhost:3128 http://backend:3000/headers. Observe os cabeçalhosViaeX-Forwarded-Foracrescentados pelo Squid. Compare comcurl -s http://backend:3000/, que falha ao resolver o nome. - Limpe:
docker compose down.
Dica: Para saber de que lado você está, pergunte quem configurou o apontamento: se foi o cliente, é forward proxy; se o cliente não sabe que o intermediário existe, é reverse proxy. Em produção, configure o backend para confiar em X-Forwarded-For apenas quando a conexão vier do seu proxy, porque o cabeçalho pode ser forjado por qualquer cliente.
Anota aí: O forward proxy fica do lado do cliente e é configurado por ele; o reverse proxy fica do lado do servidor e é invisível ao cliente, e o IP original só chega ao backend se o proxy o repassar em cabeçalhos.
Etapa 04 processos + threads
Apache HTTP Server e os modelos de processamento (MPMs)
O problema
Primeiro cenário: um e-commerce roda Apache com o modelo mais antigo de processamento e recebe um pico de 5.000 conexões simultâneas em uma promoção. Como cada conexão ganha um processo do sistema operacional inteiramente próprio, o servidor tenta abrir milhares de processos, cada um consumindo dezenas de megabytes só para existir. A memória se esgota, o sistema começa a usar swap em disco e o site trava justamente no pico de vendas.
Segundo cenário, oposto: a mesma empresa depende de um módulo antigo, escrito sem cuidado de concorrência (não thread-safe), que precisa continuar funcionando. Trocar para um modelo baseado em threads que compartilham memória faria esse módulo corromper dados ou derrubar o processo de forma imprevisível.
Um cenário pede leveza para escalar, o outro pede isolamento total para sobreviver. O Apache resolve essa tensão deixando você escolher o modelo de concorrência, os MPMs (Multi-Processing Modules).
O conceito
Antes dos modelos, dois termos. Um processo tem memória própria e isolada dos demais; se ele falha, os outros seguem. Uma thread vive dentro de um processo e compartilha a memória dele com as outras threads, o que a torna mais leve e mais perigosa: um erro grave em uma thread pode corromper o processo inteiro. Código que funciona corretamente quando várias threads o executam ao mesmo tempo é chamado de thread-safe.
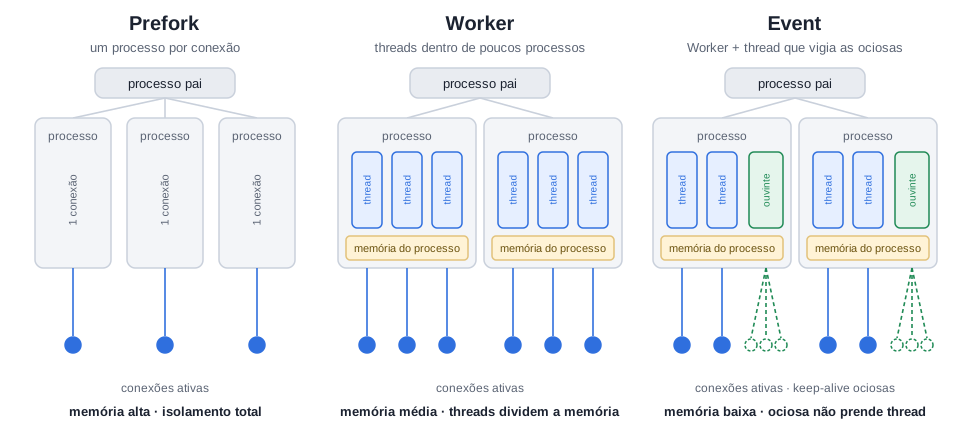
- Prefork (sem threads): um processo filho independente atende cada conexão, completamente isolado dos demais. Vantagens: muito estável (um problema em um processo não afeta os outros), compatível com módulos não thread-safe e com software legado. Desvantagens: alto consumo de memória e pouca escalabilidade sob alta concorrência. É comum ver o Prefork com o
mod_php(PHP embutido no processo do Apache, historicamente não thread-safe). A alternativa é rodar o PHP como processo separado, o PHP-FPM, com o Apache falando com ele por proxy (mod_proxy_fcgi, o mesmo conceito da Etapa 03), o que permite usar um MPM mais leve sem perder compatibilidade. - Worker (com threads): cria vários processos filhos, cada um com várias threads, e cada thread atende uma conexão. Usa menos memória que o Prefork e suporta mais concorrência. Como as threads de um processo compartilham memória, um erro grave em uma delas pode derrubar o processo filho que a hospeda e as conexões que ele atendia; os demais filhos e o processo mestre continuam de pé. Por isso os módulos precisam ser thread-safe.
- Event (recomendado para a maioria dos deployments novos): parte do Worker, mas otimizado para o caso comum de conexões keep-alive abertas e ociosas. Uma thread dedicada consegue vigiar várias conexões que só estão esperando, sem prender uma thread de trabalho a cada conexão parada. Mantém a exigência de módulos thread-safe e é o MPM indicado para HTTP/2, que o Apache oferece pelo módulo
mod_http2(habilitado coma2enmod http2eProtocols h2 http/1.1).
Dois pontos de leitura da comparação: o consumo de memória cresce na ordem Event, Worker, Prefork, e a concorrência suportada cresce na ordem inversa. A escolha, portanto, é sempre uma troca entre isolamento e eficiência.
Os conceitos-chave
MPM
o módulo que define como o Apache atende conexões em paralelo (processos, threads ou ambos).
Prefork
um processo por conexão; isolamento total, memória alta, concorrência baixa; serve a módulos não thread-safe.
Worker
poucos processos com várias threads; memória média, concorrência alta; exige módulos thread-safe.
Event
como o Worker, mas não prende uma thread a conexões keep-alive ociosas; memória baixa, concorrência muito alta.
Thread-safe
código que tolera execução simultânea por várias threads no mesmo processo.
PHP-FPM
PHP como processo separado, que permite sair do Prefork sem abandonar PHP.
Descobrindo e trocando o MPM ativo
Em um Apache instalado no host (Debian ou Ubuntu), apachectl e a2query informam o MPM ativo, e a2dismod e a2enmod fazem a troca.
# Mostra o MPM em uso (saída resumida)$ apachectl -V | grep -i mpmServer MPM: event# Em Debian e Ubuntu, a2query mostra o módulo MPM habilitado$ sudo a2query -Mevent# Troca para o Prefork (por exemplo, para rodar um módulo legado não thread-safe)$ sudo a2dismod mpm_event # desabilita o MPM atual$ sudo a2enmod mpm_prefork # habilita o Prefork$ sudo systemctl restart apache2$ sudo a2query -Mprefork
Em distribuições baseadas em RHEL, a troca é feita comentando e descomentando as linhas LoadModule mpm_*_module em /etc/httpd/conf.modules.d/00-mpm.conf, e o serviço se chama httpd.
Comandos essenciais desta etapa
httpd -V)Mão na massa
- Crie a pasta
etapa04/com oDockerfileacima, construa as duas imagens e suba os dois containers como no exemplo. - Confirme o MPM de cada um com
docker exec <container> httpd -M | grep mpm. Observempm_event_moduleempm_prefork_module. - Em um terminal, rode
ab -n 50000 -c 100 http://localhost:8082/(Prefork). Em outro, rode várias vezesdocker top apache-prefork | grep -c httpddurante o teste e observe o número de processos crescer. - Repita o passo 3 contra
http://localhost:8081/(Event) eapache-event. Observe que o número de processos fica pequeno, porque cada processo comporta várias threads. Compare tambémdocker stats --no-stream apache-event apache-preforkao fim dos testes. Os números exatos variam; o que importa é a diferença de ordem de grandeza nos processos. - Se você tem um Apache instalado no host (
sudo apt install apache2), troque o MPM coma2dismodea2enmod, reinicie o serviço e confirme comsudo a2query -M. - Limpe:
docker rm -f apache-event apache-prefork. As imagensapache-eventeapache-preforkcontinuam no computador e podem ser reaproveitadas na Etapa 05.
Dica: A diferença entre os três MPMs está em processo, thread e isolamento, e é esse critério que orienta a escolha em produção. Antes de trocar de MPM em um servidor real, verifique se todos os módulos carregados são thread-safe, porque essa é a restrição que decide a escolha.
Anota aí: Prefork isola cada conexão em um processo e é o mais pesado; Worker usa threads dentro de poucos processos e exige código thread-safe; Event é o Worker afinado para não gastar uma thread em conexões keep-alive ociosas.
Etapa 05 event loop
Nginx e a arquitetura orientada a eventos
O problema
Uma aplicação mantém muitas conexões simultâneas, de longa duração e quase sempre ociosas: chat em tempo real, notificações push, keep-alive de APIs de aplicativos móveis. Mesmo com o Event MPM reduzindo o custo das conexões ociosas, o Apache continua reservando uma thread para cada requisição que está sendo processada. Escalar para dezenas de milhares de conexões significa escalar, na mesma proporção, o número de threads e a memória que elas consomem, até esbarrar no limite prático de threads que convivem com eficiência.
O Nginx foi desenhado para esse cenário. Enquanto o Apache nasceu como servidor web tradicional e ganhou modelos de concorrência ao longo do tempo, o Nginx já nasceu com uma arquitetura voltada a servir conteúdo estático e a atuar como proxy reverso sob alta concorrência.
O conceito
A diferença central é a arquitetura assíncrona e orientada a eventos, em vez de um processo ou thread dedicado por conexão.
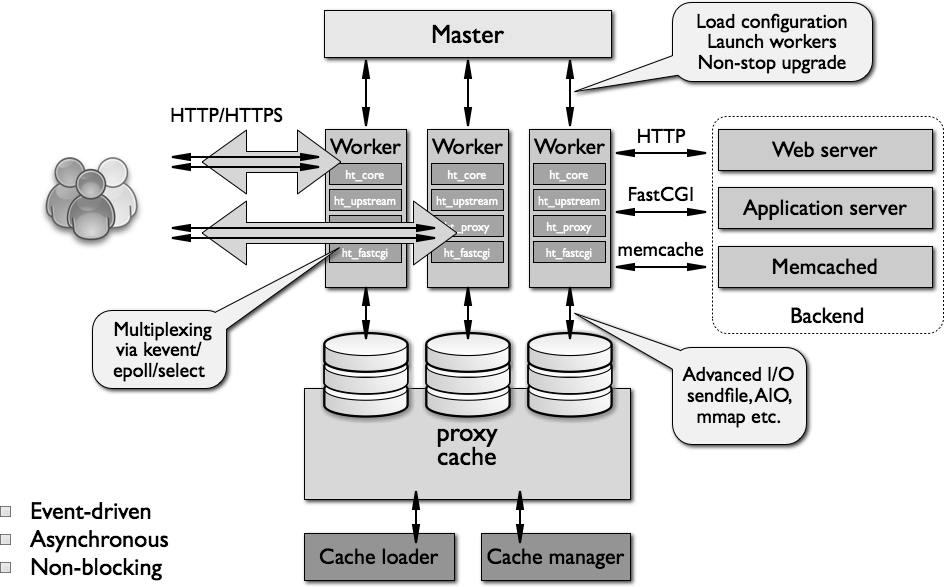
Um processo master lê a configuração e gerencia os processos worker, que são os que atendem conexões (o master não atende requisições). Cada worker roda um event loop: um laço que espera eventos (dado novo em uma conexão, resposta de um backend, escrita liberada), trata o que ficou pronto e volta ao laço. Quando uma operação de entrada e saída precisaria esperar (ler do disco, aguardar um backend), o worker não fica parado: ele registra o interesse naquele evento e passa a tratar outra conexão. Isso é I/O não bloqueante. Quando o evento fica pronto, o worker é notificado e retoma exatamente de onde parou.
No Linux, a notificação de quais conexões têm dado novo vem de um mecanismo do kernel, o epoll, que evita varrer todas as conexões a cada ciclo. O Nginx escolhe o método mais eficiente disponível sozinho, então a diretiva use epoll; costuma ser opcional no Linux.
O resultado prático é que o número de processos fica estável e pequeno (em geral um worker por núcleo de CPU), enquanto o número de conexões cresce. O limite deixa de ser "uma thread por conexão" e passa a ser CPU, memória e descritores de arquivo. Benefícios: menor consumo de memória, maior vazão, boa latência e desempenho excelente como proxy reverso e balanceador, inclusive na frente do próprio Apache. Cuidado com a conta de capacidade: worker_processes vezes worker_connections é o teto de conexões simultâneas, mas, quando o Nginx atua como proxy, cada requisição de cliente usa duas conexões (uma com o cliente e uma com o backend), então o número de clientes simultâneos é cerca de metade desse teto. Além disso, worker_connections não deve passar do limite de arquivos abertos do processo (ajustável com worker_rlimit_nofile).
Os conceitos-chave
Event-driven
poucos processos tratam muitas conexões reagindo a eventos.
I/O não bloqueante
o worker registra o evento e atende outra conexão em vez de esperar.
Event loop
o laço de cada worker que trata os eventos prontos.
master e worker
o master gerencia; os workers atendem; o número de workers costuma igualar o de núcleos (worker_processes auto).
epoll
mecanismo do kernel Linux que avisa quais conexões têm dado novo.
worker_connections
o máximo de conexões simultâneas por worker, contando as conexões com backends.
Poucos processos, muitas conexões
# nginx.conf (trecho principal)worker_processes auto; # um processo worker por núcleo de CPU disponívelevents {worker_connections 1024; # cada worker aceita até 1024 conexões simultâneasuse epoll; # opcional no Linux: o Nginx já escolhe o método mais eficiente}
Em uma máquina de 4 núcleos, essa configuração permite, em teoria, até 4096 conexões simultâneas usando apenas 4 workers (mais o master). Se o Nginx estiver atuando como proxy, conte cerca de metade disso em clientes simultâneos.
Comandos essenciais desta etapa
nginx.confMão na massa
- Suba o Nginx de teste com
docker run -d --name nginx-lab -p 8080:80 nginx:stablee rodedocker exec nginx-lab nginx -T | grep -E 'worker_processes|worker_connections'. Observeworker_processes autoeworker_connections 1024. - Rode
docker top nginx-labe conte os processos worker. Compare comnproc: o número de workers costuma ser igual ou próximo ao de núcleos (o container enxerga os núcleos do host). - Rode
ab -n 50000 -c 200 http://localhost:8080/e, durante o teste, repitadocker top nginx-labem outro terminal. Observe que o número de processos não muda, mesmo com 200 conexões simultâneas. - O container
apache-preforkfoi apagado no fim da Etapa 04, então recrie-o comdocker run -d --name apache-prefork -p 8082:80 apache-prefork(a imagem continua no computador; se você a removeu, reconstrua-a comdocker build --build-arg MPM=prefork -t apache-prefork .na pastaetapa04/). Repita a carga emhttp://localhost:8082/e rodedocker top apache-prefork | grep -c httpd. Observe o número de processos crescer junto com a carga, ao contrário do que aconteceu com o Nginx. - Compare o consumo de memória com
docker stats --no-stream nginx-lab apache-prefork. - Opcional, em um Nginx instalado no host (
sudo apt install nginx): rodenginx -teps aux | grep '[n]ginx'e repita os passos 2 e 3 contrahttp://localhost/. - Limpe:
docker rm -f nginx-lab apache-prefork.
Dica: O ponto central é que um worker nunca espera parado: ele registra o evento e segue, e é isso que permite ao Nginx atender muitas conexões sem multiplicar processos. Ao diagnosticar um Nginx saturado, olhe CPU, memória e o limite de arquivos abertos, e não o número de processos, que quase não muda.
Anota aí: O Apache dedica um processo ou thread a cada requisição em andamento (mesmo otimizado pelo Event MPM); o Nginx usa poucos workers com um event loop não bloqueante, e por isso é muito usado como proxy reverso e balanceador na frente de qualquer backend.
Etapa 06 L4 + L7 + algoritmos
Balanceamento de carga: L4, L7 e algoritmos do Nginx
O problema
Uma única instância chega ao limite e a loja começa a perder pedidos na Black Friday. Aumentar CPU e memória da mesma máquina (escala vertical) adia o problema, mas tem teto e continua sendo um único ponto de falha. A saída é a escala horizontal: vários backends idênticos. Surge então uma pergunta que o código da aplicação não responde: quem decide, a cada requisição, qual backend recebe o trabalho? E com qual critério, se um backend é mais forte que o outro, ou se algumas requisições levam um segundo e outras dez milissegundos?
O conceito
Um balanceador de carga distribui as requisições entre os backends. A decisão pode usar pouca ou muita informação, e isso define a camada em que ele trabalha.
- L4 (transporte): decide com IP e porta, sobre TCP ou UDP. É rápido, serve a protocolos genéricos (bancos de dados, por exemplo), mas não consegue rotear por URL, host ou cabeçalho porque nem lê o HTTP. No Nginx, isso é feito pelo módulo
stream. - L7 (aplicação): entende HTTP e HTTPS. Pode terminar TLS, aplicar cache e compressão e rotear por host, path, cabeçalho ou cookie, com uma sobrecarga um pouco maior.
No Nginx, os algoritmos do bloco upstream são:
- Round Robin: o padrão; distribui em sequência. O parâmetro
weightaltera a proporção para servidores com capacidades diferentes (weight=2recebe o dobro). - least_conn: envia a requisição ao backend com menos conexões ativas. É adequado quando as requisições têm durações muito diferentes.
- ip_hash: o mesmo cliente tende a cair sempre no mesmo backend, a partir do endereço IPv4 (usa os três primeiros octetos) ou IPv6 (inteiro). Ajuda aplicações com estado local, mas concentra muitos usuários atrás do mesmo NAT ou VPN em um backend só.
Afinidade como a do ip_hash dificulta a redistribuição e a escalabilidade. Sempre que possível, prefira aplicações stateless: sessão em Redis ou token assinado (como JWT) permitem que qualquer backend responda a qualquer requisição. Duas diretivas completam o quadro: keepalive reaproveita conexões entre o Nginx e os backends (exige proxy_http_version 1.1 e proxy_set_header Connection ""), e os timeouts proxy_connect_timeout, proxy_send_timeout e proxy_read_timeout limitam cada fase da conversa com o upstream.
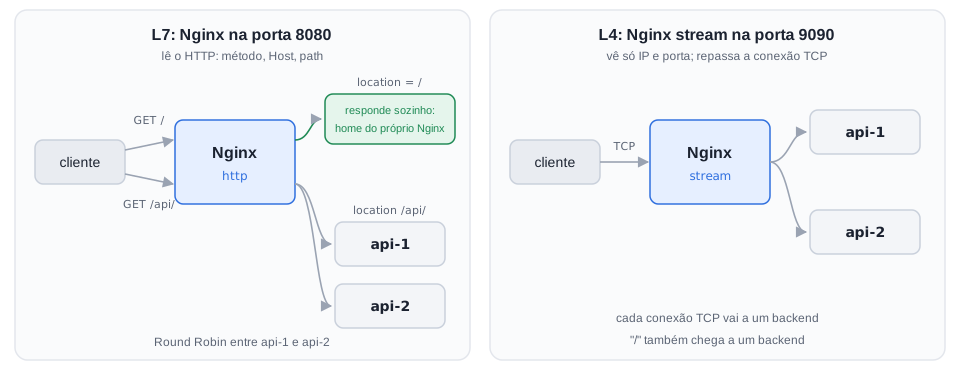
/ não chega aos backends. O L4 só vê IP e porta e repassa cada conexão TCP, então / também chega a um backend.Diagrama: feito para este guiaOs conceitos-chave
L4 e L7
L4 decide por IP e porta (rápido, genérico); L7 entende HTTP (flexível, mais custo).
Round Robin e weight
sequência simples; pesos para capacidades diferentes.
least_conn
favorece quem tem menos conexões ativas; bom para durações heterogêneas.
ip_hash
afinidade pelo IP do cliente; sujeita a desbalanceamento atrás de NAT.
Stateless
sessão externa ou token assinado dispensam afinidade.
keepalive
reaproveita conexões com os backends e reduz o custo de abrir conexões novas.
Um upstream com decisão explícita
O laboratório tem dois backends (api-1 e api-2, o backend.py da Etapa 03), um Nginx L7 na porta 8080 e um Nginx L4 na porta 9090. Copie o backend.py da Etapa 03 para a pasta etapa06/.
# compose.yamlx-backend: &backend # molde reutilizado pelos dois backendsimage: python:3.12-alpinecommand: ["python", "/app/backend.py"] # executa o backend didáticovolumes:- ./backend.py:/app/backend.py:ro # monta o script somente leituraservices:api-1:<<: *backend # herda o molde acimaenvironment:NAME: api-1 # nome devolvido nas respostasDELAY: "${API1_DELAY:-0}" # atraso configurável por variável de ambiente (padrão 0)api-2:<<: *backendenvironment:NAME: api-2nginx: # balanceador L7 (HTTP)image: nginx:stableports:- "8080:80"volumes:- ./nginx.conf:/etc/nginx/conf.d/default.conf:rodepends_on:- api-1- api-2nginx-l4: # balanceador L4 (TCP puro)image: nginx:stableports:- "9090:9090"volumes:- ./nginx-l4.conf:/etc/nginx/nginx.conf:ro # substitui o nginx.conf inteirodepends_on:- api-1- api-2
Comandos essenciais desta etapa
nginx.conf não aparece depois do reload-k usa keep-alive; sem ele, o ab abre uma conexão por requisição)api-1 com 1 segundo de atraso por respostaMão na massa
- Crie
etapa06/combackend.py,compose.yaml,nginx.confenginx-l4.conf, e rodedocker compose up -d. - Com Round Robin, rode
for i in $(seq 1 30); do curl -s http://localhost:8080/api/; done | sort | uniq -c. Observe uma divisão de 15 para 15. - Acrescente
weight=2aapi-1, valide e recarregue (docker compose exec nginx nginx -te depoisnginx -s reload) e repita a contagem. Observe cerca de 20 paraapi-1e 10 paraapi-2. Se a divisão não mudar, o container pode estar vendo a versão antiga do arquivo (editores esed -isubstituem o arquivo montado por um novo); rodedocker compose restart nginxe repita a contagem. - Remova o peso, ative
least_conn;, recarregue e rodeAPI1_DELAY=1 docker compose up -d api-1. Recarregue o Nginx de novo (o IP deapi-1pode ter mudado) e rodeseq 1 20 | xargs -P 10 -I{} curl -s http://localhost:8080/api/ | sort | uniq -c. Observe que o backend lento recebe menos trabalho novo (por exemplo, 5 contra 15; os números variam). - Troque
least_conn;porip_hash;, recarregue e repita a contagem. Observe que todas as respostas vêm do mesmo backend. Explique por quê: pelo mapeamento de portas do Docker, todas as requisições chegam ao Nginx com o mesmo IP de origem (o do gateway da rede). É o efeito de vários usuários atrás de um mesmo NAT. - Compare L4 e L7: rode
curl -s http://localhost:8080/ecurl -s http://localhost:9090/. Observe que só o L7 responde sozinho por uma rota, porque só ele lê o path. - Meça com
ab -n 1000 -c 20 -k http://localhost:8080/api/e anoteRequests per seconde o tempo médio por requisição. Depois descreva em uma frase como Redis ou JWT eliminariam a necessidade doip_hash. - Limpe:
docker compose down.
Dica: Escolha o algoritmo pelo comportamento da carga: Round Robin distribui contagem, least_conn distribui ocupação e ip_hash distribui afinidade. Se você precisa de afinidade para a aplicação funcionar, o problema está no estado guardado dentro do backend, e a solução de longo prazo é tirá-lo de lá.
Anota aí: Balancear não é só espalhar requisições: é escolher quanta informação o balanceador enxerga (L4 ou L7) e qual sinal ele usa (sequência, peso, conexões ativas ou afinidade) sem criar um novo gargalo.
Etapa 07 health checks + 502/504
Health checks, failover, métricas e diagnóstico
O problema
Em uma promoção, um dos três backends trava, mas o processo continua de pé. Para o sistema operacional está tudo bem, e o balanceador segue mandando um terço das requisições para ele. Um terço dos usuários recebe erro ou espera até o timeout, e a equipe só descobre porque os clientes reclamam. Um balanceador precisa medir se o serviço atende de verdade, retirar da rotação quem não atende, ter um plano B e, quando algo dá errado, mostrar onde está o problema com logs e métricas.
O conceito
Health checks. No Nginx Open Source, os parâmetros max_fails e fail_timeout implementam verificação passiva: falhas observadas em requisições reais retiram temporariamente o backend da rotação. Com max_fails=3 fail_timeout=10s, três falhas dentro de 10 segundos tiram o servidor da rotação por 10 segundos; depois disso o Nginx volta a tentá-lo e o recoloca se a chamada funcionar. A verificação passiva depende de tráfego real: sem requisições, não há falhas para observar. Verificações ativas (sondas periódicas independentes do tráfego, com a diretiva health_check) são recurso do Nginx Plus, a edição comercial, ou de módulos externos. Um detalhe: em um grupo com um único servidor, max_fails e fail_timeout são ignorados.
Failover e backup. Quando uma tentativa falha por erro de conexão ou timeout, o Nginx tenta o próximo servidor do grupo (comportamento padrão de proxy_next_upstream), então o cliente nem sempre percebe a falha. O parâmetro backup reserva um servidor que só recebe requisições quando todos os primários estão indisponíveis (não pode ser combinado com ip_hash, hash ou random).
Métricas. O módulo stub_status expõe conexões ativas, total de conexões e requisições aceitas, e os estados de leitura, escrita e espera. O Apache Bench (ab) gera carga controlada. Leia em conjunto requisições por segundo, latência, percentis (o p95 mostra a experiência dos mais lentos, que a média esconde), CPU e logs, para saber se o limite está no proxy, no backend ou em uma dependência.
Diagnóstico de 502 e 504. O erro 502 Bad Gateway indica que o Nginx não obteve uma resposta válida do upstream: conexão recusada, conexão encerrada ou resposta inválida. O erro 504 Gateway Timeout indica que a conexão foi feita, mas o backend não respondeu dentro do proxy_read_timeout. A investigação segue o caminho da requisição: cliente, Nginx, backend, dependências. Aumentar um timeout sem investigar pode apenas esconder lentidão.
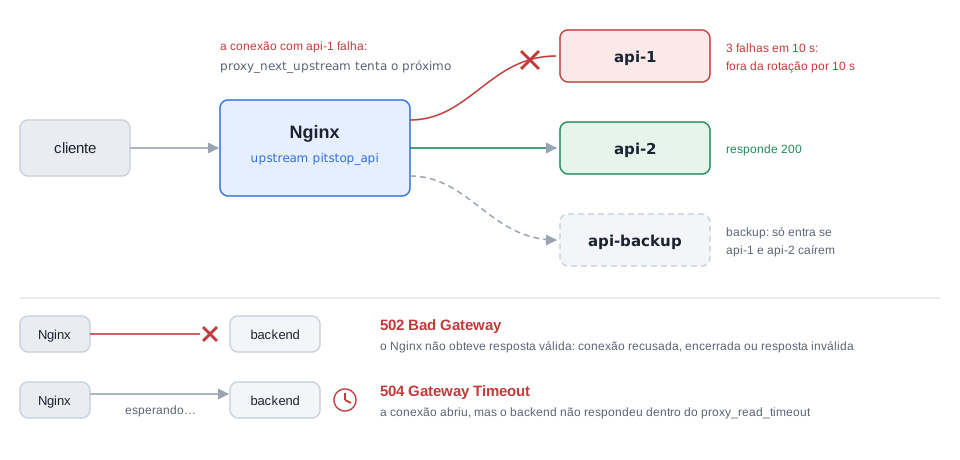
backup só recebe tráfego sem nenhum primário. Embaixo, onde nasce cada erro: 502 sem resposta válida, 504 sem resposta a tempo.Diagrama: feito para este guiaOs conceitos-chave
Check passivo (max_fails, fail_timeout)
falhas em tráfego real retiram o backend por um tempo; disponível no Open Source.
Check ativo (health_check)
sondas periódicas; exige Nginx Plus ou módulo externo.
backup
servidor reserva usado só quando os primários caem.
proxy_next_upstream
define em que falhas o Nginx tenta outro servidor do grupo.
stub_status
painel nativo com conexões ativas e estados de leitura, escrita e espera.
502 e 504
502 é falha ao obter resposta válida (por exemplo, conexão recusada); 504 é espera além do proxy_read_timeout.
Backends primários, reserva, painel de estado e erros provocados
O laboratório tem api-1, api-2, api-backup e um Nginx com rotas para provocar 502 e 504. Copie o backend.py da Etapa 03 para etapa07/.
# compose.yamlx-backend: &backendimage: python:3.12-alpinecommand: ["python", "/app/backend.py"]volumes:- ./backend.py:/app/backend.py:ronetworks: [lab]services:api-1:<<: *backendenvironment: { NAME: api-1 }api-2:<<: *backendenvironment: { NAME: api-2 }api-backup:<<: *backendenvironment: { NAME: api-backup } # só responde quando os primários caemnginx:image: nginx:stableports:- "8080:80"volumes:- ./nginx.conf:/etc/nginx/conf.d/default.conf:ronetworks: [lab]depends_on: [api-1, api-2, api-backup]tools: # container só para rodar curl dentro da redeimage: curlimages/curlentrypoint: ["tail", "-f", "/dev/null"]networks: [lab]networks:lab:ipam:config:- subnet: 172.30.0.0/24 # sub-rede fixa, usada na regra allow do stub_status
Comandos essenciais desta etapa
Mão na massa
- Crie
etapa07/combackend.py,compose.yamlenginx.conf, e rodedocker compose up -d. Confirme comfor i in $(seq 1 6); do curl -s http://localhost:8080/; doneque as respostas alternam entreapi-1eapi-2e nunca vêm deapi-backup. - Rode
ab -n 2000 -c 50 -k http://localhost:8080/e anoteRequests per seconde a linha95%da tabela de percentis. - Em um terminal, rode
for i in $(seq 1 60); do curl -s -o /dev/null -w '%{http_code} ' http://localhost:8080/; sleep 0.5; done. Em outro, rodedocker compose stop api-1. Observe que todos os códigos seguem 200, mas que as primeiras requisições que caírem emapi-1podem demorar alguns segundos cada (a tentativa de conexão a um IP que sumiu da rede não é recusada na hora; os tempos variam). Confirme emdocker compose logs nginx --tail 30as linhas com dois endereços de upstream (o primeiro falhou) e, depois das três falhas domax_fails, só o endereço deapi-2durante a janela de 10 segundos. - Rode
docker compose stop api-2ecurl -s http://localhost:8080/. Observeapi-backup recebeu /: com os primários fora, a reserva assume, e a primeira chamada pode demorar alguns segundos pelo mesmo motivo do passo anterior. - Rode
docker compose start api-1 api-2, recarregue o Nginx (docker compose exec nginx nginx -s reload) e repita o laço do passo 1. Observe o retorno dos primários e o fim do uso do backup. - Com
api-1no ar, provoque os dois erros:curl -s -o /dev/null -w '%{http_code} em %{time_total}s\n' http://localhost:8080/quebradoe o mesmo para/lento. Observe502imediato e504em cerca de 2 segundos, e procure a causa comdocker compose logs nginx | grep -E 'refused|timed out|unreachable|No route'. - Consulte
docker compose exec tools curl -s http://nginx/nginx_statusdurante umabe observeActive connectionssubindo. - Limpe:
docker compose down.
Dica: Nunca mude três timeouts ao mesmo tempo. Reproduza o problema, altere uma variável, repita a carga e compare a mesma métrica. E lembre que o check passivo só descobre a falha quando um cliente real é afetado por ela: a primeira requisição que cai em um backend doente paga o preço.
Anota aí: Alta disponibilidade começa quando a borda detecta um backend incapaz, para de enviar trabalho a ele e prova, com logs e métricas, que a experiência do usuário continuou.
Etapa 08 host + path
Ingress no Kubernetes
O problema
No cluster, cada Service que precisa ser acessado de fora poderia ganhar o seu próprio LoadBalancer. Com dez serviços, são dez balanceadores externos, dez IPs públicos para gerenciar, dez conjuntos de regras e dez custos na nuvem. Os tipos de Service existentes resolvem partes do problema: ClusterIP expõe o serviço só dentro do cluster, NodePort publica uma porta alta em cada nó e LoadBalancer costuma criar um balanceador externo por Service. Falta um ponto de entrada único que entenda HTTP e roteie por domínio e caminho.
O conceito
O Ingress centraliza regras HTTP e HTTPS de roteamento sob um único ponto de entrada. Ele é só uma declaração: um objeto da API que diz "o host X e o caminho Y vão para o Service Z". Quem executa essas regras é o Ingress Controller (ingress-nginx, Traefik, entre outros), que observa os objetos Ingress e configura o proxy real que recebe o tráfego. Sem Controller, criar o objeto Ingress não muda o tráfego.
- Roteamento por host separa domínios (
api.exemplo.comeapp.exemplo.com). Roteamento por path separa caminhos no mesmo domínio (/apie/). pathType: Prefixaceita o caminho e seus subcaminhos;Exactexige igualdade completa;ImplementationSpecificdeixa a interpretação para o Controller (é o tipo usado quando o caminho tem expressão regular no ingress-nginx).- Annotations aplicam recursos específicos do Controller, como a reescrita de URL. Elas valem para o Ingress inteiro, e não para um path só.
ingressClassNameescolhe qual Controller atende a regra quando há mais de um no cluster. - O Service de destino continua sendo um
ClusterIPestável para os Pods selecionados. Se o Service não tem endpoints (Pods prontos), o Ingress não tem para onde encaminhar.
O Ingress segue estável, mas sua API está congelada (a evolução acontece na Gateway API, gateway.networking.k8s.io, que o Kubernetes recomenda para arquiteturas novas). O ingress-nginx, o Controller usado neste laboratório, foi aposentado pelo projeto Kubernetes: a aposentadoria foi anunciada em novembro de 2025 e a manutenção terminou em março de 2026. Ele continua útil para estudar o conceito no Minikube, mas, para produção, prefira um Controller mantido ou a Gateway API. Isso não se aplica ao NGINX Ingress Controller mantido pela F5, que é outro projeto.

Roteamento por path: o mesmo endereço de entrada, e o caminho da URL decide o Service. É o caso do /api deste laboratório.

Roteamento por host: o cabeçalho Host da requisição decide o Service. Nos dois casos, o Ingress é só a regra; quem a executa é o Ingress Controller.
Os conceitos-chave
Ingress
declaração de hosts, paths e Services de destino (networking.k8s.io/v1).
Ingress Controller
o componente que lê os Ingress e configura o proxy real.
ingressClassName
escolhe o Controller responsável pela regra.
pathType
Prefix, Exact ou ImplementationSpecific.
Annotation rewrite-target
reescreve o caminho antes de enviar ao backend; vale para todos os paths do mesmo Ingress.
Service com endpoints
pré-requisito para o Ingress funcionar; sem Pods prontos, não há destino.
Um domínio, dois Services
Os dois Services (api e web) usam o backend.py da Etapa 03 (copie-o para etapa08/), entregue ao cluster por um ConfigMap.
# apps.yamlapiVersion: apps/v1kind: Deploymentmetadata:name: api # backend "api"spec:replicas: 2 # duas réplicasselector:matchLabels:app: api # seleciona os Pods pelo labeltemplate:metadata:labels:app: api # precisa casar com o selectorspec:containers:- name: apiimage: python:3.12-alpine # imagem com Pythoncommand: ["python", "/app/backend.py"] # executa o backend didáticoenv:- name: NAMEvalue: api # nome devolvido nas respostasports:- containerPort: 3000 # porta do backendreadinessProbe: # só recebe tráfego quando respondehttpGet:path: /healthzport: 3000volumeMounts:- name: codemountPath: /app # o script aparece em /app/backend.pyvolumes:- name: codeconfigMap:name: backend-py # ConfigMap criado a partir do backend.py---apiVersion: v1kind: Servicemetadata:name: apispec:selector:app: api # encaminha aos Pods com este labelports:- port: 80 # porta do ServicetargetPort: 3000 # porta do container---apiVersion: apps/v1kind: Deploymentmetadata:name: web # mesmo molde, outro nomespec:replicas: 2selector:matchLabels:app: webtemplate:metadata:labels:app: webspec:containers:- name: webimage: python:3.12-alpinecommand: ["python", "/app/backend.py"]env:- name: NAMEvalue: web # único campo que mudaports:- containerPort: 3000readinessProbe:httpGet:path: /healthzport: 3000volumeMounts:- name: codemountPath: /appvolumes:- name: codeconfigMap:name: backend-py---apiVersion: v1kind: Servicemetadata:name: webspec:selector:app: webports:- port: 80targetPort: 3000
A reescrita de URL vale para todos os paths do Ingress em que a annotation aparece, então a rota /api (com reescrita) e a rota / (sem reescrita) ficam em dois objetos Ingress separados.
Comandos essenciais desta etapa
lab do Minikubehelm repo add do repositório do ingress-nginx)kubectl get endpoints api também funciona, com aviso de depreciação em versões recentes)nginx.conf que o Controller gerou a partir dos IngressMão na massa
- Suba o cluster e o Controller:
minikube start -p lab,minikube addons enable ingress -p labe okubectl waitacima. Observe o Podingress-nginx-controlleremRunninge confirme comkubectl get ingressclassa classenginx. - Crie o ConfigMap (
kubectl create configmap backend-py --from-file=backend.py) e apliqueapps.yamleingress.yaml. Confirme os Pods comkubectl get podse os endpoints comkubectl get endpointslices. - Abra o port-forward em outro terminal (
kubectl port-forward -n ingress-nginx svc/ingress-nginx-controller 8080:80, que fica em primeiro plano) e, no terminal original, rodecurl -s -H 'Host: pitstop.local' http://127.0.0.1:8080/api/healthe o mesmo para/. Observeapi recebeu /health(o prefixo/apifoi removido pelo rewrite) eweb recebeu /. - Teste
/statuse/status/extracom o mesmo cabeçalhoHost. Observe queExactcasa apenas o caminho exato e que o subcaminho cai na regra/do frontend. - Rode o
kubectl exec ... cat /etc/nginx/nginx.conf | grep -n pitstop.locale observe que o Controller transformou os objetos Ingress em blocosserverde um Nginx de verdade. - Provoque uma falha:
kubectl scale deployment api --replicas=0e repita/api/health. Observe a resposta503do Controller (Service sem endpoints) e restaure com--replicas=2. - Encerre o port-forward (Ctrl+C no outro terminal) e apague só as regras:
kubectl delete -f ingress.yaml. Mantenha o perfillab, oapps.yamlaplicado e o ConfigMapbackend-py, porque a Etapa 09 usa o Serviceweb. A limpeza completa fica no fim da Etapa 09.
Dica: Ao depurar, siga a ordem: Controller ativo, ingressClassName correta, regra reconhecida (kubectl describe ingress), Service com endpoints e Pod saudável. A causa costuma estar nos dois últimos itens, não no Ingress.
Anota aí: O Ingress declara uma entrada HTTP compartilhada por host e path; o Controller transforma essa intenção em proxy real, e nada funciona sem um Service com endpoints saudáveis atrás.
Etapa 09 cert-manager
TLS e cert-manager
O problema
O site da loja roda em HTTPS, e o certificado vence em 90 dias. Alguém precisa lembrar, gerar o pedido, provar à autoridade que o domínio é da empresa, instalar o arquivo e recarregar o servidor. Com dezenas de domínios e serviços criados e removidos o tempo todo no cluster, isso não escala. Um certificado vencido derruba o acesso de todos os usuários com um aviso de segurança no navegador.
O conceito
O TLS oferece confidencialidade, integridade e autenticação do servidor. O cert-manager estende a API do Kubernetes com recursos declarativos para emitir, armazenar e renovar certificados automaticamente.
- Issuer emite certificados dentro de um namespace; ClusterIssuer atende o cluster inteiro. Eles definem a autoridade emissora (autoassinada, uma CA interna ou o ACME).
- Certificate declara os nomes DNS, a duração e o Secret que receberá a chave privada e o certificado.
- Com o ACME (protocolo usado pelo Let's Encrypt), um desafio HTTP-01 (publicar um token em um caminho do site) ou DNS-01 (publicar um registro TXT) prova o controle do domínio. O cert-manager acompanha a validade e renova antes do vencimento (por padrão, a duração é de 90 dias e a renovação começa quando falta um terço dela).
- O Ingress referencia o Secret TLS. Com a annotation
cert-manager.io/cluster-issuer, o cert-manager cria o Certificate sozinho a partir do blocotlsdo Ingress. - Na conexão, o cliente informa o nome do site desejado logo no início do handshake (SNI), e é por isso que um mesmo Controller consegue apresentar o certificado certo para cada host.
A chave privada permanece no cluster e não deve ser gravada em manifestos nem em repositórios. Um Secret é codificado em base64, e isso não é criptografia: a proteção vem do controle de acesso (RBAC) sobre os Secrets.
O desafio ACME exige um domínio público alcançável pela autoridade, então o Let's Encrypt só pode ser praticado com um domínio real. O laboratório usa um ClusterIssuer autoassinado, que exercita o mesmo caminho (Ingress, Certificate, Secret, renovação) sem depender de internet pública. Ao usar o Let's Encrypt de verdade, comece pelo ambiente de staging para evitar os limites de emissão.
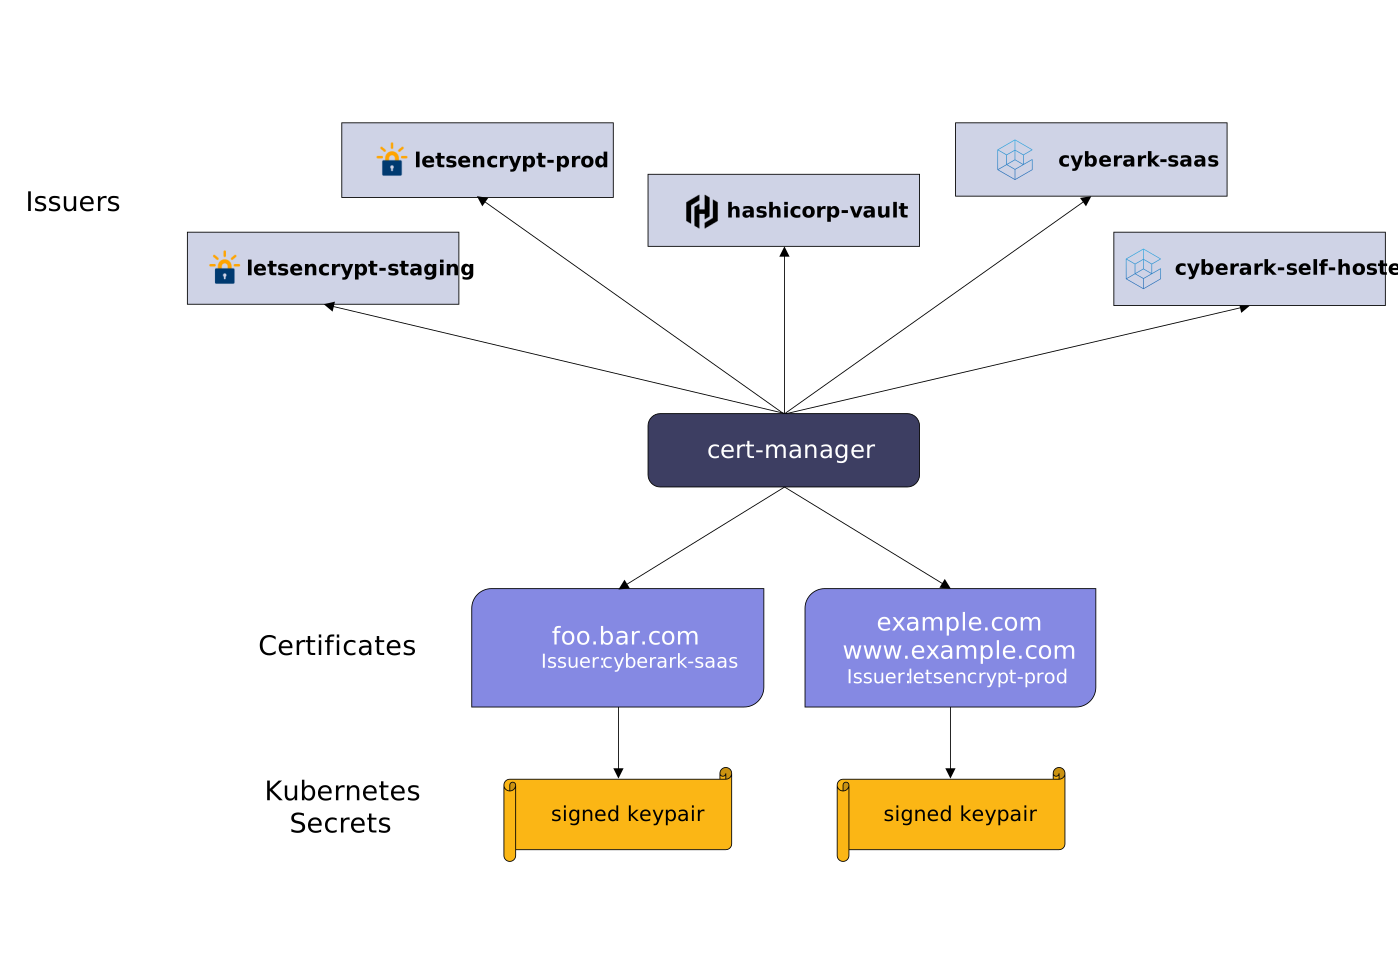
Os conceitos-chave
Issuer e ClusterIssuer
definem quem emite os certificados (cert-manager.io/v1).
Certificate
o pedido (nomes DNS, duração, Secret de destino).
Secret kubernetes.io/tls
guarda tls.crt e tls.key; é o que o Ingress usa.
ACME, HTTP-01 e DNS-01
protocolo e desafios para provar a posse do domínio.
Renovação
automática, antes do vencimento (renewBefore).
Staging
ambiente de teste do Let's Encrypt, sem os limites rígidos de produção.
Ingress integrado ao cert-manager
# clusterissuer-selfsigned.yamlapiVersion: cert-manager.io/v1kind: ClusterIssuermetadata:name: selfsigned # nome citado nas annotationsspec:selfSigned: {} # emite certificados autoassinados (só para laboratório)
Comandos essenciais desta etapa
-k aceita o certificado autoassinadolab ao fim da etapa, antes de subir o perfil mesh da Etapa 10Mão na massa
- No cluster
lab, confirme que oapps.yamle o ConfigMapbackend-pyda Etapa 08 continuam aplicados (kubectl get svc web). Se você os apagou, recrie comkubectl create configmap backend-py --from-file=backend.pyekubectl apply -f apps.yaml, usando os arquivos da pastaetapa08/. Instale o cert-manager com os três comandoshelmdo exemplo e confirme comkubectl get pods -n cert-manageros três PodsRunning. - Aplique
clusterissuer-selfsigned.yamleingress-tls.yaml. Rodekubectl get certificate -we observeREADYpassar deFalseparaTrue. Confirme o Secret comkubectl get secret pitstop-tlse observe o tipokubernetes.io/tls. - Em outro terminal, abra o port-forward da porta 443 (
kubectl port-forward -n ingress-nginx svc/ingress-nginx-controller 8443:443). No terminal original, rode primeirocurl -sk --resolve secure.pitstop.local:8443:127.0.0.1 https://secure.pitstop.local:8443/e observe a respostaweb recebeu /. Depois rode o mesmo comando com-ve2>&1 | grep -iE 'subject:|issuer:'e observe que o certificado entregue já não é oKubernetes Ingress Controller Fake Certificatedo Controller (o certificado do cert-manager não define nome comum, entãosubjecteissuerpodem vir vazios; o nome do site aparece na extensãosubjectAltName, que o passo 4 mostra). - Inspecione o certificado do Secret com o
openssldo exemplo e observe a linhaissuer=, o nome DNS emsubjectAltNamee a validade. - Aplique
certificate-renova.yaml, espere cerca de 6 minutos e rodekubectl describe certificate renova-teste. Observe um evento de renovação eRevision: 2no status. - Demonstre que base64 não é criptografia:
kubectl get secret pitstop-tls -o jsonpath='{.data.tls\.key}' | base64 -d | head -n 1mostra o início da chave privada em texto. Explique quais controles de acesso (RBAC) protegem o Secret. - Limpe tudo da Etapa 08 e desta: encerre o port-forward (Ctrl+C), rode
kubectl delete -f ingress-tls.yaml -f certificate-renova.yaml,kubectl delete secret pitstop-tls renova-teste-tls,kubectl delete -f ../etapa08/apps.yaml,kubectl delete configmap backend-pye, por fim,minikube delete -p lab. Dois clusters ligados ao mesmo tempo pesam, e a Etapa 10 sobe um perfil novo (mesh) com 4 CPUs e 8 GB.
Dica: Quando a emissão travar, leia os eventos do Certificate e, com ACME, os do Challenge. A causa quase sempre é DNS incorreto, ingressClassName errada ou bloqueio do caminho do desafio HTTP-01. Use o staging enquanto testa e só mude para produção quando DNS e rota estiverem corretos.
Anota aí: O cert-manager transforma o certificado em estado desejado: você declara domínio e destino, e o controlador emite, armazena no Secret e renova antes de vencer.
Etapa 10 istio + sidecars
Service Mesh e a arquitetura do Istio
O problema
Uma aplicação de e-commerce virou vinte microsserviços. Cada chamada interna é agora uma chamada de rede, sujeita a latência, falhas e a perguntas que ninguém respondeu: o serviço que chamou é quem diz ser? Quantas vezes tentar de novo antes de desistir? Como saber onde o pedido ficou lento? Cada equipe implementa timeout, retry, criptografia e telemetria na sua linguagem, de um jeito diferente, e o comportamento da rede se torna inconsistente. A Service Mesh move essas políticas para proxies controlados de forma central.
O conceito
No modelo sidecar do Istio, um proxy Envoy é injetado em cada Pod, ao lado do container da aplicação, e intercepta o tráfego de entrada e de saída. A aplicação segue focada na regra de negócio.
- O Data Plane é formado pelos proxies Envoy: eles processam as requisições e aplicam roteamento, resiliência, segurança e telemetria.
- O Control Plane é o Istiod: observa serviços e recursos do Istio, traduz as regras de alto nível para a configuração do Envoy, distribui descoberta de serviços e emite as identidades (certificados) das cargas de trabalho.
- A injeção é habilitada por namespace (
istio-injection=enabled) e acontece na criação do Pod: Pods já existentes só ganham o sidecar quando são recriados (por exemplo, comkubectl rollout restart).
A abstração tem custo: cada sidecar consome CPU e memória, adiciona latência por salto e a malha é uma plataforma adicional para atualizar e diagnosticar. Para poucos serviços, o benefício pode não compensar. O Istio também oferece o modo ambient, sem sidecars; este guia usa sidecars porque o caminho do tráfego fica visível.
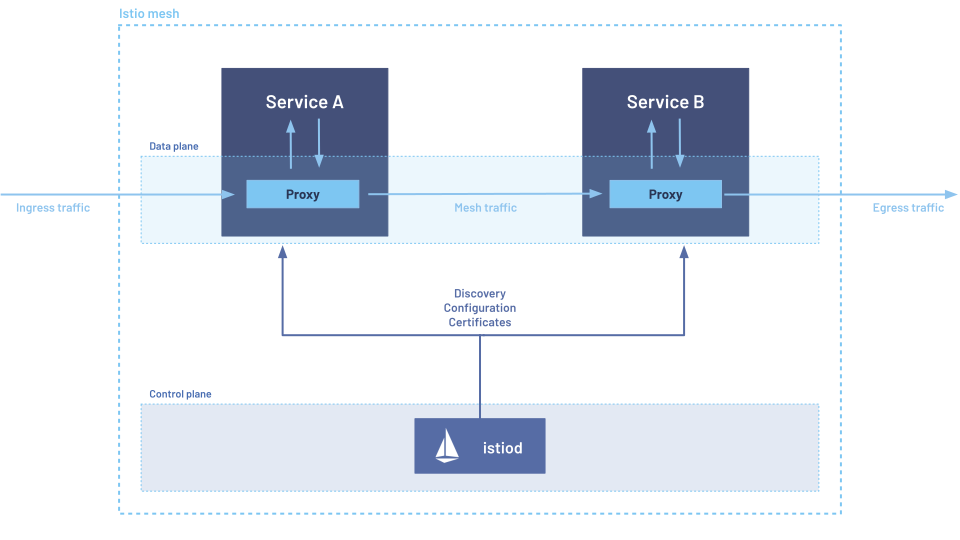
Os conceitos-chave
Service Mesh
camada que padroniza retry, timeout, mTLS e telemetria fora do código das aplicações.
Envoy (sidecar)
o proxy ao lado de cada workload; intercepta e processa o tráfego.
Data Plane
o conjunto de proxies que aplicam as políticas.
Istiod (Control Plane)
distribui configuração, descoberta e identidades.
Injeção por namespace
o label istio-injection=enabled e a recriação dos Pods.
Overhead
recursos extras, um salto a mais e mais uma plataforma para operar.
Instalação, injeção e validação do sidecar
O laboratório usa um namespace demo com uma aplicação api (versão v1) e um cliente web. Copie o backend.py da Etapa 03 para etapa10/ e rode todos os comandos abaixo a partir dessa pasta.
# app.yamlapiVersion: v1kind: ServiceAccountmetadata:name: web # identidade do cliente (usada na Etapa 12)---apiVersion: apps/v1kind: Deploymentmetadata:name: api-v1spec:replicas: 1selector:matchLabels:app: apiversion: v1template:metadata:labels:app: api # label recomendado pelo Istioversion: v1 # versão: base dos subsets da Etapa 11spec:containers:- name: apiimage: python:3.12-alpinecommand: ["python", "/app/backend.py"]env:- name: NAMEvalue: api-v1 # nome devolvido nas respostasports:- containerPort: 3000volumeMounts:- name: codemountPath: /appvolumes:- name: codeconfigMap:name: backend-py---apiVersion: v1kind: Servicemetadata:name: apispec:selector:app: api # seleciona todas as versões da apiports:- name: http # o nome http informa o protocolo à malhaport: 80targetPort: 3000---apiVersion: apps/v1kind: Deploymentmetadata:name: webspec:replicas: 1selector:matchLabels:app: webtemplate:metadata:labels:app: webspec:serviceAccountName: web # o cliente chama a api com a identidade "web"containers:- name: webimage: curlimages/curlcommand: ["sleep", "86400"] # fica parado; usaremos kubectl exec para chamar a api
Comandos essenciais desta etapa
SYNCED)istio-proxyMão na massa
- Entre em
etapa10/e rode os três primeiros comandos do exemplo (download,cd istio-* && export PATH=$PWD/bin:$PATH && cd -eminikube start). Confirme compwdque você voltou paraetapa10/, instale o Istio comistioctl install --set profile=demo -ye observeInstallation complete. Rodekubectl get pods -n istio-systempara ver oistiode os gateways emRunning. - Ainda em
etapa10/, crie o namespacedemo, o ConfigMap e apliqueapp.yaml. ObserveREADY 1/1nos dois Pods, sem sidecar. - Habilite a injeção, rode
kubectl rollout restart deployment -n demoe observeREADY 2/2. Rodekubectl get pod -n demo -l app=api -o jsonpath='{.items[0].spec.containers[*].name}'e observe os containersapieistio-proxy. - Rode
istioctl proxy-statuse observe os proxies deapi-v1ewebemSYNCED. Rode também o comando de recursos reservados e registre o custo do proxy em CPU e memória. - Teste a chamada interna:
kubectl exec -n demo deploy/web -c web -- curl -s http://api/. Observeapi-v1 recebeu /, agora passando por dois proxies. - Crie o namespace
legacysem o label (kubectl create namespace legacy), copie o ConfigMap (kubectl create configmap backend-py --from-file=backend.py -n legacy) e apliqueapp.yamlcom-n legacy. ObserveREADY 1/1e explique onde as políticas da malha deixam de atuar: em Pods sem sidecar, nenhuma política do Istio é aplicada. - Mantenha o cluster
meshe o namespacedemopara as Etapas 11 e 12. Limpe olegacycomkubectl delete namespace legacy.
Dica: Service Mesh não conserta código ruim nem dependência lenta: ela padroniza o comportamento da rede e oferece sinais melhores para encontrar o problema. Antes de adotá-la, descreva um cenário do seu sistema em que a complexidade da malha não compensaria; se não encontrar nenhum, provavelmente você ainda não pesou o custo.
Anota aí: O Istio separa comunicação de negócio: o Envoy executa as políticas no Data Plane e o Istiod coordena configuração e identidade no Control Plane, ao custo de recursos e de operação.
Etapa 11 canary + mirror
VirtualService, DestinationRule e deploy gradual
O problema
A versão 2 da API de pedidos está pronta. Liberá-la para 100% dos usuários de uma vez é arriscado: um erro que os testes não pegaram derruba as vendas inteiras, e a reversão exige um novo deploy. Seria melhor enviar uma pequena fração do tráfego real para a versão nova, observar erros e latência e só então ampliar. Fazer essa divisão por porcentagem exata, ou por características da requisição, não é algo que um Service do Kubernetes sabe fazer, porque ele distribui pelo número de Pods.
O conceito
No Istio, duas regras trabalham juntas. A DestinationRule nomeia grupos de Pods (subsets, selecionados por labels como version: v1) e define políticas de conexão para o destino. O VirtualService decide como cada chamada percorre esses grupos: pesos, condições por header ou path, retries, timeouts, espelhamento e falhas simuladas. As regras são aplicadas pelo sidecar do cliente, então só valem para chamadas que passam por um proxy da malha.
Três formas de testar uma versão:
- Canary por peso envia uma pequena porcentagem do tráfego real para a versão nova e a amplia gradualmente. Os pesos de uma rota precisam somar 100.
- A/B testing usa características da requisição (header, cookie, path) para segmentar usuários, por exemplo enviando sempre um usuário de teste para a v2.
- Traffic mirroring duplica as chamadas para a versão nova e descarta a resposta dela: o cliente continua recebendo a v1, e a v2 recebe carga real sem risco para o usuário.
Resiliência no mesmo recurso: retries ajudam em falhas transitórias, mas multiplicam a carga se não forem limitados. attempts é o número de novas tentativas depois da primeira, perTryTimeout limita cada tentativa e o timeout da rota limita o tempo total, que precisa comportar todas as tentativas. Circuit breaking (na DestinationRule, com outlierDetection) ejeta endpoints que falham seguidamente, para evitar cascatas. A injeção de falhas (fault, com atraso ou aborto) permite testar a reação das aplicações.
Peso é o mecanismo de entrega, não o critério de sucesso: a decisão de ampliar o canário vem de taxa de erro, latência e métricas de negócio.
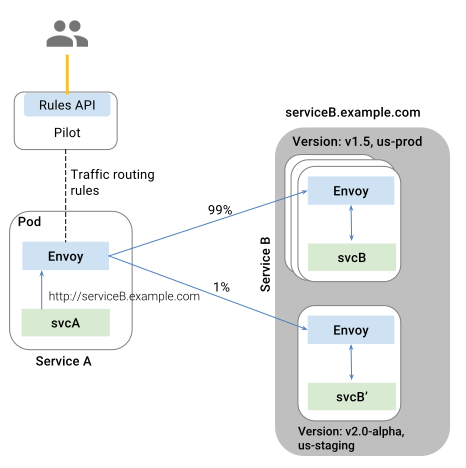
Os conceitos-chave
DestinationRule
define subsets (grupos por label) e políticas do destino (networking.istio.io/v1).
VirtualService
define rotas, pesos, matches, retries, timeout, mirror e fault (networking.istio.io/v1).
Canary, A/B e mirroring
divisão por peso, segmentação por condição e cópia do tráfego.
Retries e timeout
o timeout total deve ser maior que (attempts + 1) × perTryTimeout, porque attempts não conta a primeira tentativa.
Circuit breaking (outlierDetection)
ejeta endpoints que falham em sequência.
Ordem das regras
o primeiro match que casa vence; a rota padrão vai por último.
Noventa por cento v1, dez por cento v2
Primeiro, a versão 2 da aplicação, igual à v1 exceto pelo nome e pelo label version.
# api-v2.yamlapiVersion: apps/v1kind: Deploymentmetadata:name: api-v2spec:replicas: 1selector:matchLabels:app: apiversion: v2template:metadata:labels:app: api # o Service "api" seleciona este Pod tambémversion: v2 # distingue a v2 da v1spec:containers:- name: apiimage: python:3.12-alpinecommand: ["python", "/app/backend.py"]env:- name: NAMEvalue: api-v2ports:- containerPort: 3000volumeMounts:- name: codemountPath: /appvolumes:- name: codeconfigMap:name: backend-py
Comandos essenciais desta etapa
Mão na massa
- Aplique
api-v2.yamle confirmeREADY 2/2nos dois Podsapi. Rodekubectl get endpointslices -n demo -l kubernetes.io/service-name=apie observe dois endpoints: o Service seleciona as duas versões. - Sem nenhum VirtualService, conte 100 respostas com o laço do exemplo. Observe uma divisão perto de 50 e 50, o comportamento do Service puro.
- Aplique
canary.yaml, rodeistioctl analyze -n demoe conte 100 respostas de novo. Observe cerca de 90 para a v1 e 10 para a v2 (a divisão é estatística, então os números variam). - Envie
curl -s -H 'x-usuario: teste' http://api/pelo clientewebvárias vezes. Observeapi-v2em todas as respostas, e o mesmo comando sem o header voltando à divisão 90/10. - Aplique
mirror.yaml, envie 10 chamadas pelo cliente e observe que todas as respostas sãoapi-v1. Em seguida rodekubectl logs -n demo deploy/api-v2 -c api --tail 12e observe as 10 requisições chegando à v2, mesmo sem o cliente receber a resposta dela. - Pratique o rollback:
kubectl delete virtualservice api -n demoe conte 100 respostas. Observe a volta à divisão do Service. Se algo parecer errado, rodeistioctl analyzeantes de atribuir o desvio ao proxy. - Mantenha o cluster para a Etapa 12 e deixe-o sem VirtualService, como após o rollback do passo 6. Se você reaplicar
canary.yamloumirror.yaml, as respostas da Etapa 12 passam a vir também da v2 e os contadores lidos só noapi-v1ficam diferentes dos mostrados lá.
Dica: Se todo o tráfego cai em uma versão só, confira nesta ordem: labels dos Pods contra os subsets, o host do VirtualService contra o Service, e a ordem das regras de match. Lembre também que as regras só valem para chamadas feitas por um cliente com sidecar; um cliente fora da malha ignora o VirtualService.
Anota aí: A DestinationRule define os grupos disponíveis e o VirtualService decide como cada chamada percorre esses grupos: juntos, tornam o deploy gradual observável e reversível.
Etapa 12 identidade + métricas
mTLS, autorização e observabilidade na malha
O problema
O cluster está dentro de uma rede privada, então "ninguém de fora consegue chamar". Na prática, um único Pod comprometido ou mal configurado consegue chamar qualquer outro serviço, e o tráfego interno viaja em texto puro. Além disso, quando um pedido fica lento em uma cadeia de cinco serviços, ninguém sabe qual deles consumiu o tempo. Rede interna não é sinônimo de rede confiável, e é preciso autenticar quem chama, restringir o que pode chamar e enxergar o caminho do pedido.
O conceito
O Istio autentica as cargas de trabalho com certificados de curta duração emitidos pelo Istiod, criptografa o tráfego entre sidecars com mTLS (as duas pontas apresentam identidade) e autoriza chamadas pela identidade, que é derivada da ServiceAccount do Pod (cluster.local/ns/demo/sa/web).
- PeerAuthentication controla o mTLS.
PERMISSIVEaceita tráfego com e sem mTLS e ajuda nas migrações;STRICTrejeita tráfego sem identidade da malha. A política com nomedefaultem um namespace vale para ele todo. - AuthorizationPolicy responde o que uma identidade autenticada pode fazer, por origem, método e path. Quando existe uma política
ALLOWpara uma carga de trabalho, toda requisição que não casa com nenhuma regra é negada (HTTP 403). - Observabilidade: o Envoy registra volume, código de resposta e duração de cada chamada. O Prometheus armazena métricas, o Grafana apresenta painéis, o Jaeger reconstrói traces e o Kiali exibe a topologia, os erros e o estado do mTLS.
- Tracing distribuído: o proxy cria e lê headers de rastreamento, mas a aplicação precisa propagá-los nas chamadas seguintes (
x-request-id,x-b3-traceid,x-b3-spanid,x-b3-parentspanid,x-b3-sampled,x-b3-flags,b3e, para W3C,traceparentetracestate). Sem propagação, o trace quebra mesmo com sidecars saudáveis. Coletar traces exige configurar um provedor de tracing na malha, o que fica fora do laboratório; aqui você verifica os headers e as métricas.
Autenticação responde quem é; autorização responde o que pode fazer. O mTLS não substitui uma política de acesso.
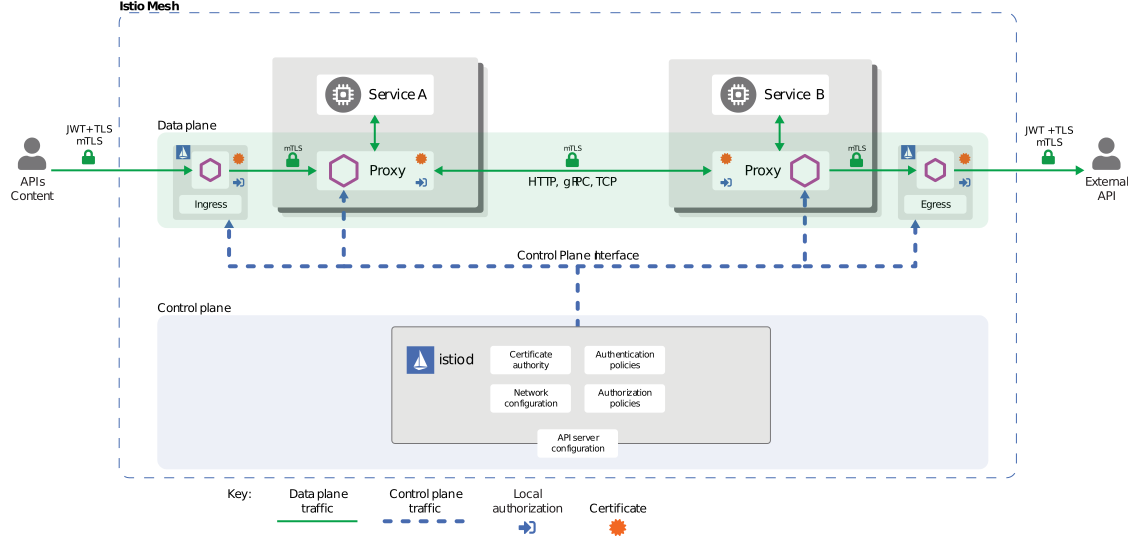
AuthorizationPolicy em cada requisição é o proxy ao lado do Pod.Diagrama: istio.io, Istio Authors, Apache 2.0Os conceitos-chave
mTLS
as duas pontas se autenticam e criptografam o salto entre os sidecars.
PeerAuthentication (security.istio.io/v1)
modo PERMISSIVE (migração) ou STRICT (exige a malha).
AuthorizationPolicy (security.istio.io/v1)
libera origem, método e path mínimos; requisições fora das regras ALLOW são negadas.
Identidade (principal)
derivada da ServiceAccount; só existe quando há mTLS.
Métricas do Envoy
istio_requests_total registra volume e códigos de resposta por origem e destino.
Propagação de headers
responsabilidade da aplicação, indispensável para traces completos.
MTLS estrito, política por identidade e métricas
As duas políticas ficam em arquivos separados para serem aplicadas e testadas uma de cada vez.
# mtls-strict.yamlapiVersion: security.istio.io/v1kind: PeerAuthenticationmetadata:name: default # política do namespace inteironamespace: demospec:mtls:mode: STRICT # rejeita tráfego sem mTLS
Comandos essenciais desta etapa
demodefault e o ROOTCA)etapa10/, onde o Istio foi baixado): instala Prometheus e Kiali para o grafo da malhakubectl port-forward -n istio-system svc/kiali 20001:20001)Mão na massa
- Com o cluster
mesh, crie o namespacelegacye um Pod de teste sem sidecar (comandos do exemplo). Chame a api e observe que, emPERMISSIVE, a chamada sem mTLS funciona. - Aplique somente a
PeerAuthentication:kubectl apply -f mtls-strict.yaml. Repita a chamada dolegacye observe a recusa. Repita a chamada peloweb(que tem sidecar) e observe que continua funcionando. - Aplique
outro.yaml(ele já declaranamespace: demo) e confirme que o PodoutrotemREADY 2/2. Antes de aplicar a política, façakubectl exec -n demo deploy/outro -c outro -- curl -s -o /dev/null -w '%{http_code}\n' http://api/api/pinge observe200, porque ainda não há regra de autorização. Apliqueauthz-api.yaml, rode as quatro chamadas do item 4 do exemplo e observe200apenas paraGET /api/pingvindo doweb, e403para outro path, outro método e outra identidade (ooutro). - Rode a chamada ao
/api/headerse observe que o proxy acrescentouX-Request-IdeX-Forwarded-Client-Certcom a identidade do chamador. Explique por que, para um trace completo, a aplicação precisa copiar esses headers para as chamadas que ela mesma fizer. - Rode
istioctl proxy-config secret deploy/api-v1 -n demoe leia as métricas do Envoy no sidecar. Observe contadoresistio_requests_totalseparados por código de resposta, inclusive os403que você provocou. Como a api-v2 também atende ao Service, repita a leitura emdeploy/api-v2e some os contadores se as chamadas tiverem ido para as duas. - Opcional: instale Prometheus e Kiali (
samples/addonsdentro da pastaistio-*emetapa10/), gere tráfego com um laço decurle abraistioctl dashboard kiali. Observe o grafowebparaapie o ícone de cadeado do mTLS. - Limpe tudo ao fim das Etapas 10 a 12:
minikube delete -p mesh.
Dica: Mude uma política de cada vez e teste os dois lados: uma chamada que deve passar e outra que deve falhar. Um STRICT que "funciona" só com os clientes que você lembrou de testar costuma quebrar o cliente que você esqueceu.
Anota aí: Na malha, identidade e telemetria viram propriedades de cada salto: o mTLS autentica, a AuthorizationPolicy restringe pela identidade e a observabilidade explica o percurso, desde que a aplicação propague os headers de rastreamento.
Etapa 13 slo + spof + vrrp
Alta disponibilidade: SLA, SLO, SPOF e redundância
O problema
Às 2h da manhã, a máquina que hospeda o único balanceador da loja perde a fonte de alimentação. Os dez backends estão saudáveis, mas ninguém consegue acessá-los, porque tudo passa por aquele balanceador. Outro cenário: o contrato promete 99,9% de disponibilidade, e ninguém sabe dizer quantos minutos de indisponibilidade isso permite, nem quanto o failover do sistema realmente leva. Alta disponibilidade começa com uma meta mensurável, identifica os componentes cuja queda derruba tudo e escolhe redundância compatível com o custo e com o estado da aplicação. E precisa ser testada antes do incidente real.
O conceito
- SLA é a promessa externa ao cliente, possivelmente com penalidade. SLO é a meta interna usada pela engenharia, em geral mais rigorosa que o SLA. O orçamento de erro é o que o SLO permite de falha no período (100% menos o SLO). Uma meta de 99,9% em 30 dias permite cerca de 43 minutos de indisponibilidade.
- Um SPOF (single point of failure) é qualquer servidor, balanceador, link, banco ou local cuja falha interrompe todo o serviço. Componentes em série multiplicam as disponibilidades (dois componentes de 99,9% dão cerca de 99,8%), enquanto réplicas independentes em paralelo as melhoram (duas de 99% dão cerca de 99,99%, se as falhas forem independentes). SPOFs devem ser removidos, reduzidos ou aceitos de forma explícita.
- Ativo-passivo mantém uma instância de reserva e exige failover; simplifica a consistência. Ativo-ativo usa todos os nós ao mesmo tempo e redistribui a carga quando um falha, mas exige aplicações stateless ou sincronização correta do estado.
- Keepalived com VRRP move um IP virtual (VIP) entre dois balanceadores: o nó de maior prioridade com saúde confirmada responde pelo VIP, e se ele falhar o outro assume. A configuração dos dois nós precisa permanecer sincronizada por automação (como Ansible) ou por mecanismos declarativos. Em muitas redes de nuvem o VRRP não funciona como em uma rede local, e o provedor oferece balanceadores gerenciados ou reatribuição de IP; confira a documentação do seu provedor.
- Os health checks devem verificar a função real (por exemplo, uma resposta HTTP válida), não apenas a existência do processo.
- Chaos Engineering formula uma hipótese, injeta uma falha controlada e mede a reação, com critérios claros para abortar. Não é falha aleatória em produção.
- HA reduz interrupções locais; Disaster Recovery (DR) recupera o serviço depois de eventos amplos, como a perda de uma zona ou região. O RTO é o tempo máximo aceito para recuperar e o RPO é a perda máxima de dados aceita, medida em tempo.
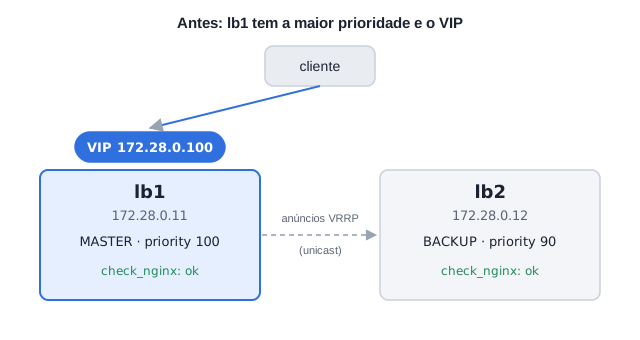
Antes da falha: lb1 tem a maior prioridade e o check_nginx em dia, então responde pelo IP virtual.
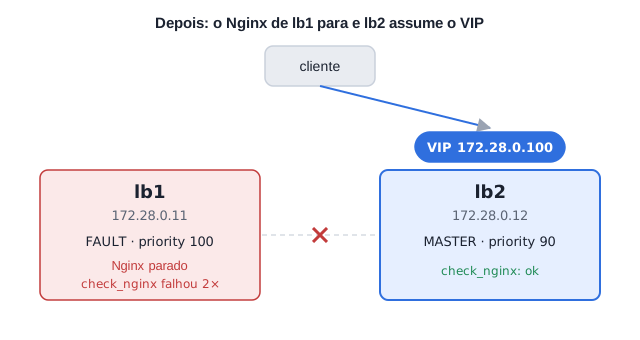
Depois de nginx -s stop em lb1: duas falhas seguidas do check_nginx tiram lb1 do posto, lb2 assume o VIP, e o cliente continua usando o mesmo endereço.
Os conceitos-chave
SLA, SLO e orçamento de erro
promessa externa, meta interna e quanto de falha cabe nela.
SPOF
componente cuja falha derruba tudo; em série, as disponibilidades se multiplicam.
Ativo-passivo e ativo-ativo
reserva à espera ou capacidade compartilhada entre os nós.
Keepalived, VRRP e VIP
o IP virtual migra entre balanceadores conforme a prioridade e a saúde.
Chaos Engineering
hipótese, falha controlada, medição e critério de aborto.
RTO e RPO
tempo de recuperação aceito e perda de dados aceita no DR.
Keepalived protegendo o balanceador
O laboratório sobe dois balanceadores Nginx (lb1 e lb2) em uma rede Docker com um IP virtual (172.28.0.100) e um cliente. Cada nó responde com o próprio nome, o que torna o failover visível.
# DockerfileFROM nginx:stable# keepalived faz o VRRP; curl e iproute2 servem ao check de saúde e à inspeção do IPRUN apt-get update \&& apt-get install -y --no-install-recommends keepalived curl iproute2 \&& rm -rf /var/lib/apt/lists/*
Comandos essenciais desta etapa
lb2)Mão na massa
- Desenhe em papel o caminho completo de uma requisição (cliente, DNS, balanceador, aplicação, banco) e marque cada componente sem redundância. Cada marca é um SPOF.
- Escolha um SLO de disponibilidade para o serviço e calcule o downtime mensal permitido com o comando
awkdo exemplo. Calcule também a disponibilidade de dois componentes de 99,9% em série. - Crie
etapa13/com os arquivos do exemplo e rodedocker compose up -d --build. Descubra qual nó tem o VIP e observeatendido por lb1ao chamar o IP virtual. - Em um terminal, rode o laço do cliente. Em outro, pare o Nginx do
lb1comdocker compose exec lb1 nginx -s stop. Observe respostas delb1, uma ou duas falhas e depois respostas delb2, e meça quantos segundos passaram sem resposta. - Rode
docker compose exec lb1 nginxe observe o VIP voltar aolb1(prioridade maior) após os checks de saúde passarem. Registre também emdocker compose logsas transições de estado. - Escreva uma hipótese de Chaos Engineering (por exemplo, "se o balanceador ativo cair, o cliente perde no máximo 5 segundos de resposta") com um critério de aborto (por exemplo, "se o VIP não migrar em 30 segundos, restaurar o nó e encerrar o experimento"). Compare o resultado do passo 4 com a hipótese.
- Limpe:
docker compose down.
Dica: Uma redundância que nunca foi testada continua sendo uma suposição. Meça o tempo de failover, a perda de requisições e o tempo de recuperação, e compare com o SLO. Se você não consegue demonstrar o failover em um laboratório, não deveria confiar nele em produção.
Anota aí: Alta disponibilidade combina uma meta mensurável, a remoção de SPOFs, redundância e testes; o DR complementa quando a falha ultrapassa o servidor ou a zona local.
Etapa 14 modsecurity + rate limit
WAF, rate limiting e defesa em camadas
O problema
A API de login da loja recebe, de madrugada, milhares de tentativas de senha por minuto vindas de poucos IPs, e algumas requisições trazem trechos de SQL no parâmetro de busca. O firewall de rede bloqueia portas e redes, mas não entende o que está dentro de uma requisição HTTP: um payload de SQL Injection chega por uma porta legítima (443) e passa. A disponibilidade ainda depende de que o acesso legítimo continue confiável, então a borda precisa distinguir uso normal de comportamento hostil sem derrubar usuários reais.
O conceito
Firewalls de camadas 3 e 4 bloqueiam redes e portas, mas não inspecionam a camada de aplicação. Um WAF (Web Application Firewall) inspeciona o conteúdo HTTP. O ModSecurity (com a biblioteca libModSecurity e o conector para o Nginx) é o motor que aplica as regras, e o OWASP Core Rule Set (CRS) é uma base de regras mantida pela comunidade contra padrões como SQL Injection e XSS.
- O WAF avalia as regras e acumula uma pontuação de anomalia; ao passar de um limite, bloqueia (por padrão no CRS, o limite de entrada é 5). Pode apenas registrar (
DetectionOnly) ou bloquear (On). Comece em modo de detecção para ajustar falsos positivos antes de interromper usuários legítimos. O CRS também tem níveis de paranoia (de 1 a 4): níveis maiores detectam mais e geram mais falsos positivos. - TLS 1.2 ou 1.3, HSTS e headers seguros protegem o canal e o navegador. O HSTS manda o navegador usar só HTTPS para o domínio pelo tempo informado em
max-age. - Rate limiting limita as requisições por chave (em geral o IP) e ajuda contra força bruta e abuso, mas não substitui proteção contra DDoS distribuído, em que cada origem envia pouco. No Nginx,
limit_req_zonedefine a chave, a memória e a taxa;limit_reqaplica o limite em um local;burstpermite rajadas enodelayatende a rajada sem atraso. A resposta de rejeição padrão é 503; uselimit_req_status 429para devolver429 Too Many Requests. Atrás de NAT, vários usuários compartilham o mesmo IP, e atrás de um CDN ou proxy é preciso configurar o IP real do cliente. - Logs do Nginx e do ModSecurity precisam chegar a uma plataforma central, com alertas para aumento de bloqueios, de respostas 5xx e de latência. Segurança depende de revisão, atualização do CRS e testes repetíveis.
Um WAF não corrige a vulnerabilidade no código: reduz a exposição e compra tempo para a correção definitiva. A defesa funciona em camadas, cada uma cobrindo o que a anterior não vê.
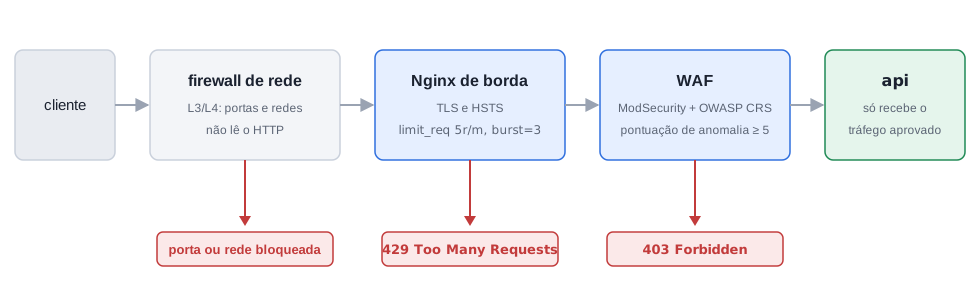
Os conceitos-chave
WAF (ModSecurity + CRS)
inspeciona o conteúdo HTTP com regras e pontuação de anomalia.
DetectionOnly e On
registrar sem bloquear, e bloquear; comece por registrar.
Rate limiting (limit_req_zone, limit_req)
controla abuso por chave; limit_req_status 429 altera o código de rejeição.
TLS e HSTS
protegem o canal e obrigam o navegador a usar HTTPS.
403 e 429
403 vem do bloqueio de uma regra do WAF; 429 vem do limite de taxa configurado.
Logs e alertas
transformam bloqueios em evidência para ajustar regras e responder a incidentes.
Borda em camadas, com TLS, limite de taxa e WAF
O laboratório encadeia três contêineres: o Nginx de borda (TLS, HSTS e limite de taxa), o WAF (imagem owasp/modsecurity-crs, que roda Nginx com ModSecurity e CRS como proxy reverso) e o backend. Copie o backend.py da Etapa 03 para etapa14/ e gere um certificado autoassinado como na Etapa 02 (pasta certs/).
# compose.yamlservices:api:image: python:3.12-alpinecommand: ["python", "/app/backend.py"]environment:NAME: apivolumes:- ./backend.py:/app/backend.py:rocrs:image: owasp/modsecurity-crs:nginx # WAF: Nginx com ModSecurity e OWASP CRSenvironment:BACKEND: http://api:3000 # para onde o WAF encaminha o tráfego aprovadoPORT: "8080" # porta de escuta do WAF dentro do containerMODSEC_RULE_ENGINE: DetectionOnly # só registra; troque para On para bloquearPARANOIA: "1" # nível de paranoia do CRS (1 é o menos sensível)depends_on: [api]edge:image: nginx:stable # borda: TLS, HSTS e limite de taxaports:- "8443:443"volumes:- ./nginx.conf:/etc/nginx/conf.d/default.conf:ro- ./certs:/etc/nginx/certs:rodepends_on: [crs]
Comandos essenciais desta etapa
nginx.confnginx.conf não aparece depois do reload (editores e sed -i substituem o arquivo montado por um novo, e o container continua vendo o antigo)/var/log/modsec_audit.log ou outro caminho; confira com docker compose exec crs env | grep -i audit)crs depois de mudar MODSEC_RULE_ENGINEMão na massa
- Crie
etapa14/combackend.py,compose.yaml,nginx.confe a pastacerts/, e rodedocker compose up -d. Se oedgedevolver502, confira comdocker compose logs crsem que porta o WAF escuta e ajustePORTe oproxy_pass. Se você editar onginx.confdepois, rodedocker compose exec edge nginx -s reloade, se a mudança não aparecer,docker compose restart edge. - Envie uma requisição normal (
curl -sk https://localhost:8443/) e observeapi recebeu /, passando por borda, WAF e backend. - Com o WAF em
DetectionOnly, envie o payload XSS e o de SQL Injection do exemplo. Observe o200e procure nodocker compose logs crsa regra acionada (umidde regra e a mensagem). Identifique a regra antes de habilitar o bloqueio. - Troque
MODSEC_RULE_ENGINEparaOn, rodedocker compose up -de repita os payloads. Observe403. Envie de novo uma requisição normal e observe que continua200. - Rode as 10 chamadas seguidas ao
/logine observe os429depois do limite. Aguarde cerca de 12 segundos e repita uma chamada para observar o limite liberando um slot. - Confira os headers com
curl -sk -I https://localhost:8443/e observestrict-transport-security, e a ausência da versão no cabeçalhoserver. - Monte um checklist para o seu serviço: TLS 1.2 ou 1.3, HSTS, atualização do CRS, retenção de logs, alerta de picos de bloqueio e de 5xx, e um teste repetível dos payloads.
- Limpe:
docker compose down.
Dica: O WAF não corrige vulnerabilidade no código: reduz a exposição e compra tempo, e a correção definitiva continua na aplicação. Nunca ative o bloqueio sem ter lido o log de detecção por um período com tráfego real, porque o falso positivo que derruba um cliente legítimo custa mais que o atraso em bloquear.
Anota aí: Uma borda segura combina criptografia, inspeção na camada de aplicação, controle de taxa, logs e resposta operacional: cada camada cobre o que a anterior não enxerga, e todas começam por observar antes de bloquear.
Etapa 15 · revisão
Checklist de autoavaliação
Etapa 01: Servidor web
- Sei citar as seis funções de um servidor web sem consultar o texto.
- Rodei um Nginx e um Apache e comparei o cabeçalho
Serverde cada um. - Sei explicar por que essas funções não devem ficar dentro do código da aplicação.
Etapa 02: HTTP
- Sei explicar o que é head-of-line blocking e em qual camada cada versão do HTTP o resolve.
- Usei o
curlpara forçar versões do HTTP e observei%{http_version}mudar. - Vi o HTTP/2 ser negociado e desaparecer ao remover
http2 on;no meu Nginx.
Etapa 03: Proxies
- Sei dizer, para um cenário, se ele pede forward ou reverse proxy.
- Configurei um reverse proxy Nginx e confirmei os cabeçalhos recebidos pelo backend com
/headers. - Sei explicar o efeito de remover
proxy_set_header Host,X-Real-IPeX-Forwarded-For, e por que opeersempre mostra o proxy. - Usei um forward proxy com
curl -xe entendi quem abre a conexão com o destino.
Etapa 04: Apache e MPMs
- Sei explicar Prefork, Worker e Event em termos de processo, thread e isolamento.
- Confirmei o MPM de um Apache com
httpd -Mouapachectl -V. - Observei a diferença no número de processos entre Prefork e Event sob carga.
- Sei explicar por que módulos não thread-safe exigem o Prefork.
Etapa 05: Nginx
- Sei explicar I/O não bloqueante, event loop e o papel do
epoll. - Localizei
worker_processeseworker_connectionse comparei os workers com o número de núcleos. - Observei que o número de processos do Nginx não cresce com a carga.
- Sei explicar por que, como proxy, o Nginx comporta cerca de metade das conexões do teto teórico.
Etapa 06: Balanceamento
- Sei escolher entre Round Robin,
weight,least_conneip_hashexplicando o custo de cada um. - Medi a distribuição entre backends em cada algoritmo.
- Comparei um balanceador L4 e um L7 e expliquei o que o L4 não enxerga.
Etapa 07: Failover e diagnóstico
- Parei um backend durante o teste e confirmei o failover pelos logs, notando o atraso das primeiras requisições.
- Vi o servidor
backupassumir e os primários voltarem. - Diferenciei 502 de 504 pelo tempo de resposta e pela mensagem do log de erros.
- Sei dizer o que o Nginx Open Source faz (check passivo) e o que exige Plus (check ativo).
Etapa 08: Ingress
- Sei explicar por que Ingress e Ingress Controller não são a mesma coisa.
- Testei roteamento por host e path,
PrefixcontraExacte a reescrita de URL. - Sei explicar por que as annotations valem para o Ingress inteiro.
Etapa 09: TLS e cert-manager
- Acompanhei Certificate e Secret até
READY Truecom um ClusterIssuer. - Validei o certificado entregue pelo Ingress e li o nome DNS e a validade com
openssl. - Sei explicar por que base64 em Secret não é criptografia.
- Sei dizer a diferença entre HTTP-01 e DNS-01, o que é o SNI e por que o staging existe.
Etapa 10: Istio
- Sei separar Data Plane, Control Plane e custo operacional da malha.
- Confirmei a injeção do sidecar (
2/2) e a sincronização comistioctl proxy-status. - Sei explicar por que Pods existentes precisam ser recriados após habilitar a injeção.
Etapa 11: Deploy gradual
- Configurei subsets e uma divisão 90/10 e medi a proporção real.
- Sei diferenciar canary, A/B e mirroring e vi o espelhamento chegar à v2.
- Pratiquei o rollback e sei explicar a relação entre
timeout,attemptseperTryTimeout.
Etapa 12: mTLS e observabilidade
- Vi a recusa de um cliente fora da malha em
STRICT. - Apliquei a
PeerAuthenticatione aAuthorizationPolicyem arquivos separados e provei, com respostas 200 e 403, que a autorização decide por identidade, método e path. - Li as métricas do Envoy e a identidade no
X-Forwarded-Client-Cert. - Sei explicar por que a aplicação precisa propagar os headers de tracing.
Etapa 13: Alta disponibilidade
- Sei relacionar SLA, SLO, orçamento de erro, SPOF, RTO e RPO.
- Calculei o downtime mensal permitido por um SLO.
- Medi o failover de um IP virtual com Keepalived.
- Escrevi uma hipótese de Chaos Engineering com critério de aborto.
Etapa 14: Defesa da borda
- Testei o WAF primeiro em detecção, li a regra acionada e só depois habilitei o bloqueio.
- Validei TLS, HSTS, o 403 do WAF e o 429 do rate limiting.
- Sei explicar por que
limit_req_status 429é necessário e o queburstenodelayfazem.
Próximos passos: com todos os itens marcados, refaça os laboratórios sem consultar o guia e depois junte as peças. Em Docker, monte uma borda com dois backends atrás de um Nginx com balanceamento, servidor backup, limite de taxa e WAF, e proteja esse Nginx com um segundo nó e Keepalived. No Minikube, publique a mesma aplicação com Ingress e TLS do cert-manager e faça um canário 90/10 com o Istio, medindo a proporção real e praticando o rollback.
Notas do professor: precisões técnicas
- Este bloco reúne detalhes que ajudam a ler os exemplos com segurança. Nada aqui muda o caminho dos exercícios; são esclarecimentos sobre comportamentos que costumam gerar dúvida.
- Sobre o que você vai ver no terminal
- Saídas de exemplo. As saídas mostradas são formatos típicos. Versões, IPs, hashes de Pods, tempos, contagens de processos e distribuições estatísticas (como a divisão 90/10 do canary) variam. Compare a estrutura, não o texto exato.
- Tags de imagem. Os laboratórios usam tags amplas (
nginx:stable,httpd:2.4,python:3.12-alpine,owasp/modsecurity-crs:nginx). Elas se movem com o tempo, e o comportamento descrito vale para versões recentes (por exemplo,http2 on;exige Nginx 1.25.1 ou superior). Fixe versões exatas quando precisar de reprodutibilidade, e confirme a disponibilidade das imagens no momento da execução. - DNS de upstreams no Nginx. O Nginx resolve os nomes de
upstreameproxy_passao carregar a configuração. Se um container for recriado com outro IP, recarregue (nginx -s reload). Se um nome não resolver na partida, o Nginx se recusa a iniciar. Um container parado comdocker compose stopsome da rede, e a tentativa de conexão ao IP antigo costuma falhar com "No route to host" ou com timeout de conexão depois de alguns segundos, em vez de uma recusa imediata; já uma porta fechada em um container ativo é recusada na hora. - IP do cliente em Docker. Pelo mapeamento de portas, o Nginx enxerga como origem o IP do gateway da rede Docker, e não o do seu terminal. Por isso
ip_hashmanda tudo ao mesmo backend e olimit_reqconta todos os acessos do laboratório como um só cliente. - Apache Bench. O
abfala HTTP/1.0 por padrão e abre uma conexão por requisição;-kativa o keep-alive. Ele não faz HTTP/2 nem HTTP/3 e não substitui uma ferramenta de carga realista. Use os números para comparar cenários na mesma máquina, não como medida absoluta. - `kubectl get endpoints`. Em versões recentes do Kubernetes, o comando exibe aviso de depreciação em favor de EndpointSlices. Os exemplos usam
kubectl get endpointslices. - Arquivo único montado em container. Montar um arquivo (como
nginx.confouh2.conf) em um container prende o container ao arquivo original do host. Editores que gravam em um arquivo novo e osed -isubstituem o arquivo, e o container continua vendo a versão antiga, de modo que oreloadparece não fazer nada. Nesse caso, reinicie o container (docker restart <nome>oudocker compose restart <serviço>) ou monte a pasta inteira em vez do arquivo. - Sobre Apache e Nginx
- Alcance da falha no Worker MPM. Um erro grave em uma thread pode corromper ou derrubar o processo filho que a hospeda, e as conexões que ele atendia. O processo mestre e os demais filhos continuam funcionando.
- HTTP/2 no Apache. É oferecido pelo módulo
mod_http2(Protocols h2 http/1.1) e é indicado para MPMs com threads, em especial o Event. Não é recomendado com o Prefork. - `MaxRequestWorkers` no Event. Limita as requisições processadas ao mesmo tempo e precisa caber em
ServerLimitvezesThreadsPerChild. Conexões ociosas em keep-alive não consomem uma thread de trabalho cada, o que é a razão de ser do Event. - Capacidade do Nginx.
worker_processesvezesworker_connectionsé um teto teórico de conexões, e um proxy usa duas por requisição (cliente e backend).use epoll;é opcional no Linux, porque o Nginx escolhe o método mais eficiente. - Open Source e Plus. O Nginx Open Source oferece balanceamento (Round Robin,
least_conn,ip_hash,hash,random),keepalivecom os backends,backupe verificação passiva (max_fails,fail_timeout). Recursos como a verificação ativa (health_check), a persistência de sessão por cookie (sticky cookie),slow_start, o métodoleast_time, a fila de requisições (queue) e a API de configuração dinâmica com painel de monitoramento são exclusivos do Nginx Plus. - `limit_req_status`. A resposta padrão do
limit_reqé 503. Para devolver 429 é necessáriolimit_req_status 429. Emrate=5r/mcomburst=3 nodelay, a primeira requisição e as três da rajada passam; as seguintes são rejeitadas até que um slot (um a cada 12 segundos) seja liberado. - `add_header` e herança. Diretivas
add_headerdeclaradas em umlocationsubstituem as herdadas doserver. Ao adicionar um cabeçalho em umlocation, repita os de nível superior. - Sobre Kubernetes e cert-manager
- Annotations e Ingress. A annotation
rewrite-targetcom grupos de captura vale para todos os paths do mesmo Ingress, por isso o exemplo separa a rota com reescrita da rota sem reescrita. Comrewrite-target, o ingress-nginx passa a tratar como expressão regular os paths do host. - ingress-nginx e Gateway API. O projeto ingress-nginx foi aposentado (anúncio em novembro de 2025, fim da manutenção em março de 2026), e a API Ingress está congelada em favor da Gateway API. Confirme o estado atual do projeto e do addon
ingressdo seu Minikube antes de usá-lo; o conceito de Ingress, Controller e Service com endpoints vale para qualquer Controller. - cert-manager. A instalação por Helm usa
crds.enabled=truenas versões recentes do chart (versões antigas usavaminstallCRDs). A duração padrão de um Certificate é de 90 dias, com renovação a partir de um terço da duração restante; a duração mínima é de 1 hora e orenewBeforemínimo é de 5 minutos. O ClusterIssuer autoassinado é só para laboratório. O certificado emitido para o laboratório define só o nome DNS (subjectAltName), entãosubjecteissuerpodem aparecer vazios emopensslecurl -v. - Secret e base64. O conteúdo de um Secret é apenas codificado. A proteção real vem de RBAC, de criptografia em repouso no
etcde de não versionar chaves. - Sobre Istio, Keepalived e WAF
- APIs do Istio. Os exemplos usam
networking.istio.io/v1(VirtualService e DestinationRule) esecurity.istio.io/v1(PeerAuthentication e AuthorizationPolicy). A versãov1beta1ainda aparece em instalações antigas. Prefira nomes completos de serviço (api.demo.svc.cluster.local) nos camposhost, porque nomes curtos são interpretados em relação ao namespace do recurso. - Retries e timeout.
attemptsconta as novas tentativas depois da primeira; otimeoutda rota deve comportar todas as tentativas. Retries sem limite multiplicam a carga sobre um backend já doente. - Tracing. O sidecar gera o
x-request-ide lê headers de rastreamento, mas a aplicação precisa propagá-los. Coletar e visualizar traces exige um provedor de tracing configurado na malha, o que não faz parte do laboratório; a Etapa 12 verifica os headers e as métricas do Envoy. - Identidade e autorização.
principalsem uma AuthorizationPolicy só casam quando há mTLS. Com uma políticaALLOWem vigor, o que não casa com nenhuma regra é negado com 403. - Keepalived. O
track_scriptprecisa referenciar umvrrp_scriptdefinido no mesmo arquivo. Em produção, useenable_script_securitye scripts com permissões restritas. O laboratório usa VRRP em unicast sobre uma rede Docker; em redes de nuvem, o VRRP costuma não funcionar como em rede local. - WAF. As variáveis da imagem
owasp/modsecurity-crs(BACKEND,PORT,MODSEC_RULE_ENGINE,PARANOIA) e o caminho do log de auditoria podem variar entre versões da imagem; confirme na documentação dela. Os identificadores de regra mostrados (como o 941100) são exemplos e dependem da versão do CRS. O limite de anomalia de entrada padrão do CRS é 5. - Rate limiting e DDoS. O limite por IP ajuda contra força bruta e abuso, mas não substitui proteção contra ataques distribuídos. Atrás de CDN ou proxy, configure o módulo de IP real (
set_real_ip_fromereal_ip_header) para que a chave do limite seja o cliente, e não o proxy. - Pontos a verificar por quem for executar
- Imagens de terceiros.
ubuntu/squid,owasp/modsecurity-crs,curlimages/curlepython:3.12-alpinesão imagens públicas; confirme a disponibilidade, o nome das variáveis de ambiente e a porta de escuta de cada uma antes de executar. - Recursos do Minikube. O Istio com o perfil
demoe as imagens de laboratório exigem memória e CPU; ajuste--cpuse--memoryà sua máquina. Por isso o clusterlabdas Etapas 08 e 09 é removido antes de subir o perfilmesh. - Keepalived em Docker. O laboratório da Etapa 13 depende de
cap_addde rede e de um Docker que as conceda; ambientes sem essa permissão (alguns Docker rootless e Podman) podem não rodá-lo.