guia de estudo · escalabilidade em 6 etapas
Escalabilidade nos servidores
pela lente da F1.
Este guia ensina escalabilidade nos servidores, em seis etapas. Você começa separando desempenho, otimização e escalabilidade e comparando escala vertical e horizontal; depois estuda load balancers (algoritmos, failover, canary e blue/green), o estado fora do servidor com Redis, filas e workers, a borda de CDN, a escalabilidade do banco de dados (réplica de leitura, cache-aside, sharding, CAP, RPO e RTO) e, por fim, a arquitetura completa com métricas, logs e rastreio de requisições. Antes das etapas, a seção seguinte apresenta a lente de F1 do guia: uma comparação geral que mostra o mesmo sistema funcionando dentro de uma equipe de Fórmula 1.
Cada etapa só depende do que foi explicado antes dela e termina com um bloco "Mão na massa": um laboratório e exercícios com resposta esperada. Escalabilidade se aprende medindo, então rode os comandos e compare os números.
Pré-requisitos:
Estrutura de pastas do laboratório (você vai criando aos poucos):
Todos os comandos partem da pasta lab-escalabilidade, salvo quando a etapa manda entrar na pasta dela.
A lente de F1 deste guia
A sala de operações que aguenta o pico
Durante um fim de semana de Grande Prêmio (a etapa do campeonato, com treinos livres, classificação e corrida), uma equipe de Fórmula 1 trabalha em dois lugares ao mesmo tempo. No circuito ficam a garagem, onde os mecânicos preparam os dois carros, e a mureta, a bancada voltada para a pista onde os engenheiros acompanham a sessão. Na fábrica fica a sala de operações remotas, onde vários analistas olham os mesmos dados em tempo real. Os dois lugares se falam por um único link de dados: se ele cai, a garagem fica isolada da fábrica.
Cada carro envia telemetria (os dados dos sensores, transmitidos continuamente) para os servidores da equipe. O engenheiro de corrida (quem acompanha um carro e fala com o piloto pelo rádio) precisa de respostas o tempo todo: quanto o pneu traseiro já gastou, qual o ritmo do carro da frente, se vale a pena parar nos boxes nesta volta. Boa parte dessas perguntas não é respondida no circuito. Ela segue pelo link até a sala de operações na fábrica.
Quando a sala recebe mais perguntas do que consegue responder, há duas saídas. Uma é dar a um analista um computador mais potente, o que tem um limite e deixa o posto parado durante a troca. A outra é colocar mais analistas iguais, trabalhando em paralelo.
Na entrada da sala, um coordenador recebe cada pergunta e a entrega a um analista livre. De tempos em tempos ele confirma com cada posto se está funcionando, e quando um posto cai, as perguntas seguintes vão para os outros. Uma ferramenta de análise nova é usada primeiro num carro só, no treino livre, e só depois nos dois.
Para que qualquer analista consiga continuar o trabalho de outro, nada fica na cabeça de ninguém: o contexto de cada pergunta está no sistema de dados compartilhado da equipe. O trabalho demorado, como uma simulação de estratégia repetida milhares de vezes, não é feito enquanto o engenheiro espera. O pedido entra na fila do grupo de computadores de simulação, a sala responde "recebido", e cada máquina pega um pedido por vez. Quando a fila cresce, a equipe liga mais máquinas.
O material que o circuito consulta a todo momento (o mapa do circuito, os dados de referência dos pneus) não atravessa o mundo a cada consulta. Os servidores que a equipe leva para o circuito guardam uma cópia local, com prazo de validade, e a fábrica pode mandar descartá-la antes do prazo quando o original muda.
A folha de especificação do carro (o registro oficial de cada peça e de cada ajuste) tem uma única versão oficial, na fábrica, e só nela se fazem alterações. A garagem consulta cópias de leitura, atualizadas logo depois e, por instantes, atrasadas. Se o link com a fábrica cai, a garagem precisa escolher: seguir trabalhando com a cópia que tem, talvez desatualizada, ou esperar o link voltar para não decidir com dado velho.
Para entender o que acontece, a equipe olha três registros: a telemetria, com os números de cada sensor ao longo da sessão; o diário de eventos, com o que aconteceu e a que horas; e o número de protocolo que cada pergunta recebe ao entrar na sala, que permite reconstruir por quais postos ela passou e quanto tempo ficou em cada um.
É a mesma divisão de trabalho de um sistema escalável. Cada pergunta é uma requisição, a sala de operações é a frota de servidores e o coordenador na entrada é o load balancer. Tirar o contexto da cabeça do analista é tornar o servidor stateless, e a fila do simulador é a fila com workers. A cópia no circuito é a CDN, a folha oficial e as suas cópias são o banco primary e as réplicas de leitura, e os três registros são a observabilidade. O quadro mais abaixo traduz cada termo do guia em palavras simples, e a seção "Onde a comparação para", logo depois dele, mostra o que a F1 não cobre em cada etapa.
Uma regra fixa vale para o guia inteiro: cada analista da sala é uma réplica do servidor. Todos são iguais e trocáveis entre si, e nenhum guarda sozinho o que outro vai precisar.
Os termos em palavras simples
71
O quadro abaixo traduz cada termo técnico do guia para uma ideia do dia a dia, sem F1 e sem jargão. Não precisa decorar; volte a ele quando um termo aparecer no texto.
| Termo técnico | Em palavras simples |
|---|---|
| Desempenho (latência) | Quanto tempo leva para atender uma pessoa só, como os minutos que um caixa gasta para passar as compras de um cliente. |
| Throughput | Quantas pessoas são atendidas por minuto no total, somando todos os caixas abertos. |
| Otimização | Fazer a mesma tarefa gastar menos sem contratar ninguém, como o caixa que aprende um jeito mais rápido de passar os produtos. |
| Escalabilidade | A capacidade de atender mais gente quando se acrescentam recursos, como a loja que abre mais caixas quando a fila cresce. |
| Triângulo de trade-offs | Numa reforma você quer que fique rápida, barata e simples, e raramente consegue as três coisas juntas. Com servidores é igual: desempenho, custo e complexidade. |
| Escala vertical | Trocar o fogão da cozinha por um maior. É simples, mas existe um tamanho máximo e, durante a troca, a cozinha para. |
| Escala horizontal | Abrir mais cozinhas iguais e dividir os pedidos entre elas. |
| Ponto único de falha (SPOF) | A única ponte que liga um bairro ao resto da cidade: se ela fecha, ninguém passa. |
| Elasticidade e autoscaling | Abrir e fechar caixas conforme o movimento, seguindo regras combinadas antes, em vez de alguém decidir na hora. |
| Karpenter | O gerente que, quando faltam caixas, providencia exatamente o tamanho de balcão que a fila pede, escolhendo o mais barato disponível naquele momento. |
| FinOps | Olhar a conta de luz junto com o conforto da casa: decidir quanto vale gastar por cada ganho, em vez de deixar tudo ligado no máximo. |
| Load balancer | A pessoa que organiza a fila do banco e indica a cada cliente qual guichê está livre. O cliente só conhece a fila, não os guichês. |
| Camada 4 e camada 7 | Na camada 4, o carteiro entrega olhando só o endereço do envelope. Na camada 7, a secretária abre a carta e encaminha ao setor certo conforme o assunto. |
| Round-robin | Distribuir as cartas do baralho uma para cada jogador, em volta da mesa, sem olhar quem já tem mais. |
| Weighted Round-robin | O mesmo rodízio, mas com pesos: a cozinheira que dá conta do triplo recebe três pedidos a cada volta, e as outras recebem um. |
| Least connections | Mandar o próximo cliente para o caixa que está atendendo menos gente naquele momento. |
| IP hash (afinidade de sessão) | Cada cliente é sempre atendido pelo mesmo gerente da agência, escolhido por uma conta feita sobre o número dele. |
| Health check | A pergunta feita de tempos em tempos a cada guichê, "consegue atender?"; quem não responde deixa de receber clientes. |
| Failover | Quando um guichê fecha de repente, os próximos clientes são mandados para os outros sem perceber. |
| Connection draining | Antes de fechar um guichê, terminar de atender quem já está nele, sem chamar ninguém novo. |
| Blue/Green | Duas lojas idênticas lado a lado e uma placa na entrada apontando para uma delas. Virar a placa muda todos os clientes de uma vez, e desvirar é igualmente rápido. |
| Rollback | Desfazer uma mudança e voltar à versão anterior que funcionava, como devolver os móveis ao lugar antigo quando a nova arrumação não deu certo. |
| Canary | Servir a receita nova primeiro para uma mesa em cada dez e observar a reação antes de mudar o cardápio inteiro. |
| Ingress | O quadro na entrada do prédio que indica: "pedidos, sala 2; todo o resto, recepção". |
| Stateful | O atendente que guarda o seu pedido de cabeça: só ele consegue continuar o atendimento. |
| Stateless | O pedido anotado numa comanda que fica no balcão: qualquer atendente lê e continua. |
| Sticky session | Obrigar o cliente a voltar sempre ao mesmo atendente, porque só ele lembra do pedido. |
| Redis | Um quadro de recados rápido no meio da cozinha, que todos os cozinheiros leem e escrevem. |
| ReplicaSet e Auto Scaling Group | A regra do gerente "sempre três caixas abertos": se um fecha, abre-se outro no lugar. |
| Fila e worker | Os pedidos pendurados no varal da cozinha e os cozinheiros que pegam um por vez para preparar. |
| Produtor e resposta 202 | O garçom que anota, pendura o pedido no varal e diz "recebido"; o prato chega depois. |
| KEDA | Chamar mais cozinheiros quando o varal de pedidos enche e dispensá-los quando esvazia. |
| Sidecar | Um assistente que trabalha ao lado do cozinheiro anotando tudo o que sai, sem que o cozinheiro precise parar para isso. |
| Ambassador | O despachante que cuida de toda a conversa da empresa com repartições externas, inclusive insistindo quando a ligação cai. |
| Service mesh | Uma central telefônica interna: toda ligação entre setores passa por ela, que repete a chamada quando cai, limita o tempo de espera e registra tudo, sem que cada setor precise fazer isso sozinho. |
| Retry com backoff exponencial | Ligar de novo quando ninguém atende, esperando 1, depois 2, depois 4 minutos, para não congestionar a linha. |
| Jitter | Somar alguns segundos sorteados à espera antes de ligar de novo, para que muitas pessoas que ligaram ao mesmo tempo não insistam todas no mesmo instante. |
| Fallback | O plano B combinado antes: se o prato acabou, serve-se a opção da casa. |
| Circuit breaker | O disjuntor da casa: depois de falhas repetidas ele desarma, e ninguém volta a ligar os aparelhos daquela tomada até o disjuntor ser religado. |
| CDN | Uma rede de filiais de livraria que guardam cópias dos livros mais procurados perto de cada bairro. |
| Origem | O depósito central, onde ficam os originais. |
| PoP (borda) | A filial do bairro, perto de quem compra. |
| DNS inteligente | O atendente da central que, ao saber de qual bairro você liga, passa o endereço da filial mais próxima. |
| Edge computing | A filial do bairro que, além de guardar livros, faz pequenos serviços na hora (embrulhar, escrever a dedicatória) sem mandar o pedido ao depósito central. |
| Cache hit e cache miss | Hit: a filial tem o livro na prateleira. Miss: a filial precisa pedir ao depósito, e guarda uma cópia para o próximo cliente. |
| Cache-Control e TTL | A etiqueta de validade que o depósito cola em cada cópia, como "vale por uma hora". |
| ETag e 304 Not Modified | O número da edição do livro. A filial pergunta "a edição 3 ainda é a atual?" e o depósito responde "é, continue usando", sem mandar outro exemplar. |
| Invalidação (purge) | O recolhimento: mandar todas as filiais descartarem uma cópia na hora, antes da validade vencer. |
| Cache hit ratio | A porcentagem de clientes atendidos pela filial sem que ela precise pedir nada ao depósito. |
| WAF | O segurança na porta que barra quem chega com um tipo de ataque já conhecido. |
| TLS offload | A conferência demorada de documentos feita na portaria, para que os setores de dentro não precisem repeti-la. |
| Primary e read replica | O livro-caixa oficial, o único onde se faz lançamento, e as cópias dele que vão sendo atualizadas logo depois e que todos podem consultar, sem escrever nelas. |
| Replicação assíncrona | A cópia é atualizada logo depois do original, mas o original não espera a confirmação da cópia; por instantes ela pode estar atrasada. |
| Write splitting | A regra da casa: lançamentos só no livro oficial; consultas, nas cópias. |
| Cache-aside | Antes de ir ao arquivo, olhar o bilhete na mesa; se não houver bilhete, buscar no arquivo e deixar um bilhete para a próxima vez. |
| Sharding | Dividir as fichas de clientes entre vários armários, por letra do nome (range) ou por uma conta sobre o número do cliente (hash). |
| Hotspot | O armário que todo mundo abre ao mesmo tempo, enquanto os outros ficam parados. |
| Teorema CAP e partição | Quando o telefone entre duas filiais cai, cada uma escolhe: continuar atendendo com a informação que tem (disponível, talvez desatualizada) ou parar até conseguir confirmar com a outra (consistente, mas parada). |
| Consistência eventual | Um aviso trocado em várias salas: por alguns instantes uma sala ainda mostra o aviso antigo, mas no fim todas mostram o mesmo. |
| Promoção da réplica (failover de banco) | O substituto que acompanhava o livro-caixa passa a ser o titular e a fazer os lançamentos. |
| RPO | Quanto trabalho você aceita perder, como "se o computador queimar, aceito refazer no máximo os últimos 5 minutos". |
| RTO | Quanto tempo você aceita ficar parado até voltar a atender. |
| Serverless | Pagar a corrida de táxi em vez de manter um carro: alguém cuida do veículo e, sem viagem, não há conta. |
| Monolito | Um restaurante com uma cozinha só, de onde saem todos os pratos. |
| Microsserviços | Uma praça de alimentação: cada balcão faz uma coisa, tem a sua equipe e precisa combinar com os outros. |
| Lei de Conway | O jeito como a empresa se organiza acaba aparecendo no jeito como o sistema é dividido. |
| Métricas | Os números do medidor de luz ao longo do mês: mostram que o consumo subiu, e quando. |
| Logs | O livro de ocorrências da portaria, com a hora e a descrição de cada evento. |
| Traces | O rastreio de uma encomenda, que mostra por quais centros ela passou e quanto tempo ficou em cada um. |
| X-Request-ID | O código de rastreio impresso na encomenda, o mesmo em todos os centros por onde ela passa. |
| SLO e error budget | A meta "a loja fica aberta 99,9% do tempo"; o 0,1% que sobra é a folga para imprevistos e mudanças, e quando ela acaba a prioridade vira estabilidade. |
Onde a comparação para
6
A comparação ajuda a fixar quem faz o quê numa operação que cresce, mas não é uma equivalência perfeita. Estes são os pontos em que a F1 deixa de valer para cada etapa:
- Etapa 01: colocar mais um analista na sala de operações leva semanas, e cada pessoa trabalha de um jeito; uma réplica de servidor sobe em segundos, é idêntica às outras e pode ser criada e removida por uma regra automática. E analistas a mais não aceleram nada se todos esperam pela mesma peça compartilhada, como o banco de dados: aí o problema é de otimização, não de escala.
- Etapa 02: o coordenador da sala lê a pergunta e usa o próprio julgamento; o load balancer segue um algoritmo fixo (round-robin, least connections, IP hash) e só sabe o que o health check responde, então um servidor que responde "estou bem" mas devolve dados errados continua recebendo tráfego. O canary também não é "um carro de dois": ele manda uma porcentagem escolhida das requisições para a versão nova.
- Etapa 03: um analista lembra do contexto mesmo sem anotar; um servidor stateless não pode guardar nada entre requisições, e se guardar, o load balancer manda a próxima requisição para outra réplica que não conhece aquele estado. A fila de simulações, além disso, é só uma lista de mensagens: quem trata falhas, novas tentativas com backoff e o circuit breaker é o código, não um operador olhando a fila.
- Etapa 04: a equipe escolhe a dedo o que leva para os servidores do circuito; a borda da CDN decide sozinha o que guardar e por quanto tempo, a partir dos cabeçalhos
Cache-ControleETagque a origem envia. Resposta que muda de usuário para usuário não pode ser guardada na borda, e um TTL longo demais faz a borda entregar conteúdo velho até o purge. - Etapa 05: a folha de especificação muda poucas vezes por sessão, nas mãos de poucas pessoas; um banco recebe milhares de escritas simultâneas, e o atraso da réplica faz uma leitura logo após a escrita mostrar o dado antigo. O sharding, que divide os próprios dados entre vários bancos, não tem paralelo na folha única, e a escolha entre consistência e disponibilidade do CAP é feita no projeto, antes da falha, e não decidida na hora por alguém na garagem.
- Etapa 06: os sensores do carro já saem de fábrica transmitindo telemetria; num sistema, métricas, logs e traces só existem se o código for instrumentado, e o
X-Request-IDsó acompanha a requisição se cada serviço o repassar adiante. A arquitetura completa também custa: cada peça a mais é mais uma coisa para monitorar, pagar e manter.
Etapa 01 desempenho x escala
Fundamentos de escalabilidade moderna
O problema
Um aplicativo viraliza depois de uma campanha de marketing. Milhões de usuários tentam acessá-lo ao mesmo tempo e o sistema sai do ar. O que deveria ser sucesso vira frustração e perda de receita: é uma falha de escala. Grandes varejistas fora do ar na Black Friday e o "Fail Whale" do Twitter (atual X) são os exemplos clássicos. Tecnicamente, essas quedas costumavam vir de gargalos em componentes difíceis de escalar horizontalmente, como um banco relacional sobrecarregado ou um sistema de pagamentos que não aguentava a concorrência.
Crescer junto com a demanda é necessidade de negócio. Mas há uma armadilha: nem todo sistema lento tem problema de escala. Antes de comprar mais máquinas, é preciso saber o que exatamente está lento.
O conceito
Três palavras costumam ser usadas como se fossem a mesma coisa, e não são. Pense num supermercado:
- Desempenho (performance) é a velocidade de uma única tarefa, ou seja, a latência de uma operação: quantos itens por minuto um caixa escaneia.
- Otimização é melhorar o desempenho sem adicionar recursos: ensinar o caixa a escanear 20% mais rápido ou reorganizar os produtos nas prateleiras.
- Escalabilidade é a capacidade de aumentar a produtividade (throughput) proporcionalmente aos recursos adicionados. Quando a fila fica gigantesca, não adianta ter o caixa mais rápido do mundo: abrem-se mais caixas.
O triângulo de trade-offs. Performance, custo e complexidade: é praticamente impossível maximizar os três ao mesmo tempo. Um banco com hardware de ponta e várias camadas de cache eleva custo e complexidade. Microsserviços podem baratear o custo por requisição em larga escala, mas trazem complexidade operacional enorme comparada a um monolito. O papel do profissional é navegar esses trade-offs conforme os requisitos técnicos e de negócio.
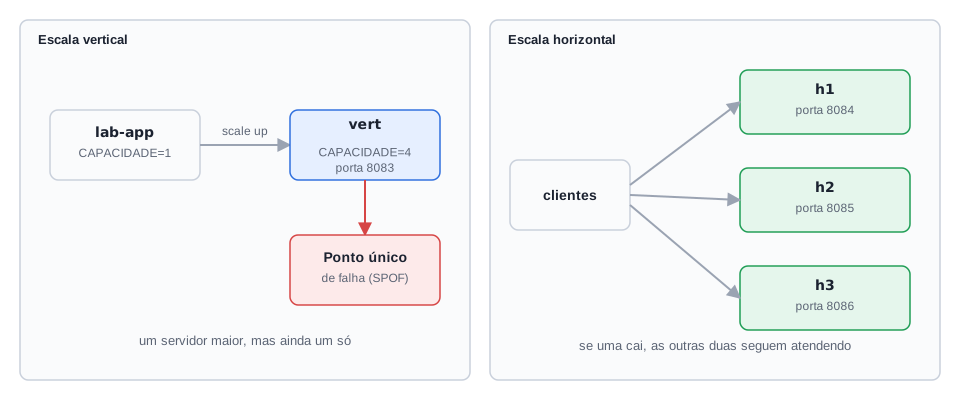
Escala vertical (scaling up) é aumentar um único servidor: mais CPU, mais RAM, discos mais rápidos.
- Vantagem: simplicidade, geralmente sem mudar código.
- Desvantagens: limite físico e financeiro (o próximo upgrade fica proibitivo ou não existe), costuma exigir downtime para o upgrade e cria um ponto único de falha (SPOF): se o super-servidor cai, tudo cai.
Escala horizontal (scaling out) é adicionar mais servidores para distribuir a carga: uma frota de máquinas menores e mais baratas.
- Vantagem: escala teoricamente ilimitada e mais resiliência, pois a falha de uma instância só redireciona o tráfego para as saudáveis.
- Custo: a aplicação precisa ser projetada para ambiente distribuído (idealmente stateless) e a operação fica mais complexa, com a necessidade de um load balancer (Etapa 02).
Elasticidade e autoscaling. Elasticidade é a capacidade de crescer e encolher recursos conforme a carga. Autoscaling é o mecanismo automatizado que a implementa, com regras predefinidas, sem uma equipe de plantão adicionando servidores na mão. Há três estilos:
A automação é a chave para a eficiência de custos: paga-se só pelo que se usa.
Quando NÃO escalar. Às vezes o gargalo se resolve com otimização de código ou uma query mais eficiente. Para um sistema interno de 50 funcionários com tráfego baixo e estável, autoscaling é exagero de custo e complexidade. Distinguir problema de escala de problema de otimização é sinal de maturidade.
Desafios atuais e ferramentas. Microsserviços, contêineres, sistemas orientados a eventos e picos sazonais imprevisíveis multiplicam os componentes: dezenas ou centenas de serviços, cada um com a sua necessidade de escala. A granularidade permite escalar só o componente necessário (por exemplo, o carrinho de compras), mas traz latência de rede e desafios de observabilidade. As ferramentas citadas no material são o Kubernetes (padrão de orquestração), o AWS Auto Scaling Groups (ASG, elasticidade na nuvem), o Karpenter (provisiona recursos pela necessidade real, com foco em custo) e o KEDA (escala com base em eventos, como o tamanho de uma fila).
No mercado (segundo o material): o iFood enfrenta picos em finais de campeonato e dias chuvosos e responde com microsserviços na nuvem, autoscaling intensivo e filas para desacoplar o processamento de pedidos. A tendência FinOps olha a escalabilidade também pela ótica de custo; o Karpenter provisiona os recursos exatos usando as instâncias mais baratas disponíveis. Vendas de ingressos de festivais e eventos esportivos derrubando sites forçam o mercado a evoluir em balanceamento, proteção contra bots e cache distribuído via CDN.
Os conceitos-chave
Desempenho
latência de uma operação isolada.
Throughput
quanto trabalho o sistema completa por unidade de tempo.
Otimização
melhora o desempenho sem acrescentar recursos; costuma melhorar o throughput junto.
Escalabilidade
aumenta o throughput acrescentando recursos; não reduz a latência de uma requisição isolada.
Escala vertical
um servidor maior; simples, com teto, downtime no upgrade e SPOF.
Escala horizontal
mais servidores; resiliente e com teto alto, exige aplicação preparada e load balancer.
SPOF
componente sem redundância cuja falha derruba o sistema inteiro.
Elasticidade e autoscaling
crescer e encolher automaticamente, por métrica, por agenda ou por previsão.
Uma "loja" com capacidade limitada
Para sentir a diferença entre otimizar, escalar para cima e escalar para fora, vamos usar uma aplicação de teste que modela um servidor com capacidade finita: cada instância atende no máximo N requisições ao mesmo tempo (CAPACIDADE), e cada requisição leva um tempo fixo (TRABALHO_MS). As requisições que excedem a capacidade esperam a vez. É um modelo, não um servidor real, mas deixa os números previsíveis. O caminho /health responde na hora, sem simular trabalho. Crie a pasta e os arquivos:
$ mkdir -p lab-escalabilidade/app && cd lab-escalabilidade
app/app.py:
Comandos essenciais desta etapa
000 significa que não houve resposta)Mão na massa
Laboratório
1. Linha de base: uma instância, capacidade 2, 100 ms por requisição.
docker run -d --name base -p 8081:8080 lab-appcurl -s -o /dev/null -w "latência de uma requisição: %{time_total}s\n" localhost:8081/carga http://localhost:8081/
Saída esperada (valores aproximados, sua máquina varia):
latência de uma requisição: 0.10xxxxsreal 0m5.2s
A conta: 2 requisições a cada 100 ms dão 20 por segundo; 100 requisições levam cerca de 5 segundos.
2. Otimização: mesma máquina, trabalho pela metade.
docker run -d --name otim -p 8082:8080 -e TRABALHO_MS=50 lab-appcurl -s -o /dev/null -w "latência: %{time_total}s\n" localhost:8082/carga http://localhost:8082/
Esperado: latência perto de 0.05s e tempo total perto de 2,5 s.
3. Escala vertical: um "servidor maior" (capacidade 4).
docker run -d --name vert -p 8083:8080 -e CAPACIDADE=4 lab-appcurl -s -o /dev/null -w "latência: %{time_total}s\n" localhost:8083/carga http://localhost:8083/
Esperado: latência continua perto de 0.10s; tempo total perto de 2,5 s.
4. Escala horizontal: três instâncias pequenas, com um "balanceador" feito à mão.
docker run -d --name h1 -p 8084:8080 lab-appdocker run -d --name h2 -p 8085:8080 lab-appdocker run -d --name h3 -p 8086:8080 lab-app# O módulo 3 do número da requisição escolhe a porta 8084, 8085 ou 8086time (seq 1 100 | xargs -P 20 -I{} sh -c 'curl -s -o /dev/null http://localhost:$((8084 + {} % 3))/')
Esperado: tempo total perto de 1,7 s (3 instâncias × 20 por segundo = 60 por segundo).
5. O que observar.
| Experimento | Latência de 1 requisição | Tempo para 100 requisições |
|---|---|---|
| Base | cerca de 0,10 s | cerca de 5 s |
| Otimização | cerca de 0,05 s | cerca de 2,5 s |
| Vertical | cerca de 0,10 s | cerca de 2,5 s |
| Horizontal (3) | cerca de 0,10 s | cerca de 1,7 s |
Escalar (vertical ou horizontalmente) não mexeu na latência de uma requisição isolada, só no throughput. Otimizar mexeu nos dois. É exatamente a distinção entre desempenho e escalabilidade.
6. O ponto único de falha, ao vivo.
docker stop basecurl -s -o /dev/null -w "%{http_code}\n" --max-time 2 localhost:8081/docker stop h1for p in 8084 8085 8086; do curl -s -o /dev/null -w "%{http_code} " --max-time 2 localhost:$p/; done; echo
Esperado: 000 na primeira chamada (conexão recusada: o SPOF caiu) e 000 200 200 na segunda. Com a frota, só um terço falha. Mas quem decide para onde mandar a requisição ainda é o seu sh -c, que não sabe que h1 caiu. Na próxima etapa, quem decide é o load balancer.
Limpeza:
docker rm -f base otim vert h1 h2 h3
Exercícios
- Escalar ou otimizar? Para cada situação, diga qual alavanca usar primeiro e por quê: (a) uma página faz 400 consultas SQL em loop; (b) o site da campanha de Black Friday vai receber 20 vezes o tráfego normal em 3 horas; (c) um sistema interno de 50 funcionários está lento às segundas de manhã. *Resposta esperada:* (a) otimizar, porque o problema é a query e escalar só multiplicaria o desperdício; (b) escalar horizontalmente, de preferência com autoscaling agendado ou por métrica; (c) medir antes, provavelmente otimizar, e evitar autoscaling por ser exagero de custo e complexidade.
- Escreva as três regras. Para uma loja com pico previsível às 20h, escreva uma regra baseada em métrica, uma agendada e descreva o que uma preditiva faria de diferente. *Resposta esperada:* (métrica) "se a CPU média da frota passar de 70% por mais de 5 minutos, adicione um servidor; se cair abaixo de 30% por 10 minutos, remova um"; (agendada) "todo dia às 19h50, suba para o número de servidores que o pico pede, e às 22h desça para o mínimo"; (preditiva) um modelo de Machine Learning treinado no histórico aprende o formato do pico (por exemplo, que sexta-feira é mais forte que terça) e sobe a capacidade antes de ele começar, sem depender de um horário escrito à mão. A diferença de fundo: a regra por métrica reage depois que a carga subiu; a agendada e a preditiva se antecipam.
- Triângulo. Você precisa baixar a latência do banco pela metade. Cite uma solução que sacrifica custo e outra que sacrifica complexidade. *Resposta esperada:* sacrificando custo, hardware de ponta para o banco (escala vertical: mais RAM, discos mais rápidos), simples de operar, mas caro, com teto e ponto único de falha; sacrificando complexidade, uma ou mais camadas de cache (por exemplo, Redis) na frente do banco, baratas por unidade, mas com novos problemas (invalidação, dado desatualizado). Antes das duas, vale conferir se uma query ou um índice melhor já resolve, porque a otimização custa pouco nos três vértices.
Dica: Antes de escalar, meça duas coisas separadamente: a latência de uma requisição sozinha e o tempo de um lote em paralelo. Se a requisição sozinha já é lenta, o problema é de desempenho e mais servidores não vão resolvê-lo.
Anota aí: Escalar aumenta quanto o sistema aguenta (throughput), otimizar faz cada tarefa custar menos; antes de comprar servidor, descubra qual dos dois problemas você tem.
Etapa 02 algoritmos + failover
Load balancers na prática
O problema
Você tem três servidores idênticos e uma pergunta: como o tráfego chega até eles de forma organizada? Na Etapa 01, o seu sh -c fazia o papel de distribuidor e, quando uma instância caiu, um terço das requisições simplesmente falhou. Em produção, ninguém quer o cliente decidindo isso sozinho, e ninguém quer derrubar o site para publicar uma versão nova numa sexta-feira à tarde. É aqui que entra o load balancer (balanceador de carga): ele evita sobrecarga, mantém a aplicação no ar mesmo se uma instância falhar e viabiliza deploys com zero downtime, como os que Netflix e Spotify fazem.
O conceito
Um load balancer é um servidor proxy entre os clientes e os servidores da aplicação. Ele é o único ponto de contato e uma abstração: o cliente fala com um endereço só. Além de distribuir requisições, garante alta disponibilidade, confiabilidade e gerenciamento simplificado. O material o compara ao controlador de tráfego aéreo, que direciona aviões para pistas livres e mantém a operação mesmo com uma pista interditada.
Camada 4 vs camada 7 (modelo OSI):
Externo vs interno. O externo tem interface pública (IP público ou DNS) e é o portão de entrada da aplicação. O interno só existe dentro da rede privada (VPC) e gerencia a comunicação entre serviços: o "Carrinho" fala com o "Estoque" sem expor o Estoque à internet, o que é ganho de segurança.
Algoritmos:
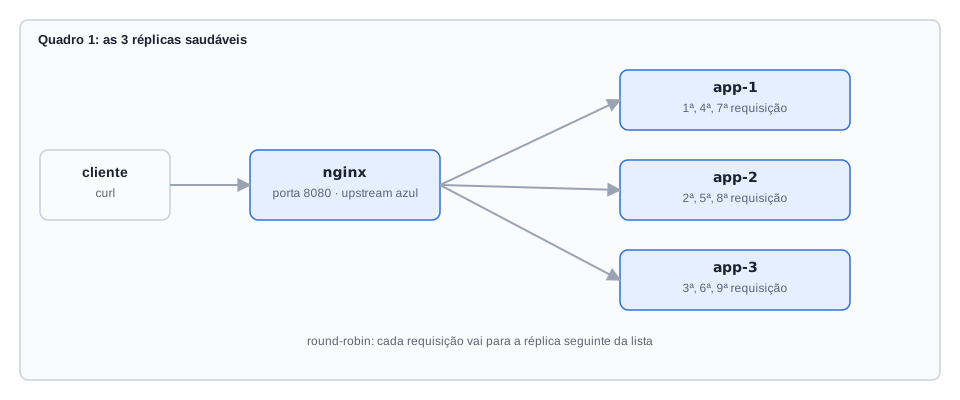
- Round-robin: lista circular, o próximo da fila. Justo e previsível, mas ignora carga e capacidade. A variante Weighted Round-robin dá pesos maiores a servidores mais potentes.
- Least Connections: manda para quem tem menos conexões ativas. Bom quando as conexões têm durações muito diferentes (uploads, streaming).
- IP Hashing: o hash do IP do cliente define o servidor, então o mesmo IP cai sempre no mesmo servidor (afinidade de sessão). Desvantagens: distribuição desigual quando muitos usuários estão atrás do mesmo proxy corporativo e problemas de sessão se um servidor falha e o hash é recalculado.
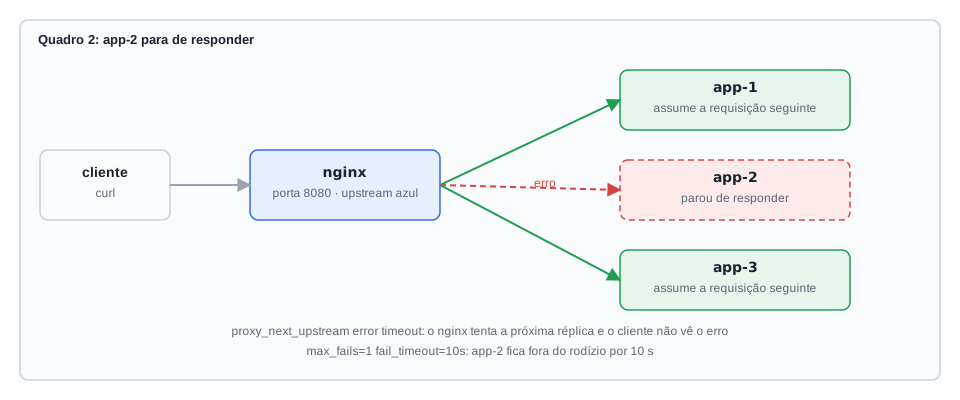
Health checks e failover. O LB testa ativamente a saúde de cada servidor. Parâmetros: intervalo, timeout, *unhealthy threshold* (falhas consecutivas para marcar como não saudável) e *healthy threshold* (sucessos consecutivos para voltar). Quando um servidor falha, ocorre o failover: o LB para de mandar tráfego novo para a instância doente, de forma transparente. O connection draining deixa as conexões existentes terminarem antes de remover a instância.
Estratégias de deploy:
- Blue/Green: dois ambientes idênticos e isolados. O LB manda 100% para Blue (estável); Green (a nova versão) é validado; a "virada" aponta tudo para Green. O rollback é igualmente rápido. Atenção ao banco compartilhado: mudanças de schema precisam ser retrocompatíveis.
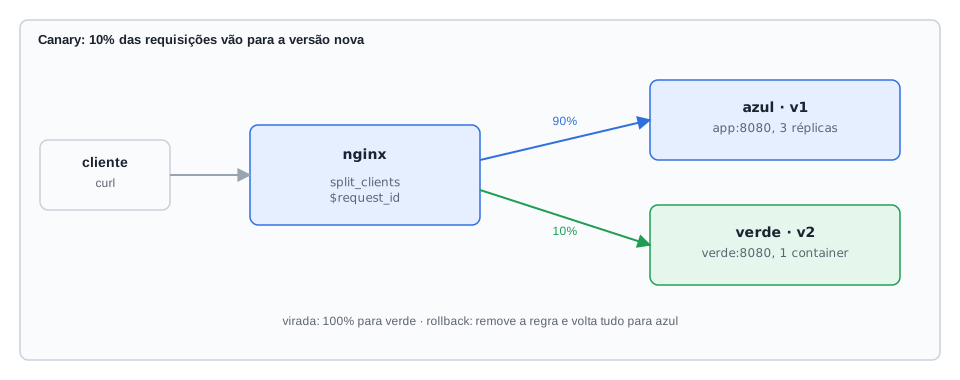
- Canary: nome vindo dos canários usados nas minas de carvão. Uma pequena porcentagem (1%, 5%) vai para a versão nova; monitoram-se métricas técnicas (erros, latência) e de negócio (conversão, engajamento); aumenta-se gradualmente até 100%.
No mercado (segundo o material): a Netflix usa LBs internos para desacoplar milhares de microsserviços; se as recomendações ficam lentas, o tráfego vai para um fallback ou circuit breakers são ativados, evitando falha em cascata. Service Mesh e API Gateways (Istio e Linkerd, com sidecar proxies agindo como LBs L7 por serviço) trazem observabilidade, mTLS e controle granular. O GSLB (Global Server Load Balancing) usa DNS inteligente para multi-cloud e ambientes híbridos: o usuário do Brasil vai para São Paulo, o da Europa para Frankfurt, conforme geolocalização, latência e saúde. Cloudflare e F5 são citados como líderes.
Como o laboratório se encaixa. O Nginx fará o papel do Application Load Balancer (L7). Na AWS, o *listener* é a porta de entrada, o *target group* é o grupo de servidores de destino e o *health check* decide quem está saudável. No Nginx, o listen é o listener, o bloco upstream é o target group e a verificação de saúde é passiva: o Nginx de código aberto marca um servidor como falho quando as conexões reais para ele falham. O health check ativo, que sonda periodicamente, é recurso do NGINX Plus.
Os conceitos-chave
Load balancer
ponto único de entrada que distribui requisições entre servidores.
L4
decide por IP e porta; rápido e cego ao conteúdo.
L7
decide pelo conteúdo HTTP (caminho, cabeçalhos, cookies); mais inteligente e mais caro de processar.
Round-robin, weighted, least connections, IP hash
as regras de escolha do próximo servidor.
Health check, failover, connection draining
detectar o servidor doente, tirá-lo de rotação e deixar terminar o que já estava em andamento.
Blue/Green
virada total entre dois ambientes, com rollback igualmente rápido.
Canary
uma fração pequena do tráfego na versão nova, aumentada aos poucos.
Ingress
o roteador L7 do Kubernetes, que leva o tráfego externo aos serviços certos do cluster.
Exemplos comentados
$ mkdir -p etapa-02/nginx && cd etapa-02
docker-compose.yml:
Comandos essenciais desta etapa
docker compose ps -q app: listam os containers (o -q devolve só os IDs)Mão na massa
Laboratório
1. Round-robin. 30 requisições, contando quem respondeu:
for i in $(seq 1 30); do curl -s localhost:8080/; done | awk '{print $1}' | sort | uniq -c
Esperado (os IDs mudam):
10 3f2a1b9c0d1e10 7c8d9e0f1a2b10 a1b2c3d4e5f6
Graças à diretiva zone, os processos worker do Nginx compartilham o mesmo contador de round-robin, por isso a divisão sai exata. Sem ela, cada worker teria o seu contador e a distribuição poderia sair irregular (por exemplo, 12 para um e 9 para cada um dos outros).
2. Failover. Derrube uma réplica e continue chamando:
docker stop $(docker compose ps -q app | head -n 1)for i in $(seq 1 20); do curl -s -o /dev/null -w "%{http_code}\n" localhost:8080/; done | sort | uniq -c
Esperado: 20 200. Nenhuma falha chegou ao cliente. A primeira requisição que cair na réplica parada pode demorar cerca de 1 segundo (o proxy_connect_timeout) antes de o Nginx tentar outro servidor. Compare com a Etapa 01, em que apareceu 000.
Traga a réplica de volta e atualize o Nginx, que resolve nomes só na partida e por isso pode estar com um IP desatualizado:
docker compose up -ddocker compose exec lb nginx -s reload
3. Algoritmos. Troque para least_conn e depois para ip_hash. (No macOS, use gsed no lugar de sed, ou edite nginx/default.conf à mão: insira a linha least_conn; logo abaixo de upstream azul { e, depois, troque-a por ip_hash;.)
# Insere "least_conn;" logo depois da abertura do bloco upstream azulsed -i 's/upstream azul {/upstream azul {\n least_conn;/' nginx/default.confdocker compose exec lb nginx -t && docker compose exec lb nginx -s reload# Agora troca por ip_hashsed -i 's/least_conn;/ip_hash;/' nginx/default.confdocker compose exec lb nginx -t && docker compose exec lb nginx -s reloadfor i in $(seq 1 10); do curl -s localhost:8080/; done | awk '{print $1}' | sort | uniq -c
Esperado com ip_hash: uma única linha com 10 e um só servidor. O seu cliente tem sempre o mesmo IP (o do gateway do Docker) e por isso cai sempre no mesmo servidor: é a afinidade de sessão, e também o desequilíbrio que acontece quando muita gente compartilha um IP. Remova a linha para voltar ao round-robin:
sed -i '/ip_hash;/d' nginx/default.confdocker compose exec lb nginx -s reload
4. Canary com 10%. Substitua o conteúdo de nginx/default.conf por:
upstream azul {zone azul 64k; # estado de balanceamento compartilhado entre os workersserver app:8080 max_fails=1 fail_timeout=10s;}upstream verde {server verde:8080;}# Sorteia o destino pelo ID único de cada requisição: 10% vão para "verde", o resto para "azul"split_clients "${request_id}" $destino {10% verde;* azul;}server {listen 80;location / {proxy_pass http://$destino; # o nome do grupo vem da variável sorteadaproxy_connect_timeout 1s;proxy_next_upstream error timeout;}}
docker compose exec lb nginx -t && docker compose exec lb nginx -s reloadseq 1 200 | xargs -P 10 -I{} curl -s localhost:8080/ | awk '{print $2}' | sort | uniq -c
Esperado, aproximadamente: 180 v1 e 20 v2 (o sorteio varia um pouco). Se as métricas da v2 piorassem, só esses 10% teriam sentido.
5. Blue/Green: a virada e o rollback. (No macOS, use gsed, ou edite o arquivo à mão: troque 10% por 100% na virada e apague a linha do verde no rollback.)
# Virada: 100% para a versão novased -i 's/10% verde;/100% verde;/' nginx/default.confdocker compose exec lb nginx -s reloadfor i in 1 2 3 4 5; do curl -s localhost:8080/ | awk '{print $2}'; done# Esperado: v2 cinco vezes# Rollback: remove a regra do verde e volta tudo para azulsed -i '/% verde;/d' nginx/default.confdocker compose exec lb nginx -s reloadfor i in 1 2 3 4 5; do curl -s localhost:8080/ | awk '{print $2}'; done# Esperado: v1 cinco vezes
O nginx -s reload é gracioso: os processos antigos terminam as conexões em andamento antes de sair. É a ideia do connection draining.
Exercícios
Os exercícios 1 e 2 mexem no nginx/default.conf com a stack no ar. O arquivo está no formato do canary/rollback (com o split_clients), e é o bloco location / dele que você troca no exercício 1. Depois de editar, rode docker compose exec lb nginx -t && docker compose exec lb nginx -s reload.
- Roteamento L7. Troque o bloco
location /por dois:location /api/comproxy_pass http://verde;elocation /comproxy_pass http://azul;. Chamecurl -s localhost:8080/api/pagamentosecurl -s localhost:8080/blog. Qual versão responde a cada uma? Por que isso só é possível em L7? *Resposta esperada:*/api/pagamentosresponde comv2(o grupoverde) e/blogcomv1(o grupoazul). Só o L7 consegue, porque o caminho/api/...está dentro da requisição HTTP, e o L4 enxerga apenas IP e porta. - Pesos. Qual seria o efeito de
server app:8080 weight=3;ao lado de outro servidor com peso 1, e em que cenário real você usaria isso? *Resposta esperada:* o servidor de peso 3 receberia cerca de 3 de cada 4 requisições (proporção 3 para 1). É o Weighted Round-robin, útil quando as máquinas são desiguais e um servidor mais potente deve receber mais carga que um menor. - Ingress (leitura). No YAML do segundo exemplo comentado, qual serviço atende
/api/pedidose qual atende/? *Resposta esperada:*/api/pedidosvai para o Serviceapi;/vai para oweb. É o mesmo raciocínio dos blocoslocationdo Nginx.
Limpeza (ao terminar o laboratório e os exercícios):
docker compose down -vcd ..
Dica: Antes de todo reload, rode nginx -t. Uma configuração inválida faz o reload ser recusado e o Nginx continua com a configuração anterior, mas o -t mostra o erro e a linha na hora, em vez de você descobrir que a mudança não entrou.
Anota aí: O load balancer é o único ponto de entrada que distribui a carga, tira instâncias doentes de rotação e permite trocar versões sem derrubar ninguém.
Etapa 03 stateless + filas
Padrões de escala horizontal em arquiteturas cloud
O problema
Já temos load balancer e frota. Mas de que adianta uma frota de servidores idênticos se cada cliente só pode ser atendido por um servidor específico? Um cliente coloca café no carrinho, o load balancer manda a próxima requisição para outra instância, e o carrinho aparece vazio. E se o processamento de pagamentos for muito mais lento que o resto? Adicionar servidores para tudo é desperdício. Esta etapa olha para dentro da aplicação.
Há um segundo cenário, o do e-commerce na Black Friday: confirmar um pedido envolve validar o pagamento, baixar o estoque, emitir a nota fiscal e enviar um e-mail. Feito de forma síncrona, o usuário fica esperando tudo isso diante de uma tela de carregamento, e cada servidor fica ocupado com trabalho que não precisava acontecer naquele momento.
O conceito
Regra de ouro: stateless.
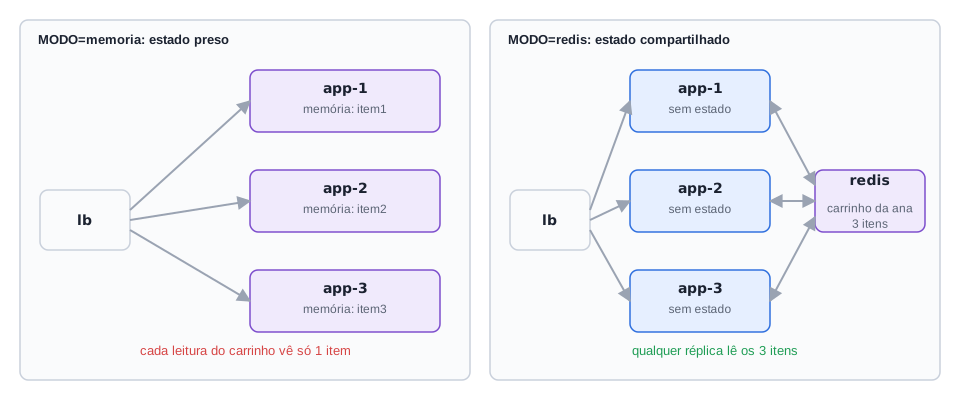
- Stateful: guarda dados da sessão na memória do servidor (por exemplo, o carrinho numa variável de sessão). O cliente fica "preso" ao servidor; se o load balancer o manda para outro, o carrinho some. O contorno são as *sticky sessions*, que limitam a resiliência e a eficiência do balanceamento.
- Stateless: nenhuma informação de contexto fica no servidor entre requisições; cada requisição traz tudo de que precisa. O estado vai para um armazenamento compartilhado e rápido (um banco ou um cache distribuído como o Redis). Qualquer servidor atende qualquer cliente a qualquer momento, o que é compatível com escala horizontal e com failover automático.
Unidades de escala. São os mecanismos que mantêm o número certo de cópias rodando:
- Kubernetes ReplicaSet: garante um número especificado de cópias idênticas de um Pod sempre rodando.
- AWS Auto Scaling Group (ASG): gerencia o ciclo de vida de um grupo de instâncias EC2, mantendo a quantidade desejada saudável.
No Compose, o campo deploy.replicas que você usou na Etapa 02 cumpre um papel parecido, para réplicas locais.
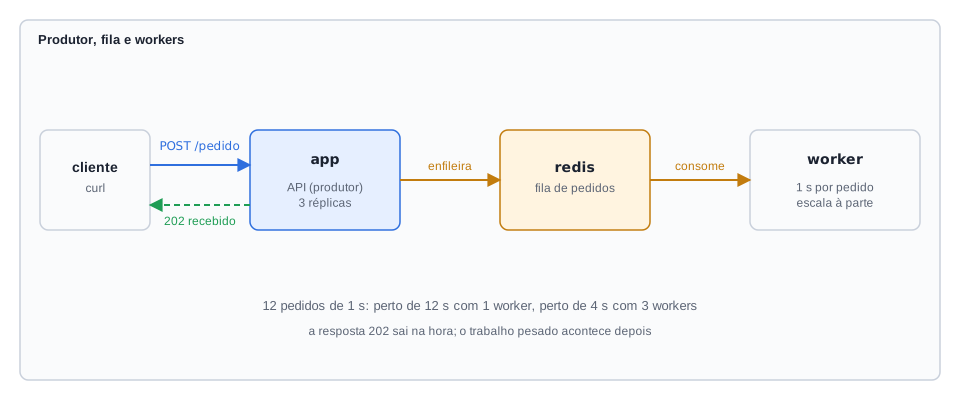
Workers e filas. A aplicação principal (o produtor) publica uma mensagem numa fila (AWS SQS, RabbitMQ) e responde na hora ("Seu pedido foi recebido e está sendo processado"). Os workers (consumidores) leem a fila e fazem o trabalho pesado de forma assíncrona. Os workers escalam de forma independente da API, com base no tamanho da fila.
Padrões avançados:
- Sidecar: contêiner auxiliar no mesmo Pod do principal, cuidando de logs, monitoramento ou proxy de rede sem a aplicação saber.
- Ambassador: variação de proxy focada na comunicação com o exterior ou com outros serviços (retries, descoberta de serviços).
- Sharding: escala horizontal de dados; o banco é particionado em bancos menores e independentes (shards). Fica para a Etapa 05.
Trade-offs e resiliência. Uma política de autoscaling agressiva dá melhor performance e conta alta; a conservadora economiza e degrada nos picos. FinOps busca o equilíbrio. Em sistemas distribuídos a falha é certa, por isso existem o Retry com exponential backoff (tentar de novo, esperando cada vez mais entre as tentativas) e o Fallback (plano B, como servir do cache ou uma resposta padrão).
Ferramentas e mercado (segundo o material): o KEDA (Kubernetes Event-driven Autoscaling) monitora o tamanho de uma fila no SQS ou o lag de um tópico Kafka e escala workers de zero a N. O Karpenter provisiona nós exatos, mais baratos e adequados no momento. A Netflix popularizou o Circuit Breaker com a biblioteca Hystrix: falhas repetidas "abrem" o circuito, bloqueando chamadas ao serviço falho e indo direto para o fallback; uma falha nas recomendações não impede ninguém de assistir. Instagram e iFood usam workers e filas para bilhões de uploads e milhões de pedidos. O serverless (AWS Lambda) é a evolução máxima de workers e filas: escala de zero a milhares de execuções e cobra por execução. Istio e Linkerd implementam Sidecar e Ambassador de forma padronizada, com retries, timeouts, segurança e observabilidade.
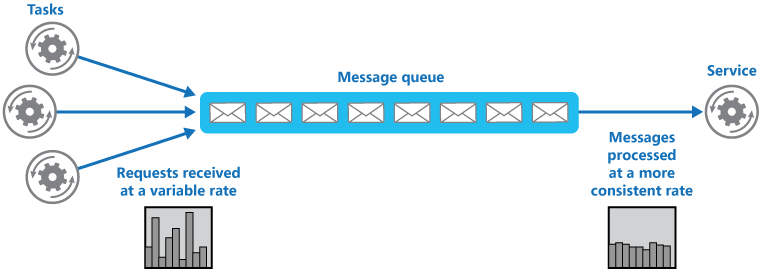
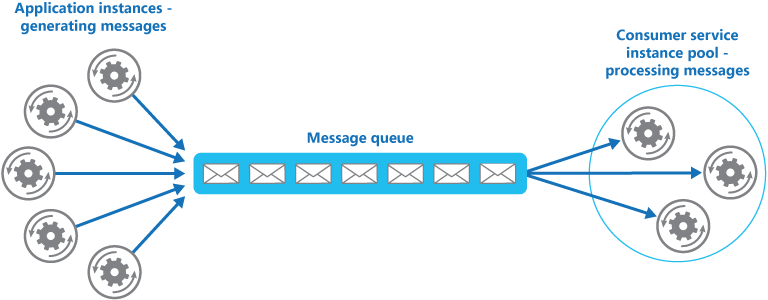
--scale worker=3.Diagrama: Azure Architecture Center, Microsoft, CC BY 4.0Os conceitos-chave
Stateful
estado na memória do servidor; prende o cliente a ele.
Stateless
estado fora do servidor (Redis, banco); qualquer réplica atende qualquer cliente.
Sticky session
remendo que prende o cliente a uma réplica; o estado ainda morre com ela.
ReplicaSet e ASG
mantêm N cópias idênticas e saudáveis.
Produtor, fila e worker
responder na hora e processar o trabalho pesado depois.
Escala por tamanho de fila
workers crescem com a fila, independentemente da API (a ideia do KEDA).
Sidecar e ambassador
proxies auxiliares ao lado da aplicação.
Retry com backoff, fallback e circuit breaker
os mecanismos para conviver com falhas.
Exemplos comentados
Vamos substituir a aplicação por uma versão completa: carrinho em memória ou em Redis, conforme a variável MODO; um endpoint de pedido que enfileira e responde 202; e um worker. Ela mantém o comportamento da Etapa 01 em / e /health. Substitua app/app.py:
import jsonimport osimport socketimport threadingimport timefrom http.server import BaseHTTPRequestHandler, ThreadingHTTPServerfrom urllib.parse import parse_qs, urlparseHOST = socket.gethostname()VERSAO = os.getenv("VERSAO", "v1")MODO = os.getenv("MODO", "memoria") # "memoria" = stateful, "redis" = statelessTRABALHO = float(os.getenv("TRABALHO_MS", "100")) / 1000CAPACIDADE = threading.Semaphore(int(os.getenv("CAPACIDADE", "2")))memoria = {} # carrinhos guardados no processo (stateful)r = Noneif MODO == "redis":import redis # só é importado quando precisar = redis.Redis(host=os.getenv("REDIS_HOST", "redis"), port=6379, decode_responses=True)class Handler(BaseHTTPRequestHandler):def responder(self, status, corpo, tipo="text/plain"):dados = corpo.encode()self.send_response(status)self.send_header("Content-Type", tipo)self.send_header("Content-Length", str(len(dados)))self.end_headers()self.wfile.write(dados)def responder_json(self, status, dados):# todo JSON diz quem respondeu (servidor) e em que modocorpo = json.dumps({"servidor": HOST, "modo": MODO, **dados}) + "\n"self.responder(status, corpo, "application/json")def do_GET(self):url = urlparse(self.path)q = parse_qs(url.query)if url.path == "/health":return self.responder(200, "ok\n")if url.path == "/carrinho":user = q.get("user", ["anonimo"])[0]# stateless: lê do Redis; stateful: lê da memória deste processoitens = r.lrange(f"carrinho:{user}", 0, -1) if r else memoria.get(user, [])return self.responder_json(200, {"user": user, "itens": itens})with CAPACIDADE:time.sleep(TRABALHO)self.responder(200, f"{HOST} {VERSAO}\n")def do_POST(self):url = urlparse(self.path)q = parse_qs(url.query)if url.path == "/carrinho":user = q.get("user", ["anonimo"])[0]item = q.get("item", ["?"])[0]if r:r.rpush(f"carrinho:{user}", item) # estado externalizadoelse:memoria.setdefault(user, []).append(item) # estado preso ao processoreturn self.responder_json(200, {"ok": True})if url.path == "/pedido":if r is None:return self.responder_json(503, {"erro": "sem fila (use MODO=redis)"})pedido = q.get("id", ["0"])[0]r.lpush("fila:pedidos", pedido) # produtor: publica na fila e responde járeturn self.responder_json(202, {"pedido": pedido, "status": "recebido"})self.responder(404, "nao encontrado\n")def log_message(self, formato, *args):# registra quem atendeu e o X-Request-ID (será útil na Etapa 06)print(f"[{HOST}] {self.command} {self.path} rid={self.headers.get('X-Request-ID', '-')}", flush=True)class Servidor(ThreadingHTTPServer):request_queue_size = 128if __name__ == "__main__":Servidor(("0.0.0.0", 8080), Handler).serve_forever()
Crie app/worker.py (o consumidor):
Comandos essenciais desta etapa
memoria): escolhe o modo da API antes de subir a stackMão na massa
Laboratório
1. O problema: carrinho stateful.
export MODO=memoriadocker compose up -d --build# Três itens, um por requisição; o LB distribui entre as réplicasfor i in 1 2 3; do curl -s -X POST "localhost:8080/carrinho?user=ana&item=item$i"; done# Agora lê o carrinho três vezesfor i in 1 2 3; do curl -s "localhost:8080/carrinho?user=ana"; done
Esperado (os IDs e a ordem variam):
{"servidor": "aaa111", "modo": "memoria", "user": "ana", "itens": ["item1"]}{"servidor": "bbb222", "modo": "memoria", "user": "ana", "itens": ["item2"]}{"servidor": "ccc333", "modo": "memoria", "user": "ana", "itens": ["item3"]}
Cada resposta tem um item só. O carrinho da Ana está espalhado em três memórias e nenhuma réplica o vê por inteiro. É o problema do estado preso ao servidor. (O zone no upstream faz os workers do Nginx compartilharem o round-robin, então as seis requisições percorrem as três réplicas em ordem e cada leitura cai na réplica que recebeu o item correspondente.)
2. A solução: estado no Redis.
docker compose downexport MODO=redisdocker compose up -dfor i in 1 2 3; do curl -s -X POST "localhost:8080/carrinho?user=ana&item=item$i"; donefor i in 1 2 3; do curl -s "localhost:8080/carrinho?user=ana"; donedocker compose exec redis redis-cli LRANGE carrinho:ana 0 -1
Esperado: as três respostas mostram "itens": ["item1", "item2", "item3"], vindas de servidores diferentes, e o redis-cli lista:
1) "item1"2) "item2"3) "item3"
3. Failover sem perder o carrinho.
docker stop $(docker compose ps -q app | head -n 1)curl -s "localhost:8080/carrinho?user=ana"
Esperado: o carrinho continua completo. Pode levar até cerca de 1 segundo se a requisição cair na réplica parada: o Nginx de código aberto só percebe a falha ao tentar, e o proxy_connect_timeout 1s limita a espera antes de ele passar para outra réplica. Suba a réplica de volta e atualize o Nginx, que resolve nomes só na partida (a réplica pode voltar com outro IP):
docker compose up -ddocker compose exec lb nginx -s reload
4. Fila e workers. O pedido volta rápido e o trabalho pesado acontece depois:
# Liga 1 worker (o MODO continua exportado, para não recriar a API em outro modo)docker compose up -d --scale worker=1# Enfileira 12 pedidos; cada resposta chega na hora com 202for i in $(seq 1 12); do curl -s -o /dev/null -w "%{http_code} %{time_total}s\n" -X POST "localhost:8080/pedido?id=$i"; done# Tamanho da filadocker compose exec redis redis-cli LLEN fila:pedidos
Esperado: doze linhas do tipo 202 0.00xs e um (integer) N com N entre 1 e 11, porque o worker já está consumindo. Veja o worker trabalhando (Ctrl+C para sair):
docker compose logs -f worker
Saída esperada (resumida):
lab-etapa-03-worker-1 | [9f8e7d6c5b4a] processando pedido 1lab-etapa-03-worker-1 | [9f8e7d6c5b4a] pedido 1 concluido
5. Escalar os workers pelo tamanho da fila. Espere a fila do passo anterior esvaziar (LLEN igual a 0, cerca de 12 s) para a medição não somar pedidos antigos. Depois meça o tempo para esvaziar a fila com 1 worker e com 3:
# Com 1 worker (12 pedidos de 1 s: perto de 12 s)for i in $(seq 1 12); do curl -s -o /dev/null -X POST "localhost:8080/pedido?id=$i"; donetime { while [ "$(docker compose exec -T redis redis-cli LLEN fila:pedidos | tr -d '\r')" != "0" ]; do sleep 0.5; done; }# Com 3 workers (perto de 4 s)docker compose up -d --scale worker=3for i in $(seq 1 12); do curl -s -o /dev/null -X POST "localhost:8080/pedido?id=$i"; donetime { while [ "$(docker compose exec -T redis redis-cli LLEN fila:pedidos | tr -d '\r')" != "0" ]; do sleep 0.5; done; }
Os workers escalaram independentemente da API, e foi o tamanho da fila que justificou o escalonamento. É a ideia do KEDA.
Exercícios
Os exercícios 1 e 3 precisam da stack no ar: export MODO=redis no exercício 1 e export MODO=memoria no exercício 3. Para trocar de modo, rode docker compose down, exporte o novo valor e docker compose up -d.
- KEDA à mão. Suponha que cada worker processa 1 pedido por segundo e você quer esvaziar a fila em até 4 segundos. Escreva a fórmula do número de workers em função do
LLEN(arredonde para cima) e teste com--scale. *Resposta esperada:*workers = ceil(LLEN / 4), porque cada worker dá conta de 4 pedidos em 4 segundos. Em Bash,n=$(( (LLEN + 3) / 4 )). ComLLENigual a 12, são 3 workers (docker compose up -d --scale worker=3) e a fila esvazia em cerca de 4 segundos. É a lógica que o KEDA automatiza. - Retry com backoff exponencial. Rode o script abaixo contra uma porta onde nada escuta. Durante a espera, em outro terminal, suba
docker run -d --rm -p 9999:8080 lab-appe veja o script ter sucesso.*Resposta esperada:* linhas comofor tentativa in 1 2 3 4 5; do# --fail trata HTTP de erro como falha; --max-time 2 limita a espera de cada tentativaif curl -sf --max-time 2 -o /dev/null http://localhost:9999/health; thenecho "ok na tentativa $tentativa"; breakfiespera=$((2 ** (tentativa - 1))) # espera 1, 2, 4, 8, 16 segundosecho "tentativa $tentativa falhou, esperando ${espera}s"sleep "$espera"donetentativa 1 falhou, esperando 1s,tentativa 2 falhou, esperando 2s, e assim por diante, até aparecerok na tentativa Nna primeira tentativa depois de o container subir. O intervalo dobra a cada falha, então o script insiste sem martelar o serviço. Se você não subir o container, as cinco tentativas falham e o script termina sem a linha deok. Ao final, pare o container de teste comdocker stop $(docker ps -q --filter publish=9999). - Sticky session, o remendo. Com a stack em
MODO=memoria, adicioneip_hash;aoupstream backendemnginx/default.conf(logo abaixo da linhaupstream backend {), rodedocker compose exec lb nginx -s reloade repita o teste do carrinho do passo 1 com um usuário novo (por exemplo,user=bia). Funciona? Agora derrube a réplica que atendeu (o campo"servidor"da resposta é o ID curto do container:docker stop ID) e leia o carrinho de novo. O que aconteceu, e por que isso limita a resiliência? *Resposta esperada:* comip_hash, todas as requisições do seu cliente (sempre o mesmo IP) caem na mesma réplica, então as três leituras mostram["item1", "item2", "item3"], sempre com o mesmo"servidor": o remendo funciona enquanto essa réplica vive. Depois dodocker stop, a próxima leitura é desviada para outra réplica (possivelmente com cerca de 1 s de espera) e volta com"itens": []. O carrinho morava na memória da réplica que caiu e morreu com ela. A sticky session não tira o estado do servidor, só esconde o problema: a falha de uma instância continua perdendo dados dos clientes presos a ela, e a carga se distribui pelo IP, não pela capacidade. Ao terminar, apague a linhaip_hash;, rodedocker compose up -dpara recriar a réplica edocker compose exec lb nginx -s reload. - ReplicaSet (leitura). No YAML do segundo exemplo comentado, mapeie cada campo ao Compose: quem é o
replicas, quem é a imagem, e o que não tem equivalente direto? *Resposta esperada:*spec.replicas: 3corresponde adeploy.replicas: 3; oimagedentro detemplate.spec.containerscorresponde aoimage:do serviço; otemplateinteiro é o molde, como a definição de um serviço no Compose;metadata.namefaz o papel do nome do serviço;containerPort: 80documenta a porta, como oEXPOSEdo Dockerfile. OselectorcommatchLabelsnão tem equivalente que você escreva no Compose: ali as réplicas são agrupadas pelo nome do serviço, enquanto no Kubernetes o ReplicaSet encontra "os seus" Pods pelo rótuloapp: carrinho.
Limpeza (ao terminar o laboratório e os exercícios):
docker compose down -vunset MODOcd ..
Dica: Para descobrir se uma aplicação é stateless, faça o teste deste laboratório: grave algo numa requisição, derrube a réplica que atendeu e leia na próxima. Se o dado sumiu, há estado preso ao processo, e nenhum ajuste no load balancer resolve isso.
Anota aí: Se o estado mora no servidor, o servidor não pode morrer nem ser trocado; tire o estado para fora (Redis, banco) e tire o trabalho lento do caminho da resposta (fila e workers).
Etapa 04 cache na borda
CDNs e performance global
O problema
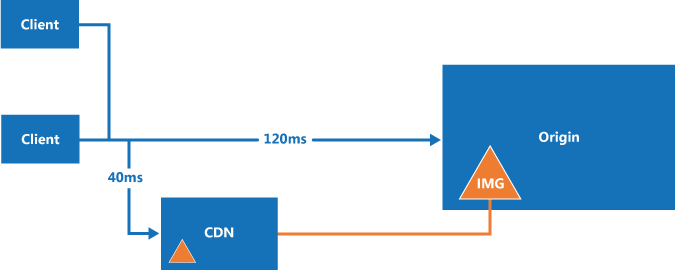
Seus servidores estão no Brasil e funcionam bem para usuários locais. Mas um cliente em Lisboa, Tóquio ou Nova York sofre com a latência imposta pela distância e pelos cabos submarinos: centenas de milissegundos antes mesmo de o processamento começar. Nenhum servidor potente vence a física, porque a latência depende da velocidade da luz e da distância. A saída é aproximar o conteúdo do usuário, e é isso que uma CDN (Content Delivery Network) faz. Ela é, também, uma camada de segurança e de escalabilidade, porque a maior parte das requisições nem chega à sua origem.
O conceito
Uma CDN é uma rede global de servidores proxy instalados em pontos de troca de tráfego (IXPs), chamados PoPs (Points of Presence) ou Edge Locations, que guardam cópias do conteúdo perto do usuário. O servidor onde o conteúdo original mora é a origem.
Como funciona:
- Geolocalização via DNS. A consulta DNS vai para o DNS inteligente da CDN, que identifica a localização pelo IP e devolve o IP do PoP mais próximo, em vez do IP da origem.
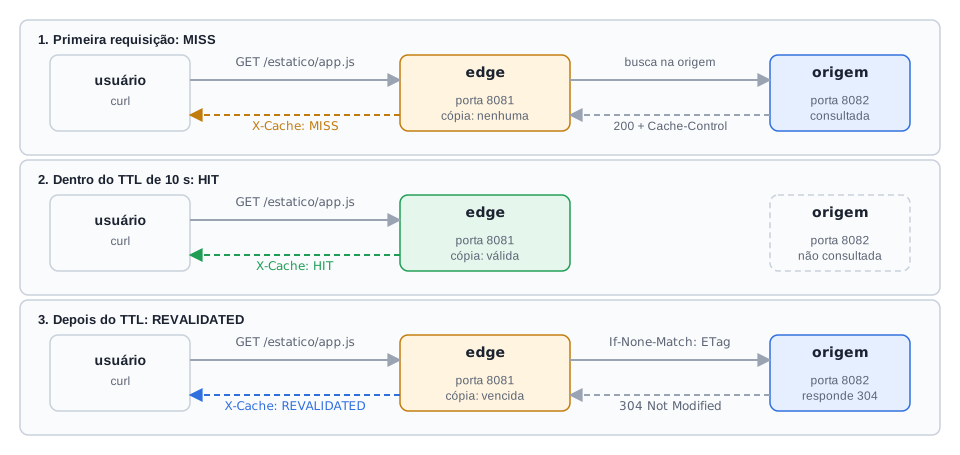
- Edge caching. O PoP (por exemplo, Paris) verifica o cache local. Na primeira vez há um Cache Miss: ele busca na origem no Brasil, entrega e guarda uma cópia. O próximo usuário da região tem um Cache Hit, servido instantaneamente da borda.
Controle de cache. Quem decide por quanto tempo uma cópia vale é a origem, pelo cabeçalho Cache-Control. O max-age define o TTL em segundos: Cache-Control: public, max-age=3600 guarda por uma hora. Expirado, o arquivo fica *stale* e é revalidado com a origem; se não mudou, a origem responde 304 Not Modified e a CDN renova o TTL sem baixar o arquivo de novo. Para perguntar "mudou?", usa-se o ETag, um identificador da versão do arquivo, enviado de volta no cabeçalho If-None-Match.
Invalidação (purging). É remover à força arquivos de todos os caches, por painel ou API (por exemplo, para um bug fix urgente num JavaScript). Use com critério: pode custar dinheiro e reduz a eficiência do cache.
Além de assets estáticos. CDNs também escalam APIs: respostas GET que mudam pouco (um catálogo de produtos) podem ser cacheadas na borda, aliviando aplicação e banco. Players citados: Amazon CloudFront, Akamai e Fastly.
Segurança e performance na borda:
- WAF integrado à CDN bloqueia SQL Injection e XSS na borda.
- TLS Offload: a CDN faz o handshake TLS (caro em CPU) nos servidores de borda otimizados e mantém uma conexão segura otimizada com a origem.
Infraestrutura e observabilidade. CDNs usam BGP para anunciar as rotas mais eficientes para seus PoPs e acordos de peering (conexões diretas com grandes provedores) para reduzir saltos. As métricas principais são o Cache Hit Ratio (a mais importante), a economia de banda, a latência de resposta e a taxa de erros.
No mercado (segundo o material): patches de Fortnite e League of Legends (dezenas de GB) são pré-posicionados nos PoPs dias antes do lançamento. Edge Computing (AWS Lambda@Edge, Cloudflare Workers) executa código nos PoPs: renderização, testes A/B, manipulação de imagens, autenticação na borda. Dynamic Content Acceleration (Akamai, Fastly) acelera até conteúdo não cacheável com otimização TCP/IP e roteamento inteligente (BGP e peering).
Como o laboratório se encaixa. Uma CDN real tem centenas de PoPs, mas o mecanismo de um PoP é um proxy com cache. Montaremos duas instâncias de Nginx: a origem (que define o Cache-Control) e a borda (que cacheia e informa o resultado no cabeçalho X-Cache). No CloudFront, o *Origin* é a origem, o *Behavior* é a regra de tratamento e tempo de cache por tipo de requisição, e o domínio fornecido pela CDN é a borda. A aula também usa as ferramentas de desenvolvedor do navegador como "detetive de performance"; aqui o detetive é o curl.
Os conceitos-chave
CDN, PoP e origem
rede de proxies com cache perto do usuário, na frente do servidor original.
DNS inteligente
devolve o IP do PoP mais próximo do usuário.
Cache miss e cache hit
a borda precisou ir à origem, ou respondeu com a cópia guardada.
Cache-Control e max-age
a origem define se e por quanto tempo a resposta pode ser guardada.
ETag, If-None-Match e 304
revalidação sem baixar o arquivo de novo.
Invalidação (purge)
apagar cópias antes do TTL; útil, mas gera novos misses.
Cache hit ratio
hits / (hits + misses), a métrica principal de uma CDN.
WAF e TLS offload
segurança e criptografia resolvidas na borda.
Origem e borda
$ mkdir -p etapa-04/origem etapa-04/edge etapa-04/site/estatico && cd etapa-04$ echo 'console.log("v1");' > site/estatico/app.js$ echo '<h1>Loja</h1>' > site/index.html
docker-compose.yml:
Comandos essenciais desta etapa
Mão na massa
Laboratório
1. Detetive de performance na origem. Inspecione os cabeçalhos:
curl -sI http://localhost:8082/estatico/app.js
Esperado (resumido):
HTTP/1.1 200 OK...ETag: "6650a1b2-14"Cache-Control: public, max-age=10
2. O 304 acontecendo. Pegue o ETag e pergunte "mudou?":
ETAG=$(curl -sI http://localhost:8082/estatico/app.js | tr -d '\r' | awk 'tolower($1)=="etag:" {print $2}')curl -sI -H "If-None-Match: $ETAG" http://localhost:8082/estatico/app.js
Esperado: HTTP/1.1 304 Not Modified, sem corpo. O servidor confirmou que a cópia ainda vale sem reenviar o arquivo.
3. Miss e hit na borda.
for i in 1 2 3; do curl -s -D - -o /dev/null http://localhost:8081/estatico/app.js | tr -d '\r' | grep -i '^x-cache'; done
Esperado:
X-Cache: MISSX-Cache: HITX-Cache: HIT
4. Cache Hit Ratio. Vinte requisições e a contagem:
for i in $(seq 1 20); do curl -s -D - -o /dev/null http://localhost:8081/estatico/app.js | tr -d '\r' | grep -i '^x-cache'; done | sort | uniq -c
Esperado: 20 X-Cache: HIT se você rodou logo depois do passo 3 (dentro dos 10 s de TTL). Se já passaram mais de 10 s, o resultado é 1 X-Cache: REVALIDATED e 19 X-Cache: HIT: a borda já tem a cópia, então a primeira resposta depois do TTL revalida com a origem, e MISS não aparece (o MISS só acontece quando a borda não tem nada guardado, como no passo 3). Conte o REVALIDATED como uma ida à origem: o hit ratio fica em 20 de 20 (100%) ou 19 de 20 (95%). Confirme que a origem quase não foi incomodada:
docker compose logs origem | grep 'app.js' | wc -l
Esperado: 4 ou 5. A conta é esta:
- 3 linhas dos
curl -sIque você mandou direto à origem, na porta 8082 (uma no passo 1 e duas no passo 2); - 1 linha da borda, o
MISSdo passo 3; - mais 1 linha só se o TTL venceu e houve revalidação (o
304).
O que importa: das 20 requisições deste passo, a origem viu no máximo uma.
5. Expiração e revalidação. Espere o TTL passar e peça de novo:
sleep 11curl -s -D - -o /dev/null http://localhost:8081/estatico/app.js | tr -d '\r' | grep -i '^x-cache'docker compose logs origem | grep 'app.js' | tail -n 3
Esperado: X-Cache: REVALIDATED e, nos logs da origem, uma linha com 304. A borda perguntou, a origem respondeu "não mudou" e o TTL foi renovado sem transferir o arquivo.
6. Arquivo que mudou: expira e baixa de novo.
echo 'console.log("v2");' > site/estatico/app.jscurl -s http://localhost:8081/estatico/app.js # ainda v1, dentro do TTLsleep 11curl -s -D - http://localhost:8081/estatico/app.js | tr -d '\r' | grep -iE '^x-cache|console'
Esperado: a primeira chamada mostra console.log("v1"); (cópia da borda, ainda válida). Depois do TTL, aparecem X-Cache: EXPIRED e console.log("v2");. Entre a mudança e o fim do TTL, os usuários viram a versão antiga: é a janela de defasagem que todo TTL aceita. Se a primeira chamada já mostrar v2, o TTL do passo anterior tinha vencido; repita o passo com uma nova edição.
7. Invalidação (purge) simulada. O Nginx de código aberto não tem API de purge; simulamos apagando o cache. Primeiro encha o cache, depois "invalide":
echo 'console.log("v3");' > site/estatico/app.jscurl -s http://localhost:8081/estatico/app.js # v2 ou v3, conforme o estado do cachedocker compose exec edge sh -c 'rm -rf /var/cache/nginx/edge/*'docker compose restart edgecurl -s -D - http://localhost:8081/estatico/app.js | tr -d '\r' | grep -iE '^x-cache|console'
Esperado: X-Cache: MISS e console.log("v3");, na hora, sem esperar o TTL. Uma CDN real faz isso por API ou painel, e é por isso que invalidar demais custa eficiência: cada purge obriga um novo miss.
Exercícios
Os exercícios 1 e 2 precisam da stack no ar. Depois de editar origem/default.conf, rode docker compose exec origem nginx -s reload.
- Cachear a API. Em
origem/default.conf, adicioneadd_header Cache-Control "public, max-age=60";nolocation /api/e recarregue. Faça 10 chamadas alocalhost:8081/api/produtosantes e depois da mudança, olhando oX-Cache. O que muda? Que tipo de resposta de API é segura de cachear assim? *Resposta esperada:* antes, as 10 chamadas aparecem comoMISS, porque a resposta não trazCache-Controle a borda não a guarda (a origem é consultada toda vez); depois, a primeira éMISSe as 9 seguintes sãoHIT(dentro dos 60 s). É seguro para respostas GET públicas, iguais para todos os usuários e que mudam pouco, como o catálogo de produtos; não serve para respostas personalizadas. - Quando não cachear. Troque o valor por
Cache-Control "private, no-store". OX-Cachevolta a serHIT? Por que dados de um usuário logado não deveriam ficar numa borda compartilhada? *Resposta esperada:* não. Depois que a cópia de 60 s do exercício anterior expirar (ou for apagada, como no passo 7), as chamadas voltam a serMISS, porqueno-storeproíbe a borda de guardar a resposta. Dados de um usuário logado numa borda compartilhada poderiam ser entregues a outra pessoa, eprivateindica que só o navegador do próprio usuário pode guardá-los. - Quanto cachear? Para cada item, escolha um TTL e justifique: logo da empresa, bundle JavaScript versionado, catálogo de produtos, saldo bancário do usuário. *Resposta esperada (exemplos):* logo da empresa, TTL longo (dias), porque quase nunca muda; bundle JavaScript versionado, TTL muito longo (meses), porque o nome do arquivo muda a cada versão e a cópia nunca fica velha; catálogo de produtos, TTL curto (de segundos a poucos minutos), aceitando uma pequena defasagem; saldo bancário, não cachear (
private, no-store), porque é dado pessoal e muda o tempo todo. - Conceitual. Explique, em três frases, por que o DNS inteligente da CDN faz o usuário de Lisboa falar com o PoP de Paris e não com o servidor no Brasil. *Resposta esperada:* quando o navegador pergunta o endereço do site, a consulta chega ao DNS inteligente da CDN. Esse DNS identifica a localização do usuário pelo IP e devolve o IP do PoP mais próximo (Paris), em vez do IP da origem. O navegador então se conecta a esse PoP, que responde do cache (hit) e só vai ao Brasil se não tiver a cópia (miss).
Limpeza (ao terminar o laboratório e os exercícios):
docker compose down -vcd ..
Dica: Para arquivos estáticos, prefira nomes versionados (por exemplo, app.3f9c.js) com TTL longo a TTLs curtos com purge frequente. Quando o conteúdo muda, o nome muda, e a cópia antiga simplesmente deixa de ser pedida, sem invalidação e sem janela de defasagem.
Anota aí: A CDN é cache perto do usuário; quem manda nela é o Cache-Control da origem, e a métrica que importa é o Cache Hit Ratio.
Etapa 05 réplicas + cache + CAP
Escalabilidade de banco de dados
O problema
A aplicação está escalada, há load balancer e há CDN. Mas quase toda ação relevante (compra, post, busca) lê ou escreve dados, e tudo aponta para um único lugar: o banco de dados, a parte mais difícil de escalar. Ele é stateful e precisa de consistência, então não dá para simplesmente "ligar mais três" como fizemos com a API: três bancos independentes teriam três versões do estoque. Numa Black Friday, o banco relacional sobrecarregado costuma ser exatamente o ponto que derruba tudo.
O conceito
Os três desafios:
- Consistência: uma transação atômica, e leituras subsequentes vendo o resultado correto.
- Concorrência: múltiplos acessos simultâneos sem corromper dados.
- Latência: operações rápidas mesmo com mais volume.
Escalando leitura. A proporção de leitura para escrita costuma ser alta (por exemplo, 100 para 1). Duas ferramentas:
- Caching (Redis, Memcached) entre a aplicação e o banco: a primeira linha de defesa. O padrão cache-aside funciona assim: a aplicação tenta o cache; se houver *miss*, busca no banco e grava no cache antes de retornar.
- Read Replicas: modelo primary-replica (antes chamado master-slave). O primary recebe todas as escritas (INSERT, UPDATE, DELETE) e as replica, geralmente de forma assíncrona, para réplicas somente leitura. A aplicação implementa o write splitting: escritas no primary, leituras distribuídas entre as réplicas.
Escalando escrita. Mesmo com réplicas, todas as escritas ainda vão para um servidor. A solução é o sharding (particionamento horizontal): os dados são divididos entre bancos menores e independentes, cada um responsável por uma parte.
- Por range (A a M no shard 1, N a Z no shard 2): simples, mas cria *hotspots* se a distribuição não é uniforme.
- Por hash (hash do ID do usuário): distribuição mais equitativa, mas dificulta consultas por faixa.
A complexidade é imensa, especialmente no re-sharding (mudar o número de shards e redistribuir os dados).
Bancos distribuídos. Amazon DynamoDB (NoSQL), CockroachDB (NewSQL) e Apache Cassandra (NoSQL) fazem sharding e replicação de forma transparente. No DynamoDB, a demonstração da aula configura "unidades de capacidade de leitura e escrita", ou seja, você declara quanta leitura e escrita espera.
Teorema CAP (Eric Brewer). Três propriedades de um sistema distribuído:
- Consistência: todos os nós veem o mesmo dado.
- Disponibilidade: toda requisição recebe resposta, sem garantia de ser a escrita mais recente.
- Tolerância a Partição: o sistema opera mesmo com quebra de comunicação entre nós.
Como partições de rede são inevitáveis, a escolha real é o que fazer durante uma delas: priorizar consistência (CP) ou disponibilidade (AP). Relacionais tradicionais tendem a CP; o Cassandra escolhe AP, o que leva à Consistência Eventual: sem novas escritas, as réplicas convergem, mas por um tempo nós diferentes podem retornar valores diferentes.
Estratégia e resiliência. Escalar verticalmente ainda pode ser o mais simples e eficaz até certo ponto; a escala horizontal é mais complexa, com teto maior e mais resiliência. O failover automatizado promove uma réplica a primary quando o primary cai. Dois números definidos pelo negócio guiam o desenho:
- RPO (Recovery Point Objective): quanta perda de dados é tolerável. RPO de 5 minutos significa aceitar perder os últimos 5 minutos de transações.
- RTO (Recovery Time Objective): quanto tempo o sistema pode ficar fora. RTO de 15 minutos significa que detecção, failover e retorno devem levar menos de 15 minutos.
Eles ditam a escolha entre replicação síncrona e assíncrona e o nível de automação do failover.
No mercado (segundo o material): o Google Spanner entrega consistência forte global com alta disponibilidade usando relógios atômicos, e o CockroachDB leva essa ideia ao mercado sem o hardware do Google. Bancos serverless (Aurora Serverless, MongoDB Atlas Serverless, Neon para Postgres) separam computação de armazenamento e escalam até zero. HTAP (SingleStore, TiDB) une OLTP e OLAP num sistema só, evitando ETL e permitindo análise em tempo real.
Como o laboratório se encaixa. No Amazon RDS, criar uma Read Replica são poucos cliques e a AWS gerencia a replicação assíncrona. Aqui você fará à mão, com Postgres, o que o RDS esconde: uma réplica por *streaming replication* assíncrona. Também aplicará cache-aside com Redis.
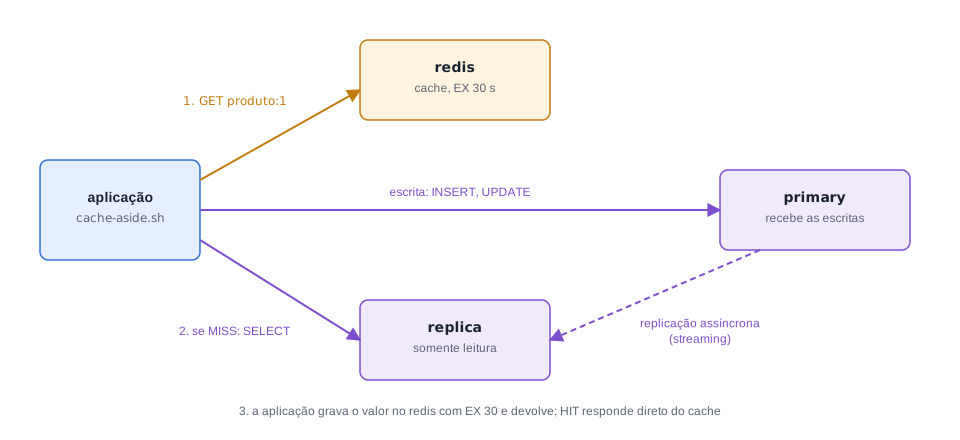
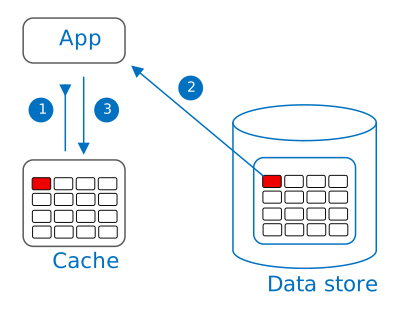
cache-aside.sh faz.Diagrama: Azure Architecture Center, Microsoft, CC BY 4.0Os conceitos-chave
Cache-aside
cache primeiro; no miss, banco, e grava no cache antes de responder.
Primary e read replica
um nó aceita escritas; as réplicas, só leituras.
Replicação assíncrona
o primary não espera a réplica; ela pode ficar um pouco atrasada.
Write splitting
a aplicação manda escrita para o primary e leitura para as réplicas.
Sharding por range e por hash
dividir os dados para escalar escrita; range sofre com hotspots, hash dificulta consultas por faixa.
Re-sharding
mudar o número de shards obriga a mover dados.
CAP e consistência eventual
durante uma partição, escolhe-se entre consistência e disponibilidade.
Failover, RPO e RTO
promover uma réplica; quanto dado se aceita perder e quanto tempo se aceita ficar fora.
Exemplos comentados
$ mkdir -p etapa-05 && cd etapa-05
init-primary.sh (roda uma vez, na criação do primary):
Comandos essenciais desta etapa
f no primary, t numa réplicaSELECT pg_wal_replay_resume();: na réplica, pausam e retomam a aplicação das mudançasSET chave valor EX 30, TTL e DEL: ler, gravar com validade, consultar a validade e invalidar uma chavedocker network connect: simulam e desfazem uma partição de redeMão na massa
Laboratório
1. Quem é quem.
docker compose exec primary psql -U postgres -c "SELECT pg_is_in_recovery();"docker compose exec replica psql -U postgres -c "SELECT pg_is_in_recovery();"
Esperado: f no primary e t na réplica (a réplica está em modo de recuperação, ou seja, seguindo o primary).
2. A replicação está viva (e é assíncrona).
docker compose exec primary psql -U postgres -c "SELECT client_addr, state, sync_state FROM pg_stat_replication;"
Esperado:
client_addr | state | sync_state-------------+-----------+------------172.x.x.x | streaming | async
3. Escreva no primary, leia na réplica.
docker compose exec primary psql -U postgres -c "CREATE TABLE produtos (id int primary key, nome text); INSERT INTO produtos VALUES (1,'Camiseta'),(2,'Caneca');"sleep 1docker compose exec replica psql -U postgres -c "SELECT * FROM produtos;"
Esperado: as duas linhas aparecem na réplica.
4. A réplica não aceita escrita.
docker compose exec replica psql -U postgres -c "INSERT INTO produtos VALUES (9,'Intruso');"
Esperado: ERROR: cannot execute INSERT in a read-only transaction. É por isso que a aplicação precisa do write splitting.
5. Consistência eventual, ao vivo. Pause a aplicação das mudanças na réplica, escreva no primary e compare:
docker compose exec replica psql -U postgres -c "SELECT pg_wal_replay_pause();"docker compose exec primary psql -U postgres -c "INSERT INTO produtos VALUES (3,'Boné');"echo "primary:"; docker compose exec primary psql -U postgres -tA -c "SELECT count(*) FROM produtos;"echo "réplica:"; docker compose exec replica psql -U postgres -tA -c "SELECT count(*) FROM produtos;"
Esperado: 3 no primary e 2 na réplica. Agora retome:
docker compose exec replica psql -U postgres -c "SELECT pg_wal_replay_resume();"sleep 1docker compose exec replica psql -U postgres -tA -c "SELECT count(*) FROM produtos;"
Esperado: 3. Por um tempo, dois nós responderam coisas diferentes e depois convergiram: consistência eventual.
6. Cache-aside com Redis, lendo da réplica. Use o cache-aside.sh do segundo exemplo comentado:
bash cache-aside.sh 1bash cache-aside.sh 1bash cache-aside.sh 1docker compose exec redis redis-cli TTL produto:1
Esperado: MISS Camiseta, depois HIT Camiseta duas vezes, e um (integer) entre 1 e 30 (os segundos restantes de vida da chave).
7. O preço do cache: dado velho. A chave do cache vive só 30 s, então rode este passo logo depois do passo 6. Se passou mais que isso, rode bash cache-aside.sh 1 antes do UPDATE para repovoar o cache; caso contrário o dado velho não aparece (você veria MISS Camiseta Azul direto). Altere o dado e releia:
docker compose exec primary psql -U postgres -c "UPDATE produtos SET nome='Camiseta Azul' WHERE id=1;"bash cache-aside.sh 1
Esperado: HIT Camiseta. O cache serve o valor antigo até expirar. Invalide ao escrever:
docker compose exec redis redis-cli DEL produto:1sleep 1 # dá tempo para a réplica receber o UPDATE (a replicação é assíncrona)bash cache-aside.sh 1
Esperado: MISS Camiseta Azul. Se aparecer MISS Camiseta, a leitura chegou à réplica antes da mudança: é o atraso de replicação da consistência eventual. Repita o DEL e a leitura. Quem escreve precisa invalidar o cache (ou aceitar o TTL como janela de defasagem).
Exercícios
Faça os exercícios na ordem: o 2 e o 3 alteram o estado do laboratório.
- Sharding por hash, e o custo do re-sharding. Distribua 10 IDs em 2 shards pelo módulo (um hash bem simples) e, depois, veja quantos IDs trocam de shard ao passar para 3 shards:Esperado:for id in $(seq 1 10); do echo "usuario $id -> shard $((id % 2))"; donemudou=0for id in $(seq 1 1000); do# compara o shard antigo (2 shards) com o novo (3 shards)if [ $((id % 2)) -ne $((id % 3)) ]; then mudou=$((mudou + 1)); fidoneecho "IDs que trocaram de shard: $mudou de 1000"
IDs que trocaram de shard: 667 de 1000. Cerca de dois terços dos dados precisariam migrar: é a dor do re-sharding. Bancos como Cassandra e DynamoDB fazem esse trabalho de forma transparente. Pergunta: e o sharding por range, que problema ele tem? *Resposta esperada:* hotspots. Como cada shard recebe uma faixa fixa de valores, se os dados ou os acessos não se distribuem por igual entre as faixas, um shard fica sobrecarregado enquanto os outros ficam ociosos. Dois exemplos: na divisão A a M e N a Z, nomes concentrados em certas letras pesam mais num dos lados; numa divisão por faixa de ID crescente (ou de data), todas as escritas novas caem no último shard. Em troca, o range facilita consultas por faixa, que é justamente o que o hash dificulta. - Partição de rede (CAP na prática). Desconecte a réplica da rede, escreva no primary e leia dos dois lados:Esperado: o primary com uma linha a mais que a réplica. A réplica respondeu (disponibilidade) com dado desatualizado (sem consistência). Reconecte comdocker network disconnect lab-etapa-05_default $(docker compose ps -q replica)docker compose exec primary psql -U postgres -c "INSERT INTO produtos VALUES (4,'Chaveiro');"docker compose exec primary psql -U postgres -tA -c "SELECT count(*) FROM produtos;"docker compose exec replica psql -U postgres -tA -c "SELECT count(*) FROM produtos;"
docker network connect lab-etapa-05_default $(docker compose ps -q replica)e espere até cerca de 1 minuto: a conexão de replicação antiga pode ficar pendurada até owal_receiver_timeoutestourar (60 s por padrão), e a réplica pode voltar com outro IP. Para acompanhar, rodedocker compose exec replica psql -U postgres -c "SELECT status FROM pg_stat_wal_receiver;"; quando a replicação volta, o status éstreaming. Rode ocount(*)de novo e confira que os números convergem. Pergunta: se a sua prioridade fosse consistência, o que a réplica deveria ter feito durante a partição? *Resposta esperada:* escolhendo consistência (CP), a réplica deveria recusar a leitura, devolvendo erro ou saindo de rotação, enquanto não pudesse confirmar que está em dia com o primary; o preço é a disponibilidade durante a partição. O laboratório mostrou o outro lado, a escolha por disponibilidade (AP): a réplica respondeu com o que tinha, e os nós convergiram depois (consistência eventual). - Failover manual e o RTO. Derrube o primary e promova a réplica:Esperado:docker compose stop primarytime docker compose exec replica psql -U postgres -c "SELECT pg_promote();"docker compose exec replica psql -U postgres -c "SELECT pg_is_in_recovery();"docker compose exec replica psql -U postgres -c "INSERT INTO produtos VALUES (5,'Adesivo');"
pg_promotedevolvet,pg_is_in_recoverypassa afe o INSERT funciona. Você acaba de fazer um failover. Perguntas: que parte do RTO foi automática, e qual dependeu de você? Com replicação assíncrona, o que pode ter ficado para trás no momento da queda (qual RPO você aceitou)? Para recomeçar o laboratório depois, rodedocker compose down -ve suba tudo de novo. *Resposta esperada:* quase nada do RTO foi automático: perceber a queda, decidir promover e rodar opg_promotedependeram de você (um serviço gerenciado como o RDS automatiza a detecção e a promoção). Quanto ao RPO, com replicação assíncrona as transações já confirmadas no primary que ainda não tinham chegado à réplica no instante da queda se perdem; com rede local costuma ser pouco ou nada, mas não há garantia, e é essa janela que o RPO mede. - RPO e RTO. O negócio define RPO de 5 minutos e RTO de 15. Replicação síncrona ou assíncrona? O failover pode ser manual? Justifique. *Resposta esperada:* a replicação assíncrona basta, porque o negócio aceita perder até 5 minutos de transações, desde que o atraso da réplica seja monitorado e fique dentro desse limite; a síncrona só seria necessária se o RPO fosse próximo de zero. O failover pode ser manual se a equipe conseguir detectar, decidir e promover com folga dentro dos 15 minutos (com plantão e um roteiro testado); automatizá-lo reduz o risco de estourar o RTO e de erro humano, ao custo de mais complexidade.
Limpeza (ao terminar o laboratório e os exercícios):
docker compose down -vcd ..
Dica: Depois de promover uma réplica, não religue o primary antigo como se nada tivesse acontecido. Ele pode ter transações que a réplica nunca recebeu e passaria a aceitar escritas em paralelo com o novo primary. O caminho seguro é reconstruí-lo como réplica do novo primary.
Anota aí: Leitura se escala com cache e réplicas; escrita só se escala particionando (sharding), e todo o resto é escolher, conscientemente, entre consistência e disponibilidade.
Etapa 06 observabilidade
Arquiteturas escaláveis no mundo real
O problema
Você tem todas as peças (fundamentos, load balancer, padrões, CDN, banco), mas peças soltas não são uma arquitetura. Considere o caso de um e-commerce fictício: um monolito tradicional, com aplicação e banco no mesmo servidor, caiu na Black Friday. Onde exatamente estava a falha? E, depois de reconstruir, como saber onde está o próximo gargalo? Esta etapa pede a visão de arquiteto: a planta completa, cada peça justificada, e os instrumentos para enxergar o sistema funcionando.
O conceito
Serverless. Com o AWS Lambda, temos a máxima abstração: a pessoa desenvolvedora envia a função e o provedor provisiona, aplica patches e escala. São centenas de execuções por segundo, e o sistema volta a zero (inclusive o custo) quando a demanda some.
Monolito escalável vs microsserviços:
Lei de Conway: a arquitetura reflete a estrutura de comunicação da organização. Times pequenos e autônomos tendem a microsserviços; times centralizados tendem a monolitos.
Onde está o gargalo? Observabilidade. O gargalo pode estar em CPU, memória, I/O de disco, uma query, uma API de terceiro, a latência de rede ou um cache mal configurado. Sem instrumentos, a investigação vira palpite. Os três pilares:
O que costura os três é um identificador comum: o mesmo ID de requisição registrado em cada camada por onde ela passa. No laboratório, é o cabeçalho X-Request-ID.
Como os grandes fazem (segundo o material): o Google tem a cultura SRE (operações como problema de software, automação, error budgets e SLOs). A Amazon pratica "you build it, you run it": cada time opera e escala o seu serviço. O Nubank é nativo da nuvem, com microsserviços, Clojure e Datomic para consistência em ambiente distribuído, forte cultura de automação e testes num negócio regulado, e observabilidade robusta para crescimento explosivo. A tendência SRE troca times de "Operações" por SRE, com SLOs, error budgets e autoridade para priorizar estabilidade quando o orçamento de erro estoura. A tendência Platform Engineering monta uma Internal Developer Platform (IDP) com CI/CD, IaC, observabilidade e segurança como serviço, reduzindo a carga cognitiva dos times de produto.
SLO e error budget. O SLO é a meta de confiabilidade (por exemplo, 99,9% de disponibilidade no mês). O que sobra até 100% é o orçamento de erro: enquanto há folga, o time pode arriscar mais (deploys frequentes, experimentos); quando o orçamento acaba, a prioridade passa a ser estabilidade.
O estudo de caso: refatoração do e-commerce. O monolito com aplicação e banco no mesmo servidor caiu na Black Friday. Os pontos de falha: falta de load balancer, aplicação stateful, banco sobrecarregado, ausência de CDN. O redesenho, passo a passo, amarra cada etapa deste guia:
Resultado: de uma arquitetura frágil a um sistema distribuído, resiliente e escalável.
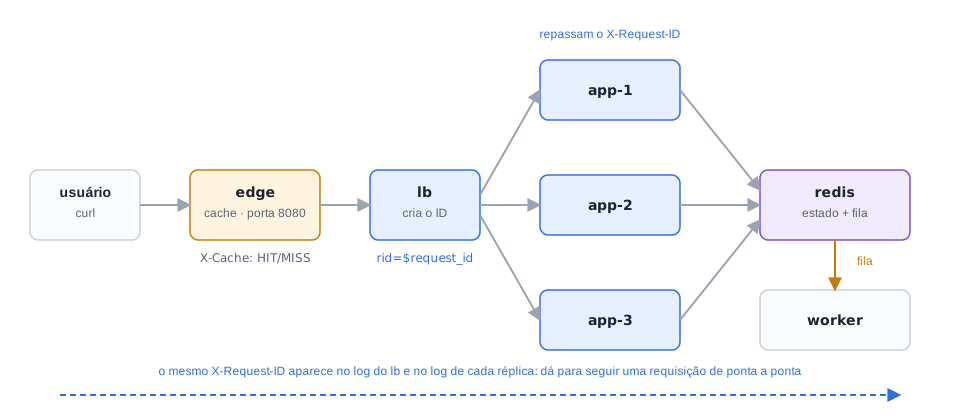
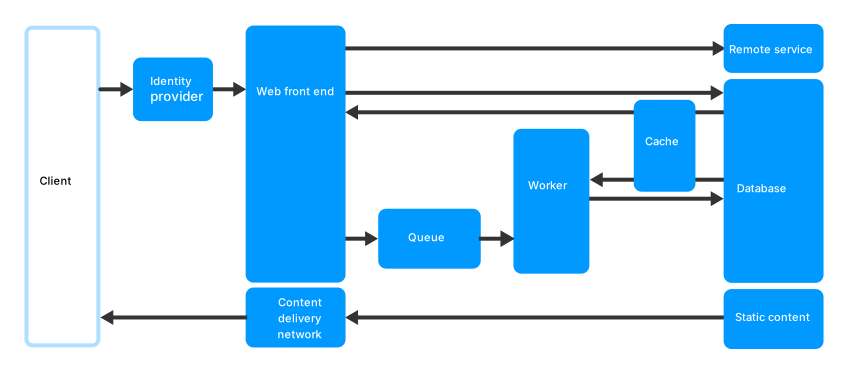
Os conceitos-chave
Serverless
o provedor cuida de servidor e escala; o custo vai a zero sem demanda.
Monolito escalável
um processo só, stateless, replicado atrás de um load balancer.
Microsserviços
serviços por capacidade de negócio; escala granular com custo operacional alto.
Lei de Conway
a arquitetura espelha a organização.
Métricas, logs e traces
o quê, por quê e onde.
ID de requisição
o fio que liga a mesma requisição em todas as camadas.
SLO e error budget
a meta de confiabilidade e a folga que ela deixa.
Exemplos comentados
Vamos montar a versão "depois" do caso: borda (CDN) → load balancer → 3 réplicas stateless → Redis (estado e fila) → worker. A parte de banco com réplica de leitura você já construiu na Etapa 05; ela se encaixa atrás da API da mesma forma (exercício 5). Aqui o foco é a cadeia de requisição e a observabilidade, para o compose não ficar enorme.
$ mkdir -p etapa-06/edge etapa-06/lb etapa-06/site/estatico && cd etapa-06$ echo 'console.log("loja");' > site/estatico/app.js
docker-compose.yml:
Comandos essenciais desta etapa
Mão na massa
Laboratório
1. Sobe e verifica.
docker compose up -d --buildsleep 3bash verificar.sh
Esperado:
OK asset servido pela borda (HIT)OK requisições distribuídas em 3 réplicasOK carrinho visível em qualquer réplicaOK pedido aceito de forma assíncrona (202)
2. Resiliência: derrube uma réplica.
docker stop $(docker compose ps -q app | head -n 1)for i in $(seq 1 20); do curl -s -o /dev/null -w "%{http_code}\n" "localhost:8080/"; done | sort | uniq -c
Esperado: 20 200. Suba de volta e atualize o Nginx, que resolve nomes só na partida (a réplica pode voltar com outro IP):
docker compose up -ddocker compose exec lb nginx -s reload
3. Antes e depois, em números. Use a função de carga da Etapa 01 (redefina se abriu um terminal novo) contra a arquitetura e contra um "monolito" de uma instância só:
carga() { time (seq 1 100 | xargs -P 20 -I{} curl -s -o /dev/null "$1"); }# Depois: borda, LB e 3 réplicascarga http://localhost:8080/# Antes: uma instância stateful, sem LB e sem bordadocker run -d --name monolito -p 8090:8080 -e MODO=memoria lab-appcarga http://localhost:8090/
Esperado: cerca de 1,7 s contra cerca de 5 s. Agora o ponto único de falha:
docker stop monolitocurl -s -o /dev/null -w "%{http_code}\n" --max-time 2 localhost:8090/
Esperado: 000. Remova com docker rm monolito.
4. Observabilidade: os três pilares com o que temos.
*Métricas* (o quê):
docker stats --no-stream
Esperado: uma tabela com CPU e memória de cada container (NAME, CPU %, MEM USAGE / LIMIT...).
*Logs* (por quê). A aplicação registra cada requisição:
curl -s "localhost:8080/carrinho?user=ana" > /dev/nulldocker compose logs --no-color app | tail -n 3
Esperado: linhas como app-2 | [9f8e7d6c5b4a] GET /carrinho?user=ana rid=4c1d....
*Traces* (onde). Siga um ID de requisição pelas camadas:
RID=$(docker compose logs --no-color lb | grep carrinho | tail -n 1 | grep -o 'rid=[a-f0-9]*')[ -n "$RID" ] || echo "nenhum rid encontrado: rode antes o curl do carrinho do passo anterior"echo "seguindo $RID"docker compose logs --no-color lb app | grep "$RID"
Esperado: duas linhas com o mesmo rid, uma do lb (com upstream= mostrando qual réplica foi escolhida) e outra do app (a réplica que atendeu). É um mini trace distribuído: o mesmo identificador costurando o caminho da requisição por duas camadas. Ferramentas reais de tracing fazem isso de forma automática e medem o tempo de cada trecho.
Exercícios
- Diagnóstico. O e-commerce abaixo caiu na Black Friday. Liste os pontos de falha e, para cada um, a peça do guia que o resolve e em que etapa ela foi estudada: - aplicação e banco no mesmo servidor; - carrinho em variável de sessão; - imagens e JavaScript servidos pela própria aplicação; - e-mail de confirmação enviado antes de responder ao cliente; - um único servidor na frente de tudo. *Resposta esperada:* aplicação e banco no mesmo servidor: separar os dois, com a aplicação em instâncias próprias e o banco em serviço gerenciado com read replicas (Etapas 01, 03 e 05); carrinho em variável de sessão: aplicação stateless, com o estado no Redis ou no banco (Etapa 03); imagens e JavaScript servidos pela aplicação: CDN na frente (Etapa 04); e-mail antes de responder: fila e workers, com o produtor respondendo na hora (Etapa 03); servidor único na frente: load balancer com uma frota de instâncias (Etapas 01 e 02).
- Monolito ou microsserviços? Uma startup com 6 pessoas, um único time, quer "ser como o Nubank". Use a Lei de Conway e a tabela de custos para argumentar a favor de um monolito escalável (stateless, em ASG) como ponto de partida. *Resposta esperada:* pela Lei de Conway, um time único e centralizado tende a produzir (e a operar bem) um monolito; microsserviços refletem times pequenos e autônomos, que a startup ainda não tem. A tabela mostra o preço dos microsserviços: complexidade operacional massiva, latência e novos pontos de falha na rede, depuração distribuída difícil. Um monolito stateless em ASG escala horizontalmente com simplicidade de desenvolvimento, teste, deploy e depuração, e pode ser dividido mais tarde, quando surgirem times e gargalos que justifiquem.
- Gargalo ou pilar? Você vê a latência do
/carrinhotriplicar. Qual pilar você consulta primeiro para saber *que* algo mudou, qual para saber *por quê* e qual para saber *onde* o tempo foi gasto? *Resposta esperada:* métricas para saber que algo mudou (e disparar o alerta), logs para saber por quê e traces para saber onde o tempo foi gasto, ao longo dos serviços por onde a requisição passou. - Orçamento de erro (conta). Um SLO de 99,9% de disponibilidade em 30 dias deixa quantos minutos de indisponibilidade de orçamento? (Dica: 30 dias têm 43.200 minutos.) *Resposta esperada:* 0,1% de 43.200 = 43,2 minutos.
- Plano de upgrade. Escreva o que você adicionaria ao
docker-compose.ymlpara incluir o banco primary e a réplica da Etapa 05 atrás da API, e como a aplicação faria o write splitting. *Resposta esperada:* acrescentar ao compose os serviçosprimaryereplica(com oinit-primary.sh, oreplica.she o healthcheck da Etapa 05) e passar àappos endereços dos dois por variáveis de ambiente. No write splitting, os comandos de escrita (INSERT, UPDATE, DELETE) vão para oprimarye as leituras (SELECT) para areplica, de preferência com o cache-aside do Redis na frente. A aplicação de teste não fala com Postgres, então seria preciso acrescentar a ela um cliente de Postgres.
Limpeza:
docker compose down -vdocker rm -f monolito 2>/dev/nullcd ..
Dica: Gere o ID de requisição na primeira camada que recebe o tráfego e repasse-o em todas as chamadas seguintes, registrando-o em todo log. Sem esse fio comum, logs de camadas diferentes são pilhas separadas que você precisa casar pelo horário, o que não funciona sob carga.
Anota aí: Arquitetura escalável é a combinação certa de peças simples (borda, balanceador, aplicação stateless, fila, banco com réplicas), e só se mantém assim se você enxergar o sistema por métricas, logs e traces.
Etapa 07 · revisão
Checklist de autoavaliação
Etapa 01: Fundamentos
- Explico a diferença entre desempenho, otimização e escalabilidade com um exemplo.
- Sei dizer por que escalar não reduz a latência de uma requisição isolada.
- Comparo escala vertical e horizontal, incluindo o conceito de SPOF.
- Diferencio autoscaling baseado em métrica, agendado e preditivo.
- Reconheço quando NÃO escalar.
Etapa 02: Load balancers
- Diferencio L4 e L7 e dou um uso de cada.
- Explico round-robin, least connections e IP hash, com uma desvantagem de cada.
- Descrevo health check, failover e connection draining.
- Executo e explico um canary e uma virada blue/green, com rollback.
- Configuro um
upstreamno Nginx, valido comnginx -te recarrego a configuração.
Etapa 03: Padrões de escala horizontal
- Explico por que stateful atrapalha o balanceamento e como o Redis resolve.
- Reproduzo o problema do carrinho em memória e a correção.
- Explico por que sticky session é um remendo e não uma solução.
- Explico o padrão produtor, fila e worker, e por que os workers escalam pelo tamanho da fila.
- Escrevo um retry com backoff exponencial e explico o papel do fallback e do circuit breaker.
- Sei o que são sidecar, ambassador, ReplicaSet e ASG.
Etapa 04: CDNs
- Explico como o DNS inteligente aproxima o usuário de um PoP.
- Leio
Cache-ControleETagcomcurle provoco um304. - Diferencio HIT, MISS, EXPIRED e REVALIDATED.
- Calculo o cache hit ratio e sei por que invalidar demais é ruim.
- Decido o que cachear, por quanto tempo, e o que nunca vai para uma borda compartilhada.
Etapa 05: Banco de dados
- Explico cache-aside e implemento o fluxo com Redis, incluindo a invalidação ao escrever.
- Explico primary-replica, replicação assíncrona e write splitting.
- Demonstro consistência eventual com uma réplica.
- Comparo sharding por range e por hash e explico a dor do re-sharding.
- Explico o teorema CAP, RPO e RTO com um exemplo.
Etapa 06: Arquiteturas no mundo real
- Diagnostico os pontos de falha de um monolito e redesenho a arquitetura justificando cada peça.
- Comparo monolito escalável e microsserviços e cito a Lei de Conway.
- Associo métricas, logs e traces às perguntas "o quê", "por quê" e "onde".
- Rodo e interpreto a verificação da arquitetura completa e sigo um ID de requisição pelos logs.
- Explico SLO e error budget e calculo o orçamento de um SLO.
Notas do professor: precisões técnicas
- Precisões e correções ao material bruto:
- Teorema CAP. O material diz que o sistema "garante só duas de três" propriedades. A leitura mais precisa é que, durante uma partição de rede, é preciso escolher entre consistência e disponibilidade; sem partição, um sistema pode oferecer as duas. Por isso a frase "a escolha real é CP ou AP" do próprio material é a que vale, e o texto da Etapa 05 foi escrito nesse sentido. Classificar bancos como "CP" ou "AP" também é uma simplificação: muitos permitem ajustar o comportamento por configuração.
- Hystrix. O material cita a biblioteca Hystrix como a que popularizou o Circuit Breaker. É um fato histórico correto, mas a biblioteca está em modo de manutenção (a própria Netflix deixou de desenvolvê-la) e o repositório do Hystrix recomenda alternativas como o Resilience4j. O padrão continua válido; a biblioteca ficou como referência histórica.
- Cabeçalho `X-Cache`. O material trata
X-Cache(Hit/Miss) como algo que a CDN simplesmente envia. Esse cabeçalho não faz parte de um padrão HTTP: é uma convenção de cada provedor, e o formato do valor varia entre eles. O que é padronizado é oCache-Control. No laboratório, oX-Cacheé definido por nós na borda. - ReplicaSet vs Deployment. O material apresenta o ReplicaSet como unidade de escala, o que está correto. Na prática, costuma-se criar um Deployment, que gerencia ReplicaSets e acrescenta atualizações graduais e rollback. O ReplicaSet continua sendo o mecanismo que mantém o número de cópias.
- Backoff exponencial. Em sistemas reais, costuma-se somar ao backoff um pequeno atraso aleatório (jitter), para que muitos clientes não repitam as tentativas todos no mesmo instante.
- Mudanças em relação à versão anterior do guia:
- Cada etapa passou a ter as seções "Os conceitos-chave", "Comandos essenciais" e "Dica". Os YAML de leitura (Ingress e ReplicaSet) e os scripts de apoio (
cache-aside.sh,verificar.sh) viraram exemplos comentados próprios, e os exercícios foram para dentro de "Mão na massa". - Ganharam resposta esperada os exercícios que não tinham: o retry com backoff e a sticky session da Etapa 03, a leitura do ReplicaSet e a pergunta sobre sharding por range da Etapa 05.
- No exercício de sticky session (Etapa 03), o teste usa um usuário novo (
bia), porque o carrinho daanajá tem itens espalhados nas memórias das réplicas desde o passo 1, e ganhou o passo de desfazer oip_hash. - No passo 5 da Etapa 03, foi acrescentado o aviso de esperar a fila do passo 4 esvaziar antes de medir; sem isso, a medição com 1 worker soma pedidos antigos e passa dos 12 s esperados.
- Limites dos laboratórios (onde a equivalência local termina):
- A aplicação de teste modela a capacidade de um servidor com um semáforo e um
sleep. Os números da Etapa 01 são previsíveis por construção; servem para ver a lógica, não para medir hardware real. - O Nginx de código aberto faz health check passivo (reage a falhas reais). O ALB faz sondagem ativa em intervalo configurável, com *unhealthy threshold* e *healthy threshold*. O Nginx também resolve os nomes dos servidores só na partida, e por isso o
reloaddepois de mudar a frota; no ASG, o registro e a remoção de instâncias no target group são automáticos. - Os blocos
upstreamusamzone(memória compartilhada) para que os vários processos worker do Nginx dividam o mesmo estado de round-robin. Sem ela, cada worker balanceia por conta própria e contagens exatas como 10/10/10 podem sair irregulares. - Os comandos
sed -icom\nsão do GNU sed. No macOS (BSD sed), usegsed(brew install gnu-sed) ou edite os arquivos à mão. - A fila do laboratório é uma lista do Redis (
LPUSHeBRPOP). Ela não tem confirmação: se um worker morrer no meio de uma tarefa, a mensagem se perde. O SQS e o RabbitMQ mantêm a mensagem até a confirmação do consumidor, e é essa garantia que o padrão real exige. - A "CDN" local é uma única borda. Ela reproduz o mecanismo (miss, hit, revalidação com
304, TTL), mas não a distribuição geográfica, o DNS inteligente nem o WAF. O purge é simulado apagando o cache. - O Postgres do laboratório usa replicação por streaming assíncrona, e o failover é manual. Um serviço gerenciado como o RDS automatiza a detecção e a promoção; o RTO real dele depende dessa automação.
- Em Docker Compose,
deploy.replicasserve para réplicas locais. Em produção, o equivalente é o ReplicaSet/Deployment (Kubernetes) ou o ASG (AWS), com autoscaling de verdade. - Referências do material:
- Beyer et al., *The Site Reliability Workbook* (2018) e *Site Reliability Engineering* (2016).
- Kleppmann, *Designing Data-Intensive Applications* (2017).
- Newman, *Building Microservices* (2015).
- Grigorik, *High Performance Browser Networking* (2013).
- AWS: *What is an Application Load Balancer?*, *Amazon CloudFront Developer Guide*, *Amazon Aurora Features*, *AWS Well-Architected Framework*.
- Kubernetes, *Ingress*; documentação do Karpenter e do KEDA; Cloudflare, *Load Balancing* e *What is a CDN?*; Cockroach Labs, *CAP Theorem*; Netflix Technology Blog.